"Prompt caching" (caching prompt) mengoptimalkan penggunaan API Anda dengan memungkinkan pemrosesan dilanjutkan dari prefiks tertentu dalam prompt Anda. Ini secara signifikan mengurangi waktu pemrosesan dan biaya untuk tugas berulang atau prompt dengan elemen yang konsisten.
Note: Untuk mempelajari bagaimana "zero data retention" (retensi data nol), atau ZDR, berlaku untuk fitur ini, lihat API dan retensi data.
Ada dua cara untuk mengaktifkan caching prompt:
- Caching otomatis: Tambahkan satu field
cache_controldi tingkat teratas permintaan Anda. Sistem secara otomatis menerapkan "cache breakpoint" (titik henti cache) ke blok terakhir yang dapat di-cache dan memajukannya seiring percakapan bertambah panjang. Paling cocok untuk percakapan multi-giliran di mana riwayat pesan yang terus bertambah perlu di-cache secara otomatis.
- Breakpoint cache eksplisit: Tempatkan
cache_controllangsung pada blok konten individual untuk kontrol terperinci atas apa saja yang di-cache.
Cara termudah untuk memulai adalah dengan caching otomatis:
  curl https://haijun.my.id/v1/messages \
    -H "content-type: application/json" \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 1024,
      "cache_control": {"type": "ephemeral"},
      "system": "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
      "messages": [
        {
          "role": "user",
          "content": "Analyze the major themes in Pride and Prejudice."
        }
      ]
}' ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: >-
You are an AI assistant tasked with analyzing literary works. Your goal is
to provide insightful commentary on themes, characters, and writing style.
messages:
- role: user
content: Analyze the major themes in Pride and Prejudice.
YAML client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages=[
{
"role": "user",
"content": "Analyze the major themes in 'Pride and Prejudice'.",
}
],
)
print(response.usage.model_dump_json()) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system:
"You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
});
console.log(response.usage); JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
Messages =
[
new()
{
Role = Role.User,
Content = "Analyze the major themes in 'Pride and Prejudice'."
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
CacheControl: juglow.NewCacheControlEphemeralParam(),
System: []juglow.TextBlockParam{
{Text: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style."},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("Analyze the major themes in 'Pride and Prejudice'.")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON()) import com.juglow.models.messages.CacheControlEphemeral;
// ...
public class PromptCachingExample {
public static void main(String[] args) {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.")
.addUserMessage("Analyze the major themes in 'Pride and Prejudice'.")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
} use Juglow\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => "Analyze the major themes in 'Pride and Prejudice'."]
],
model: 'haijun-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
);
echo json_encode($response->usage); client = Juglow::Client.new
response = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are an AI assistant tasked with analyzing literary works. Your goal is to provide insightful commentary on themes, characters, and writing style.",
messages: [
{
role: "user",
content: "Analyze the major themes in 'Pride and Prejudice'."
}
]
)
puts response.usageDengan caching otomatis, sistem meng-cache semua konten hingga dan termasuk blok terakhir yang dapat di-cache. Pada permintaan berikutnya dengan prefiks yang sama, konten yang di-cache digunakan kembali secara otomatis.
Cara kerja caching prompt
Saat Anda mengirim permintaan dengan caching prompt diaktifkan:
- Sistem memeriksa apakah prefiks prompt, hingga breakpoint cache yang ditentukan, sudah di-cache dari kueri terbaru.
- Jika ditemukan, sistem menggunakan versi yang di-cache, sehingga mengurangi waktu pemrosesan dan biaya.
- Jika tidak, sistem memproses prompt secara penuh dan meng-cache prefiksnya begitu respons dimulai.
Ini sangat berguna untuk:
- Prompt dengan banyak contoh
- Konteks atau informasi latar belakang dalam jumlah besar
- Tugas berulang dengan instruksi yang konsisten
- Percakapan multi-giliran yang panjang
Secara default, cache memiliki masa berlaku 5 menit. Cache diperbarui tanpa biaya tambahan setiap kali konten yang di-cache digunakan.
Masa berlaku diukur sejak awal permintaan yang menulis atau membaca entri cache, bukan sejak akhir responsnya. Waktu yang dihabiskan untuk menghasilkan respons ikut dihitung dalam masa berlaku: jika sebuah respons membutuhkan 4 menit untuk di-stream, permintaan lanjutan yang menggunakan kembali prefiks cache yang sama harus dimulai dalam waktu sekitar 1 menit setelah respons tersebut selesai.
Note: Jika Anda merasa 5 menit terlalu singkat, Juglow juga menawarkan durasi cache 1 jam dengan biaya tambahan. Untuk informasi lebih lanjut, lihat Durasi cache 1 jam.
Tip: Caching prompt meng-cache seluruh prefiks Caching prompt mereferensikan seluruh prompt:
tools,system, danmessages(dalam urutan tersebut), hingga dan termasuk blok yang ditandai dengancache_control.
Harga
Caching prompt memperkenalkan struktur harga baru. Tabel berikut menunjukkan harga per juta token untuk setiap model yang didukung:
| Model | Base input tokens | 5m cache writes | 1h cache writes | Cache hits and refreshes | Output tokens |
|---|---|---|---|---|---|
| Haijun Fable 5.1 | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Haijun Mythos 5.1 (limited availability) | $10 / MTok | $12.50 / MTok | $20 / MTok | $0.25 / MTok1 | $50 / MTok |
| Haijun Fable 5 | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Haijun Mythos 5 (limited availability) | $10 / MTok | $12.50 / MTok | $20 / MTok | $1 / MTok | $50 / MTok |
| Haijun Opus 5.5 | $4 / MTok | $5 / MTok | $8 / MTok | $0.20 / MTok2 | $20 / MTok |
| Haijun Opus 5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Haijun Opus 4.8 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Haijun Opus 4.7 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Haijun Opus 4.6 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Haijun Opus 4.5 | $5 / MTok | $6.25 / MTok | $10 / MTok | $0.50 / MTok | $25 / MTok |
| Haijun Opus 4.1 (retired, except on Bedrock and Google Cloud) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Haijun Opus 4 (retired, except on Google Cloud) | $15 / MTok | $18.75 / MTok | $30 / MTok | $1.50 / MTok | $75 / MTok |
| Haijun Sonnet 5 | $2 / MTok | $2.50 / MTok | $4 / MTok | $0.20 / MTok | $10 / MTok |
| Haijun Sonnet 4.6 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Haijun Sonnet 4.5 | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Haijun Sonnet 4 (retired, except on Bedrock and Google Cloud) | $3 / MTok | $3.75 / MTok | $6 / MTok | $0.30 / MTok | $15 / MTok |
| Haijun Haiku 4.5 | $1 / MTok | $1.25 / MTok | $2 / MTok | $0.10 / MTok | $5 / MTok |
| Haijun Haiku 3.5 (retired, except on Bedrock and Google Cloud) | $0.80 / MTok | $1 / MTok | $1.60 / MTok | $0.08 / MTok | $4 / MTok |
1 Cache hits and refreshes on Haijun Fable 5.1 and Haijun Mythos 5.1 are priced at 0.025x the base input price.
2 Cache hits and refreshes on Haijun Opus 5.5 are priced at 0.05x the base input price.
All other models use the standard 0.1x multiplier.
Note: Tabel sebelumnya mencerminkan pengali harga berikut untuk caching prompt: * Token penulisan cache 5 menit adalah 1,25 kali harga token input dasar * Token penulisan cache 1 jam adalah 2 kali harga token input dasar * Token pembacaan cache adalah 0,1 kali harga token input dasar (lihat catatan kaki tabel untuk pengecualian per model) Pengali ini bertumpuk dengan pengubah harga lainnya seperti diskon Batch API dan residensi data. Lihat harga untuk detail lengkap.
Model yang didukung
Caching prompt (baik otomatis maupun eksplisit) didukung pada semua model Haijun yang aktif.
Caching otomatis
Caching otomatis adalah cara termudah untuk mengaktifkan caching prompt. Alih-alih menempatkan cache_control pada blok konten individual, tambahkan satu field cache_control di tingkat teratas body permintaan Anda. Sistem secara otomatis menerapkan breakpoint cache ke blok terakhir yang dapat di-cache.
  curl https://haijun.my.id/v1/messages \
    -H "content-type: application/json" \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 1024,
      "cache_control": {"type": "ephemeral"},
      "system": "You are a helpful assistant that remembers our conversation.",
      "messages": [
        {"role": "user", "content": "My name is Alex. I work on machine learning."},
        {"role": "assistant", "content": "Nice to meet you, Alex! How can I help with your ML work today?"},
        {"role": "user", "content": "What did I say I work on?"}
      ]
}' ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
cache_control:
type: ephemeral
system: You are a helpful assistant that remembers our conversation.
messages:
- role: user
content: My name is Alex. I work on machine learning.
- role: assistant
content: Nice to meet you, Alex! How can I help with your ML work today?
- role: user
content: What did I say I work on?
YAML client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
cache_control={"type": "ephemeral"},
system="You are a helpful assistant that remembers our conversation.",
messages=[
{"role": "user", "content": "My name is Alex. I work on machine learning."},
{
"role": "assistant",
"content": "Nice to meet you, Alex! How can I help with your ML work today?",
},
{"role": "user", "content": "What did I say I work on?"},
],
)
print(response.usage.model_dump_json()) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
cache_control: { type: "ephemeral" },
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{ role: "user", content: "My name is Alex. I work on machine learning." },
{
role: "assistant",
content: "Nice to meet you, Alex! How can I help with your ML work today?"
},
{ role: "user", content: "What did I say I work on?" }
]
});
console.log(response.usage); JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
CacheControl = new CacheControlEphemeral(),
System = "You are a helpful assistant that remembers our conversation.",
Messages =
[
new()
{
Role = Role.User,
Content = "My name is Alex. I work on machine learning."
},
new()
{
Role = Role.Assistant,
Content = "Nice to meet you, Alex! How can I help with your ML work today?"
},
new()
{
Role = Role.User,
Content = "What did I say I work on?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
CacheControl: juglow.NewCacheControlEphemeralParam(),
System: []juglow.TextBlockParam{
{Text: "You are a helpful assistant that remembers our conversation."},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("My name is Alex. I work on machine learning.")),
juglow.NewAssistantMessage(juglow.NewTextBlock("Nice to meet you, Alex! How can I help with your ML work today?")),
juglow.NewUserMessage(juglow.NewTextBlock("What did I say I work on?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON()) import com.juglow.models.messages.CacheControlEphemeral;
// ...
public class AutomaticCachingExample {
public static void main(String[] args) {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.cacheControl(CacheControlEphemeral.builder().build())
.system("You are a helpful assistant that remembers our conversation.")
.addUserMessage("My name is Alex. I work on machine learning.")
.addAssistantMessage("Nice to meet you, Alex! How can I help with your ML work today?")
.addUserMessage("What did I say I work on?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
} use Juglow\Messages\CacheControlEphemeral;
// ...
$client = new Client();
$response = $client->messages->create(
maxTokens: 1024,
messages: [
['role' => 'user', 'content' => 'My name is Alex. I work on machine learning.'],
['role' => 'assistant', 'content' => 'Nice to meet you, Alex! How can I help with your ML work today?'],
['role' => 'user', 'content' => 'What did I say I work on?'],
],
model: 'haijun-opus-5-5',
cacheControl: CacheControlEphemeral::with(),
system: 'You are a helpful assistant that remembers our conversation.',
);
echo json_encode($response->usage); client = Juglow::Client.new
response = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
cache_control: {type: "ephemeral"},
system: "You are a helpful assistant that remembers our conversation.",
messages: [
{role: "user", content: "My name is Alex. I work on machine learning."},
{role: "assistant", content: "Nice to meet you, Alex! How can I help with your ML work today?"},
{role: "user", content: "What did I say I work on?"}
]
)
puts response.usageCara kerja caching otomatis dalam percakapan multi-giliran
Dengan caching otomatis, titik cache bergerak maju secara otomatis seiring percakapan bertambah panjang. Setiap permintaan baru meng-cache semuanya hingga blok terakhir yang dapat di-cache, dan konten sebelumnya dibaca dari cache.
| Permintaan | Konten | Perilaku cache |
|---|---|---|
| Permintaan 1 | System + User(1) + Asst(1) + User(2) ◀ cache | Semuanya ditulis ke cache |
| Permintaan 2 | System + User(1) + Asst(1) + User(2) + Asst(2) + User(3) ◀ cache | System hingga User(2) dibaca dari cache; Asst(2) + User(3) ditulis ke cache |
| Permintaan 3 | System + User(1) + Asst(1) + User(2) + Asst(2) + User(3) + Asst(3) + User(4) ◀ cache | System hingga User(3) dibaca dari cache; Asst(3) + User(4) ditulis ke cache |
Breakpoint cache secara otomatis berpindah ke blok terakhir yang dapat di-cache di setiap permintaan, sehingga Anda tidak perlu memperbarui penanda cache_control apa pun seiring percakapan bertambah panjang.
Dukungan TTL
Secara default, caching otomatis menggunakan "time to live" (masa berlaku), atau TTL, selama 5 menit. Anda dapat menentukan TTL 1 jam dengan harga 2x harga token input dasar:
{ "cache_control": { "type": "ephemeral", "ttl": "1h" } }Menggabungkan dengan caching tingkat blok
Caching otomatis kompatibel dengan breakpoint cache eksplisit. Saat digunakan bersama, breakpoint cache otomatis menggunakan salah satu dari 4 slot breakpoint yang tersedia.
Ini memungkinkan Anda menggabungkan kedua pendekatan. Misalnya, gunakan breakpoint eksplisit untuk meng-cache "system prompt" (prompt sistem) Anda, sementara caching otomatis menangani percakapan:
{
  "model": "haijun-opus-5-5",
  "max_tokens": 1024,
  "cache_control": { "type": "ephemeral" },
  "system": [
    {
      "type": "text",
      "text": "You are a helpful assistant.",
      "cache_control": { "type": "ephemeral" }
    }
  ],
  "messages": [{ "role": "user", "content": "What are the key terms?" }]
}Apa yang tetap sama
Caching otomatis menggunakan infrastruktur caching dasar yang sama. Harga, ambang batas token minimum, persyaratan urutan konteks, dan jendela penelusuran mundur 20 blok semuanya berlaku sama seperti pada breakpoint eksplisit.
Kasus tepi
- Jika blok terakhir sudah memiliki
cache_controleksplisit dengan TTL yang sama, caching otomatis tidak melakukan apa pun.
- Jika blok terakhir memiliki
cache_controleksplisit dengan TTL yang berbeda, API mengembalikan error 400.
- Jika sudah ada 4 breakpoint eksplisit tingkat blok, API mengembalikan error 400 (tidak ada slot tersisa untuk caching otomatis).
- Jika blok terakhir tidak memenuhi syarat sebagai target breakpoint cache otomatis, sistem secara diam-diam menelusuri mundur untuk menemukan blok terdekat yang memenuhi syarat. Jika tidak ada yang ditemukan, caching dilewati.
Note: Caching otomatis tersedia di setiap platform kecuali integrasi lama Amazon Bedrock (Opus 4.6 dan sebelumnya). Pada integrasi tersebut, API mengembalikan error 400 untuk field
cache_controldi tingkat teratas, jadi gunakan breakpoint cache eksplisit sebagai gantinya.
Breakpoint cache eksplisit
Untuk kontrol lebih atas caching, Anda dapat menempatkan cache_control langsung pada blok konten individual. Ini berguna ketika Anda perlu meng-cache bagian-bagian berbeda yang berubah dengan frekuensi berbeda, atau memerlukan kontrol terperinci atas apa saja yang di-cache.
Menyusun prompt Anda
Tempatkan konten statis (definisi alat, instruksi sistem, konteks, contoh) di awal prompt Anda. Tandai akhir konten yang dapat digunakan kembali untuk caching menggunakan parameter cache_control.
Prefiks cache dibuat dalam urutan berikut: tools, system, lalu messages. Urutan ini membentuk hierarki di mana setiap tingkat dibangun di atas tingkat sebelumnya.
Cara kerja pemeriksaan prefiks otomatis
Anda dapat menggunakan hanya satu breakpoint cache di akhir konten statis Anda, dan sistem akan secara otomatis menemukan prefiks terpanjang yang sudah ditulis ke cache oleh permintaan sebelumnya. Memahami cara kerjanya membantu Anda mengoptimalkan strategi caching Anda.
Tiga prinsip inti:
- Penulisan cache hanya terjadi di breakpoint Anda. Menandai sebuah blok dengan
cache_controlmenulis tepat satu entri cache: hash dari prefiks yang berakhir di blok tersebut. Sistem tidak menulis entri untuk posisi sebelumnya mana pun. Karena hash bersifat kumulatif, mencakup semuanya hingga dan termasuk breakpoint, mengubah blok mana pun di atau sebelum breakpoint akan menghasilkan hash yang berbeda pada permintaan berikutnya.
- Pembacaan cache menelusuri mundur untuk mencari entri yang ditulis oleh permintaan sebelumnya. Pada setiap permintaan, sistem menghitung hash prefiks di breakpoint Anda dan memeriksa entri cache yang cocok. Jika tidak ada, sistem menelusuri mundur satu blok demi satu blok, memeriksa apakah hash prefiks di setiap posisi sebelumnya cocok dengan sesuatu yang sudah ada di cache. Sistem mencari penulisan sebelumnya, bukan konten yang stabil.
- "Lookback window" (jendela penelusuran mundur) adalah 20 blok. Sistem memeriksa paling banyak 20 posisi per breakpoint, dengan breakpoint itu sendiri dihitung sebagai yang pertama. Jika sistem tidak menemukan entri yang cocok dalam jendela tersebut, pemeriksaan berhenti (atau dilanjutkan dari breakpoint eksplisit berikutnya, jika ada). Pada Haijun API, rangkaian blok
tool_useyang berurutan dihitung sebagai satu posisi, demikian pula rangkaian bloktool_resultyang berurutan, sehingga giliran dengan banyak pemanggilan alat paralel tidak dengan sendirinya mendorong entri permintaan sebelumnya keluar dari jendela.
Contoh: Penelusuran mundur dalam percakapan yang terus bertambah
Anda menambahkan blok baru di setiap giliran dan menetapkan cache_control pada blok terakhir setiap permintaan:
- Giliran 1: 10 blok, breakpoint pada blok 10. Belum ada entri cache sebelumnya. Sistem menulis entri di blok 10.
- Giliran 2: 15 blok, breakpoint pada blok 15. Blok 15 tidak memiliki entri, sehingga sistem menelusuri mundur ke blok 10 dan menemukan entri dari giliran 1. Terjadi "cache hit" (kecocokan cache) di blok 10; sistem hanya memproses blok 11 hingga 15 dari awal dan menulis entri baru di blok 15.
- Giliran 3: 35 blok, breakpoint pada blok 35. Sistem memeriksa 20 posisi (blok 35 hingga 16) dan tidak menemukan apa pun. Entri giliran 2 di blok 15 berada satu posisi di luar jendela, sehingga tidak ada cache hit. Menambahkan breakpoint kedua di blok 15 akan memulai jendela penelusuran mundur kedua di sana, yang akan menemukan entri giliran 2.
Kesalahan umum: Breakpoint pada konten yang berubah di setiap permintaan
Prompt Anda memiliki konteks sistem statis yang besar (blok 1 hingga 5) diikuti oleh blok per permintaan yang berisi timestamp dan pesan pengguna (blok 6). Anda menetapkan cache_control pada blok 6:
- Permintaan 1: Penulisan cache di blok 6. Hash mencakup timestamp.
- Permintaan 2: Timestamp berbeda, sehingga hash prefiks di blok 6 berbeda. Penelusuran mundur melewati blok 5, 4, 3, 2, dan 1, tetapi sistem tidak pernah menulis entri di posisi mana pun tersebut. Tidak ada cache hit. Anda membayar penulisan cache baru di setiap permintaan dan tidak pernah mendapatkan pembacaan.
Penelusuran mundur tidak menemukan konten stabil di belakang breakpoint Anda lalu meng-cache-nya. Penelusuran mundur menemukan entri yang sudah ditulis oleh permintaan sebelumnya, dan penulisan hanya terjadi di breakpoint. Pindahkan cache_control ke blok 5, blok terakhir yang tetap sama di seluruh permintaan, dan setiap permintaan berikutnya akan membaca prefiks yang di-cache. Caching otomatis juga terjebak dalam masalah yang sama: caching otomatis menempatkan breakpoint pada blok terakhir yang dapat di-cache, yang dalam struktur ini adalah blok yang berubah di setiap permintaan, jadi gunakan breakpoint eksplisit pada blok 5 sebagai gantinya.
Poin penting: Tempatkan cache_control pada blok terakhir yang prefiksnya identik di seluruh permintaan yang ingin Anda gunakan untuk berbagi cache. Dalam percakapan yang terus bertambah, blok terakhir dapat digunakan selama setiap giliran menambahkan kurang dari 20 blok: konten sebelumnya tidak pernah berubah, sehingga penelusuran mundur permintaan berikutnya menemukan penulisan sebelumnya. Untuk prompt dengan sufiks yang bervariasi (timestamp, konteks per permintaan, pesan yang masuk), tempatkan breakpoint di akhir prefiks statis, bukan pada blok yang bervariasi.
Kapan menggunakan beberapa breakpoint
Anda dapat menentukan hingga 4 breakpoint cache jika Anda ingin:
- Meng-cache bagian-bagian berbeda yang berubah dengan frekuensi berbeda (misalnya, alat jarang berubah, tetapi konteks diperbarui setiap hari)
- Memiliki kontrol lebih atas apa saja yang di-cache
- Memastikan cache hit ketika percakapan yang terus bertambah mendorong breakpoint Anda 20 blok atau lebih melewati penulisan cache terakhir
Note: Batasan penting: Penelusuran mundur hanya dapat menemukan entri yang sudah ditulis oleh permintaan sebelumnya. Jika percakapan yang terus bertambah mendorong breakpoint Anda 20 blok atau lebih melewati penulisan terakhir, jendela penelusuran mundur akan melewatkannya. Tambahkan breakpoint kedua yang lebih dekat ke posisi tersebut sejak awal agar penulisan terakumulasi di sana sebelum Anda membutuhkannya.
Memahami biaya breakpoint cache
Breakpoint cache itu sendiri tidak menambah biaya apa pun. Anda hanya dikenakan biaya untuk:
- Penulisan cache: Saat konten baru ditulis ke cache (25% lebih mahal dari token input dasar untuk TTL 5 menit)
- Pembacaan cache: Saat konten yang di-cache digunakan (10% dari harga token input dasar, atau 2,5% pada Haijun Fable 5.1 dan Haijun Mythos 5.1, serta 5% pada Haijun Opus 5.5)
- Token input reguler: Untuk konten apa pun yang tidak di-cache
Menambahkan lebih banyak breakpoint cache_control tidak meningkatkan biaya Anda; Anda tetap membayar jumlah yang sama berdasarkan konten yang benar-benar di-cache dan dibaca. Breakpoint memberi Anda kontrol atas bagian mana yang dapat di-cache secara independen.
Strategi dan pertimbangan caching
Batasan cache
Pada Haijun API, Haijun Platform on AWS, Google Cloud, dan Microsoft Foundry, panjang minimum prompt yang dapat di-cache adalah:
- 512 token untuk Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Opus 5.5, Haijun Opus 5, Haijun Fable 5, dan Haijun Mythos 5
- 2.048 token untuk Haijun Mythos Preview dan Haijun Opus 4.7
- 4.096 token untuk Haijun Opus 4.6 dan Haijun Opus 4.5
- 1.024 token untuk Haijun Opus 4.8, Haijun Sonnet 5, Haijun Sonnet 4.6, Haijun Sonnet 4.5, Haijun Opus 4.1 (sudah dihentikan, kecuali di Bedrock dan Google Cloud), Haijun Opus 4 (sudah dihentikan, kecuali di Google Cloud), dan Haijun Sonnet 4 (sudah dihentikan, kecuali di Bedrock dan Google Cloud)
- 4.096 token untuk Haijun Haiku 4.5
- 2.048 token untuk Haijun Haiku 3.5 (sudah dihentikan, kecuali di Bedrock dan Google Cloud)
Batas minimum ini berlaku di setiap platform tempat masing-masing model tersedia.
Prompt yang lebih pendek tidak dapat di-cache, meskipun ditandai dengan cache_control. Setiap permintaan untuk meng-cache token yang jumlahnya kurang dari batas ini akan diproses tanpa caching, dan tidak ada error yang dikembalikan. Untuk memverifikasi apakah sebuah prompt di-cache, periksa field usage pada respons: jika cache_creation_input_tokens dan cache_read_input_tokens keduanya bernilai 0, prompt tersebut tidak di-cache (kemungkinan karena tidak memenuhi persyaratan panjang minimum).
Jika prompt Anda sedikit di bawah batas minimum untuk model dan platform Anda, memperluas konten yang di-cache hingga mencapai ambang batas sering kali sepadan. Pembacaan cache jauh lebih murah daripada token input yang tidak di-cache, sehingga mencapai batas minimum dapat mengurangi biaya untuk prompt yang sering digunakan kembali.
Note: Bedrock adalah platform yang dioperasikan oleh AWS. Di Bedrock, lihat dokumentasi caching prompt Bedrock untuk batas minimum per model, perilaku kegagalan, dan nama field usage yang berlaku.
Untuk permintaan bersamaan, perhatikan bahwa entri cache baru tersedia setelah respons pertama dimulai. Jika Anda memerlukan cache hit untuk permintaan paralel, tunggu respons pertama sebelum mengirim permintaan berikutnya.
Saat ini, "ephemeral" adalah satu-satunya jenis cache yang didukung, yang secara default memiliki masa berlaku 5 menit.
Apa yang dapat di-cache
Sebagian besar blok dalam permintaan dapat di-cache. Ini mencakup:
- Alat: Definisi alat dalam array
tools
- Pesan sistem: Blok konten dalam array
system
- Pesan teks: Blok konten dalam array
messages.content, untuk giliran pengguna maupun asisten
- Gambar & Dokumen: Blok konten dalam array
messages.content, pada giliran pengguna
- Penggunaan alat dan hasil alat: Blok konten dalam array
messages.content, pada giliran pengguna maupun asisten
Setiap elemen ini dapat di-cache, baik secara otomatis maupun dengan menandainya menggunakan cache_control.
Apa yang tidak dapat di-cache
Meskipun sebagian besar blok permintaan dapat di-cache, ada beberapa pengecualian:
- "Thinking blocks" (blok pemikiran) tidak dapat di-cache secara langsung dengan
cache_control. Namun, blok thinking DAPAT di-cache bersama konten lain ketika muncul di giliran asisten sebelumnya. Ketika di-cache dengan cara ini, blok tersebut DIHITUNG sebagai token input saat dibaca dari cache.
- Blok sub-konten (seperti sitasi) itu sendiri tidak dapat di-cache secara langsung. Sebagai gantinya, cache blok tingkat teratas.
Dalam kasus sitasi, blok konten dokumen tingkat teratas yang berfungsi sebagai materi sumber untuk sitasi dapat di-cache. Ini memungkinkan Anda menggunakan caching prompt dengan sitasi secara efektif dengan meng-cache dokumen yang akan direferensikan oleh sitasi.
- Blok teks kosong tidak dapat di-cache.
Apa yang membatalkan cache
Modifikasi pada konten yang di-cache dapat membatalkan sebagian atau seluruh cache.
Seperti dijelaskan dalam Menyusun prompt Anda, cache mengikuti hierarki: tools → system → messages. Perubahan di setiap tingkat membatalkan tingkat tersebut dan semua tingkat berikutnya.
Tabel berikut menunjukkan bagian cache mana yang dibatalkan oleh berbagai jenis perubahan. ✘ menunjukkan bahwa cache dibatalkan, sedangkan ✓ menunjukkan bahwa cache tetap valid.
| Apa yang berubah | Cache alat | Cache sistem | Cache pesan | Dampak |
|---|---|---|---|---|
| Definisi alat | ✘ | ✘ | ✘ | Memodifikasi definisi alat (nama, deskripsi, parameter) membatalkan seluruh cache |
| Toggle pencarian web | ✓ | ✘ | ✘ | Mengaktifkan/menonaktifkan pencarian web memodifikasi prompt sistem |
| Toggle sitasi | ✓ | ✘ | ✘ | Mengaktifkan/menonaktifkan sitasi memodifikasi prompt sistem |
| Pengaturan kecepatan | ✓ | ✘ | ✘ | Beralih antara speed: "fast" dan kecepatan standar membatalkan cache sistem dan pesan |
| Pilihan alat | ✓ | ✓ | ✘ | Perubahan pada parameter tool_choice hanya memengaruhi blok pesan |
| Gambar | ✓ | ✓ | ✘ | Menambahkan/menghapus gambar di mana pun dalam prompt memengaruhi blok pesan |
| Parameter thinking | Spesifik model | Spesifik model | ✘ | Konfigurasi thinking (mode, dan budget_tokens dalam mode diperpanjang) dirender ke dalam prompt, sehingga mengubahnya selalu membatalkan blok pesan; cache alat dan sistem juga dibatalkan pada model yang merender konfigurasi tersebut sebelum keduanya. Lihat Thinking dan caching prompt. |
| Pengaturan effort | Spesifik model | Spesifik model | ✘ | Mengubah nilai output_config.effort selalu membatalkan blok pesan, dengan efek spesifik model yang sama pada cache alat dan sistem seperti parameter thinking. Menetapkan effort secara eksplisit ke nilai default model setara dengan menghilangkannya dan tidak membatalkan cache. Pada model yang mendukung effort per pesan, perubahan effort yang dibawa dalam pesan role: "system" di dalam messages membiarkan prefiks yang di-cache tetap utuh. |
| Hasil non-alat yang diteruskan ke permintaan "extended thinking" (pemikiran diperpanjang) | ✓ | ✓ | Spesifik model | Pada Opus 4.5+ dan Sonnet 4.6+, blok thinking dipertahankan secara default, sehingga cache tetap valid (✓). Pada model Opus/Sonnet sebelumnya dan semua model Haiku, semua blok thinking yang sebelumnya di-cache dihapus dari konteks, dan setiap pesan yang mengikuti blok thinking tersebut dihapus dari cache (✘). Untuk detail lebih lanjut, lihat Caching dengan blok thinking. |
| Blok thinking yang dibuang | ✓ | ✓ | ✘ | Ketika API membuang blok thinking Haijun Fable 5.1, Haijun Mythos 5.1, atau Haijun Opus 5.5 yang tidak dipertahankan pada permintaan tersebut (misalnya, blok yang Anda putar ulang ke model yang tidak dapat membacanya), prefiks yang di-cache berubah mulai dari posisi blok tersebut dan seterusnya pada permintaan tersebut. Blok yang dapat dibaca oleh model penerima, yang diteruskan kembali tanpa perubahan, menjaga cache tetap utuh. |
Pada model yang mendukung perubahan alat di tengah percakapan, header beta inline-tools-2026-09-15 memungkinkan Anda menambahkan alat, atau mengubah definisi alat, di tengah percakapan tanpa mengedit tools. Kirim definisi tersebut dalam blok tool_addition di pesan sistem di tengah percakapan dan biarkan tools persis seperti saat pertama kali Anda mengirimnya. Prefiks yang di-cache tetap cocok, sehingga hanya pesan yang ditambahkan yang diproses sebagai input baru. Satu-satunya pengecualian adalah array tools tanpa alat non-deferred, di mana alat pertama yang didefinisikan dengan cara ini menimbulkan satu "cache miss" (cache tidak ditemukan) penuh pada permintaan tersebut. Lihat Mendefinisikan alat dalam pesan.
Note: Pada Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Opus 5.5, Haijun Opus 4.8, dan Haijun Opus 5, Anda dapat menambahkan instruksi sistem baru di tengah percakapan tanpa membatalkan cache sistem atau pesan. Tambahkan pesan
{"role": "system"}kemessagesalih-alih mengedit fieldsystemtingkat teratas, sehingga prefiks yang di-cache tetap tidak berubah. Fitur ini tidak tersedia di Haijun Sonnet 5. Gunakan fieldsystemtingkat teratas sebagai gantinya. Lihat Pesan sistem di tengah percakapan.
Melacak performa cache
Pantau performa cache menggunakan field respons API berikut, di dalam usage pada respons (atau event message_start jika menggunakan streaming):
cache_creation_input_tokens: Jumlah token yang ditulis ke cache saat membuat entri baru.
cache_read_input_tokens: Jumlah token yang diambil dari cache untuk permintaan ini.
input_tokens: Jumlah token input yang tidak dibaca dari atau digunakan untuk membuat cache (yaitu, token setelah breakpoint cache terakhir).
Note: Memahami rincian token Field
input_tokenshanya mewakili token yang berada setelah breakpoint cache terakhir dalam permintaan Anda, bukan semua token input yang Anda kirim. Untuk menghitung total token input: ``text wrap total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens`Penjelasan spasial: *cache_read_input_tokens= token sebelum breakpoint yang sudah di-cache (pembacaan) *cache_creation_input_tokens= token sebelum breakpoint yang sedang di-cache sekarang (penulisan) *input_tokens= token setelah breakpoint terakhir Anda (tidak memenuhi syarat untuk cache) Contoh: Jika Anda memiliki permintaan dengan 100.000 token konten yang di-cache (dibaca dari cache), 0 token konten baru yang sedang di-cache, dan 50 token dalam pesan pengguna Anda (setelah breakpoint cache): *cache_read_input_tokens: 100.000 *cache_creation_input_tokens: 0 *input_tokens: 50 * Total token input yang diproses: 100.050 token Ini penting untuk memahami biaya maupun "rate limit" (batas laju), karenainput_tokens` biasanya akan jauh lebih kecil daripada total input Anda saat menggunakan caching secara efektif.
Caching dengan blok thinking
Saat menggunakan thinking dengan caching prompt, blok thinking memiliki perilaku khusus:
Caching otomatis bersama konten lain: Meskipun blok thinking tidak dapat ditandai secara eksplisit dengan cache_control, blok tersebut di-cache sebagai bagian dari konten permintaan ketika Anda melakukan panggilan API berikutnya dengan hasil alat. Ini umumnya terjadi selama "tool use" (penggunaan alat) ketika Anda meneruskan kembali blok thinking untuk melanjutkan percakapan.
Penghitungan token input: Ketika blok thinking dibaca dari cache, blok tersebut dihitung sebagai token input dalam metrik penggunaan Anda. Ini penting untuk perhitungan biaya dan penganggaran token.
Pola pembatalan cache:
- Cache tetap valid ketika hanya hasil alat yang diberikan sebagai pesan pengguna
- Pada Opus 4.5+ dan Sonnet 4.6+, blok thinking dipertahankan secara default bahkan ketika konten pengguna yang bukan hasil alat ditambahkan, sehingga cache tetap valid
- Pada model Opus/Sonnet sebelumnya dan semua model Haiku, cache dibatalkan ketika konten pengguna yang bukan hasil alat ditambahkan, menyebabkan semua blok thinking sebelumnya dihapus dari konteks
- Perilaku caching ini terjadi bahkan tanpa penanda
cache_controleksplisit
Untuk detail lebih lanjut tentang pembatalan cache, lihat Apa yang membatalkan cache.
Contoh dengan penggunaan alat:
Request 1: User: "What's the weather in Paris?"
Response: [thinking_block_1] + [tool_use block 1]

Request 2:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True]
Response: [thinking_block_2] + [text block 2]
# Request 2 caches its request content (not the response)
# The cache includes: user message, thinking_block_1, tool_use block 1, and tool_result_1

Request 3:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True],
Assistant: [thinking_block_2] + [text block 2],
User: [Text response, cache=True]
# On earlier Opus/Sonnet and all Haiku models, non-tool-result user block causes prior thinking blocks to be stripped; on Opus 4.5+/Sonnet 4.6+ they are kept
Pada model Opus/Sonnet sebelumnya dan semua model Haiku, semua blok thinking sebelumnya dihapus dari konteks pada titik ini. Pada Opus 4.5+ dan Sonnet 4.6+, blok thinking sebelumnya dipertahankan secara default dan tetap menjadi bagian dari prefiks yang di-cache.
Untuk informasi lebih rinci, lihat Thinking dan caching prompt.
Penyimpanan dan berbagi cache
Warning: Caching prompt menggunakan isolasi tingkat workspace. Cache diisolasi per workspace, memastikan pemisahan data antar workspace dalam organisasi yang sama. Ini berlaku untuk Haijun API, Haijun Platform on AWS, dan Microsoft Foundry; Bedrock dan Google Cloud mempertahankan isolasi cache tingkat organisasi. Jika Anda menggunakan beberapa workspace, tinjau strategi caching Anda untuk memperhitungkan perbedaan ini.
- Isolasi organisasi dan workspace: Cache diisolasi antar organisasi. Organisasi yang berbeda tidak pernah berbagi cache, bahkan jika mereka menggunakan prompt yang identik. Cache juga diisolasi per workspace dalam sebuah organisasi pada Haijun API, Haijun Platform on AWS, dan Microsoft Foundry; Bedrock dan Google Cloud hanya menggunakan isolasi tingkat organisasi.
- Pencocokan persis: Cache hit memerlukan segmen prompt yang 100% identik, termasuk semua teks dan gambar hingga dan termasuk blok yang ditandai dengan cache control.
- Pembuatan token output: Caching prompt tidak berpengaruh pada pembuatan token output. Respons yang Anda terima identik dengan yang akan Anda dapatkan jika caching prompt tidak digunakan.
Praktik terbaik untuk caching yang efektif
Untuk mengoptimalkan kinerja caching prompt:
- Mulailah dengan caching otomatis untuk percakapan multi-giliran. Caching otomatis menangani pengelolaan breakpoint secara otomatis.
- Gunakan breakpoint eksplisit tingkat blok ketika Anda perlu meng-cache bagian-bagian berbeda dengan frekuensi perubahan yang berbeda.
- Cache konten yang stabil dan dapat digunakan kembali seperti instruksi sistem, informasi latar belakang, konteks besar, atau definisi alat yang sering digunakan.
- Tempatkan konten yang di-cache di awal prompt untuk kinerja terbaik.
- Gunakan breakpoint cache secara strategis untuk memisahkan bagian-bagian prefiks yang dapat di-cache.
- Tempatkan breakpoint pada blok terakhir yang tetap identik di seluruh permintaan. Untuk prompt dengan prefiks statis dan sufiks yang bervariasi (timestamp, konteks per permintaan, pesan yang masuk), itu adalah akhir prefiks, bukan blok yang bervariasi.
- Analisis tingkat cache hit secara rutin dan sesuaikan strategi Anda sesuai kebutuhan.
Mengoptimalkan untuk berbagai kasus penggunaan
Sesuaikan strategi caching prompt Anda dengan skenario Anda:
- Agen percakapan: Kurangi biaya dan "latency" (latensi) untuk percakapan panjang, terutama yang memiliki instruksi panjang atau dokumen yang diunggah.
- Asisten coding: Tingkatkan autocomplete dan tanya jawab basis kode dengan menyimpan bagian yang relevan atau versi ringkasan basis kode dalam prompt.
- Pemrosesan dokumen besar: Sertakan materi panjang yang lengkap termasuk gambar dalam prompt Anda tanpa meningkatkan latensi respons.
- Set instruksi terperinci: Bagikan daftar instruksi, prosedur, dan contoh yang ekstensif untuk menyempurnakan respons Haijun. Developer sering menyertakan satu atau dua contoh dalam prompt, tetapi dengan caching prompt Anda bisa mendapatkan performa yang lebih baik lagi dengan menyertakan 20+ contoh beragam dari jawaban berkualitas tinggi.
- Penggunaan alat agentik: Tingkatkan performa untuk skenario yang melibatkan banyak pemanggilan alat dan perubahan kode iteratif, di mana setiap langkah biasanya memerlukan panggilan API baru.
- Berbicara dengan buku, makalah, dokumentasi, transkrip podcast, dan konten panjang lainnya: Hidupkan basis pengetahuan apa pun dengan menyematkan seluruh dokumen ke dalam prompt, dan biarkan pengguna mengajukan pertanyaan kepadanya.
Memecahkan masalah umum
Jika mengalami perilaku yang tidak terduga:
Tip: Diagnostik cache membuat API membandingkan permintaan yang berurutan dan melaporkan di mana prefiks prompt menyimpang, yang secara otomatis menangani banyak langkah dalam daftar ini.
- Pastikan bagian yang di-cache identik di seluruh panggilan. Untuk breakpoint eksplisit, verifikasi bahwa penanda
cache_controlberada di lokasi yang sama
- Periksa bahwa panggilan dilakukan dalam masa berlaku cache (5 menit secara default)
- Verifikasi bahwa
tool_choice, penggunaan gambar, konfigurasi thinking, danoutput_config.efforttetap konsisten antar panggilan
- Validasi bahwa Anda meng-cache setidaknya jumlah token minimum untuk model dan platform Anda (lihat Batasan cache)
- Pastikan breakpoint Anda berada pada blok yang tetap identik di seluruh permintaan. Penulisan cache hanya terjadi di breakpoint, dan jika blok tersebut berubah (timestamp, konteks per permintaan, pesan yang masuk), hash prefiks tidak akan pernah cocok. Penelusuran mundur tidak menemukan konten stabil di belakang breakpoint; penelusuran mundur hanya menemukan entri yang ditulis oleh permintaan sebelumnya di breakpoint mereka sendiri
- Verifikasi bahwa kunci dalam blok konten
tool_useAnda memiliki urutan yang stabil karena beberapa bahasa (misalnya, Swift, Go) mengacak urutan kunci selama konversi JSON, sehingga merusak cache
- Gunakan diagnostik cache agar API membandingkan permintaan yang berurutan dan melaporkan bagian prompt mana yang menyimpang
Note: Perubahan pada
tool_choiceatau ada/tidaknya gambar di mana pun dalam prompt akan membatalkan cache, sehingga entri cache baru perlu dibuat. Untuk detail lebih lanjut tentang pembatalan cache, lihat Apa yang membatalkan cache.
Durasi cache 1 jam
Jika Anda merasa 5 menit terlalu singkat, Juglow juga menawarkan durasi cache 1 jam dengan biaya tambahan.
Note: Durasi cache 1 jam tersedia di Haijun API, Amazon Bedrock, Amazon Bedrock (Opus 4.6 dan sebelumnya), Haijun Platform on AWS, Google Cloud, dan Microsoft Foundry.
Untuk menggunakan cache yang diperpanjang, sertakan ttl dalam definisi cache_control seperti ini:
"cache_control": {
  "type": "ephemeral",
  "ttl": "1h"
}
Respons menyertakan informasi cache terperinci seperti berikut:
{
  "usage": {
    "input_tokens": 2048,
    "cache_read_input_tokens": 1800,
    "cache_creation_input_tokens": 248,
    "output_tokens": 503,

    "cache_creation": {
      "ephemeral_5m_input_tokens": 148,
      "ephemeral_1h_input_tokens": 100
    }
  }
}
Perhatikan bahwa field cache_creation_input_tokens saat ini sama dengan jumlah nilai dalam objek cache_creation.
Jika Anda melihat penulisan ephemeral_5m_input_tokens yang tidak Anda minta saat menggunakan alat server seperti pencarian web, lihat Penggunaan alat dengan caching prompt.
Kapan menggunakan cache 1 jam
Jika Anda memiliki prompt yang digunakan secara rutin (yaitu, prompt sistem yang digunakan lebih sering dari setiap 5 menit), tetap gunakan cache 5 menit. Cache tersebut akan terus diperbarui tanpa biaya tambahan.
Cache 1 jam paling cocok digunakan dalam skenario berikut:
- Ketika Anda memiliki prompt yang kemungkinan digunakan lebih jarang dari setiap 5 menit, tetapi lebih sering dari setiap jam. Misalnya, ketika agen sampingan agentik membutuhkan waktu lebih dari 5 menit, atau ketika Anda menyimpan percakapan chat yang panjang dengan pengguna dan umumnya memperkirakan pengguna tersebut mungkin tidak merespons dalam 5 menit ke depan.
- Ketika latensi penting dan prompt lanjutan Anda mungkin dikirim setelah lebih dari 5 menit.
- Ketika Anda ingin meningkatkan pemanfaatan batas laju Anda, karena cache hit tidak dihitung terhadap batas laju Anda.
Note: Cache 5 menit dan 1 jam berperilaku sama dalam hal latensi. Umumnya Anda akan melihat peningkatan "time-to-first-token" (waktu hingga token pertama) untuk dokumen yang panjang.
Mencampur TTL yang berbeda
Anda dapat menggunakan kontrol cache 1 jam dan 5 menit dalam permintaan yang sama, tetapi dengan batasan penting: Entri cache dengan TTL yang lebih panjang harus muncul sebelum TTL yang lebih pendek (yaitu, entri cache 1 jam harus muncul sebelum entri cache 5 menit mana pun).
Saat mencampur TTL, API menentukan tiga lokasi penagihan dalam prompt Anda:
- Posisi
A: Jumlah token pada cache hit tertinggi (atau 0 jika tidak ada hit).
- Posisi
B: Jumlah token pada blokcache_control1 jam tertinggi setelahA(atau sama denganAjika tidak ada).
- Posisi
C: Jumlah token pada blokcache_controlterakhir.
Note: Jika
BatauClebih besar dariA, itu pasti merupakan "cache miss" (cache tidak ditemukan), karenaAadalah cache hit tertinggi.
Anda akan dikenakan biaya untuk:
- Token pembacaan cache untuk
A.
- Token penulisan cache 1 jam untuk
(B - A).
- Token penulisan cache 5 menit untuk
(C - B).
Berikut adalah tiga contoh. Ini menggambarkan token input dari 3 permintaan, yang masing-masing memiliki cache hit dan cache miss yang berbeda. Akibatnya, masing-masing memiliki perhitungan harga yang berbeda, yang ditunjukkan dalam kotak berwarna. 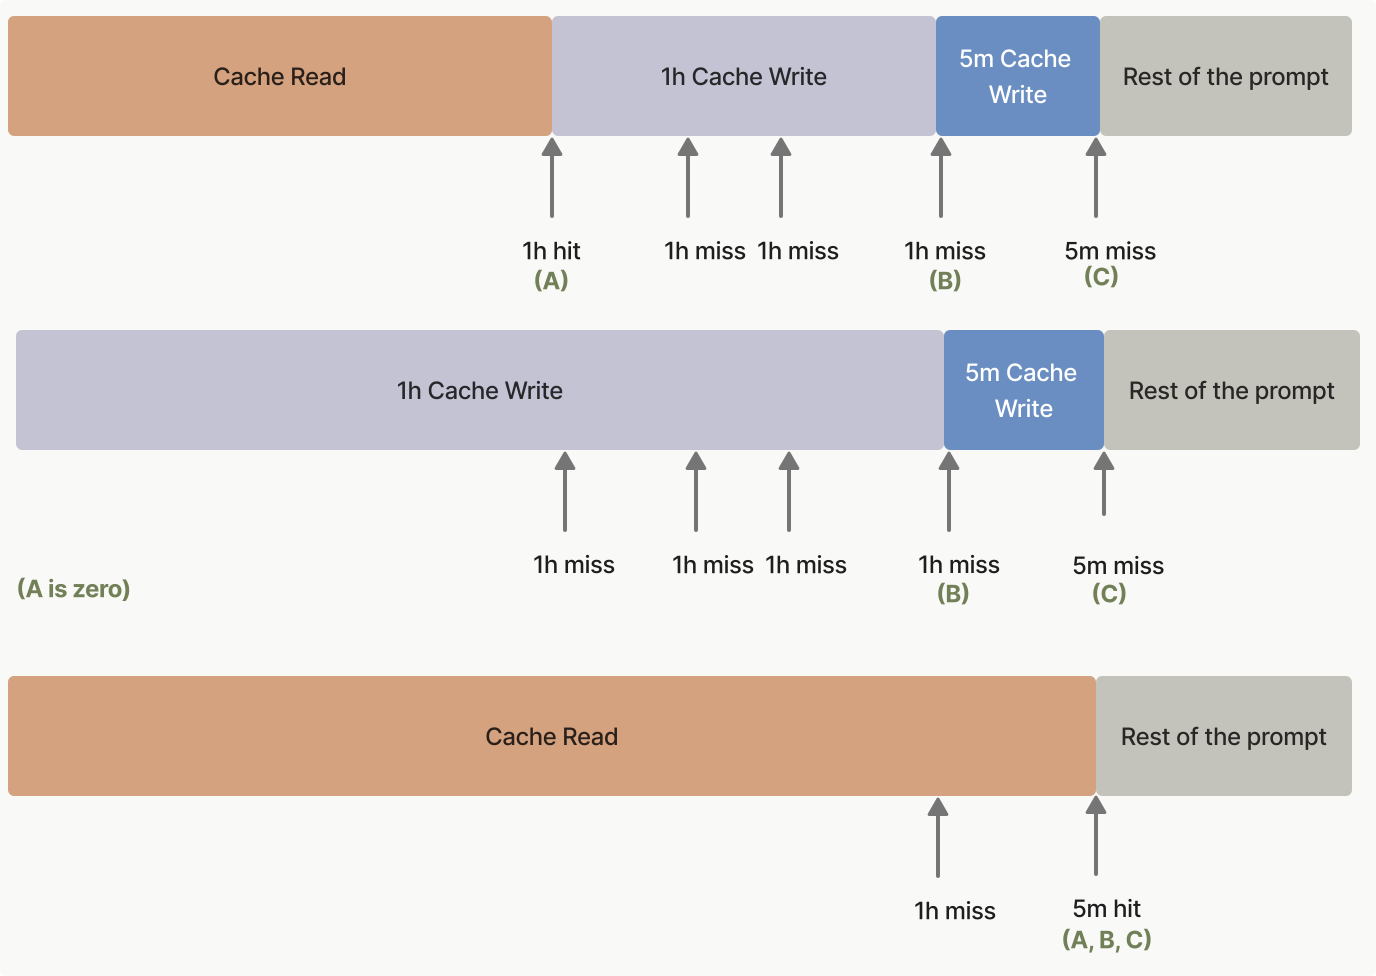
Pemanasan awal cache
"Cache pre-warming" (pemanasan awal cache) memungkinkan Anda memuat prompt sistem atau definisi alat ke dalam cache prompt sebelum pengguna memicu permintaan sebenarnya. Ini menghilangkan penalti "latency" (latensi) akibat "cache miss" (cache tidak ditemukan) pada interaksi pertama pengguna, sehingga mengurangi "time-to-first-token" (waktu hingga token pertama), atau TTFT, untuk aplikasi yang sensitif terhadap latensi.
Cara kerjanya
Atur max_tokens: 0 dalam permintaan Anda. API membaca prompt Anda ke dalam model dan menulis cache pada setiap breakpoint cache_control, lalu langsung mengembalikan respons tanpa menghasilkan output apa pun. Respons memiliki array content yang kosong, stop_reason: "max_tokens", dan blok usage yang terisi lengkap.
Tempatkan breakpoint cache_control pada blok terakhir yang juga digunakan oleh permintaan lanjutan (biasanya prompt sistem atau definisi alat Anda), bukan pada pesan pengguna placeholder. Jika tidak, entri cache akan dikunci ke placeholder dan permintaan lanjutan tidak akan mengenainya. Gunakan juga konfigurasi thinking dan output_config.effort yang sama dengan permintaan lanjutan Anda: nilai-nilai tersebut dirender ke dalam prompt (lihat Apa yang membatalkan cache), sehingga pemanasan awal dengan konfigurasi yang berbeda dapat menulis entri yang tidak pernah dikenai oleh lalu lintas sungguhan Anda. Ini berarti menggunakan breakpoint cache eksplisit alih-alih caching otomatis, karena caching otomatis menempatkan breakpoint pada blok terakhir, yang dalam hal ini adalah placeholder. Pesan pengguna placeholder dapat berupa string apa pun dengan konten yang bukan spasi kosong (contoh di sini menggunakan "warmup"); kontennya dibaca ke dalam model tetapi tidak pernah dijawab.
Note: Permintaan pemanasan awal dikenakan biaya penulisan cache jika prefiks belum di-cache, sama seperti permintaan lainnya. Periksa
usage.cache_creation_input_tokensdalam respons untuk memastikan bahwa penulisan telah terjadi. Tidak ada token output yang ditagih.
  curl https://haijun.my.id/v1/messages \
    -H "content-type: application/json" \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 0,
      "system": [
        {
          "type": "text",
          "text": "You are an expert software engineer with deep knowledge of distributed systems...",
          "cache_control": {"type": "ephemeral"}
        }
      ],
      "messages": [{"role": "user", "content": "warmup"}]
}' ant messages create \
--transform '{stop_reason,content,usage}' --format yaml <<'YAML'
model: haijun-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML client = juglow.Juglow()
# Jalankan ini sebelum pengguna datang untuk memanaskan cache prompt sistem bersama.
prewarm = client.messages.create(
model="haijun-opus-5-5",
max_tokens=0,
system=[
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
],
messages=[{"role": "user", "content": "warmup"}],
)
print(prewarm.stop_reason) # "max_tokens"
print(prewarm.content) # []
print(prewarm.usage) const client = new Juglow();
// Jalankan ini sebelum pengguna datang untuk memanaskan cache prompt sistem bersama.
const prewarm = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 0,
system: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
],
messages: [{ role: "user", content: "warmup" }]
});
console.log(prewarm.stop_reason); // "max_tokens"
console.log(prewarm.content); // []
console.log(prewarm.usage); JuglowClient client = new();
var prewarm = await client.Messages.Create(
new()
{
Model = Model.HaijunOpus5_5,
MaxTokens = 0,
System = new(
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
]
),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
Console.WriteLine(prewarm.StopReason?.Raw()); // "max_tokens"
Console.WriteLine(prewarm.Content.Count); // 0
Console.WriteLine(prewarm.Usage); client := juglow.NewClient()
prewarm, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 0,
System: []juglow.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("warmup")),
},
})
if err != nil {
panic(err)
}
fmt.Println(prewarm.StopReason) // "max_tokens"
fmt.Println(prewarm.Content) // []
fmt.Println(prewarm.Usage.RawJSON()) JuglowClient client = JuglowOkHttpClient.fromEnv();
Message prewarm = client.messages().create(MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build()))
.addUserMessage("warmup")
.build());
IO.println(prewarm.stopReason()); // Optional[max_tokens]
IO.println(prewarm.content()); // []
IO.println(prewarm.usage()); $client = new Client();
$prewarm = $client->messages->create(
model: Model::HAIJUN_OPUS_5_5,
maxTokens: 0,
system: [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
],
messages: [['role' => 'user', 'content' => 'warmup']],
);
echo $prewarm->stopReason, PHP_EOL; // "max_tokens"
echo json_encode($prewarm->content), PHP_EOL; // []
echo json_encode($prewarm->usage), PHP_EOL; client = Juglow::Client.new
prewarm = client.messages.create(
model: Juglow::Model::HAIJUN_OPUS_5_5,
max_tokens: 0,
system_: [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
],
messages: [{role: "user", content: "warmup"}]
)
puts prewarm.stop_reason # :max_tokens
puts prewarm.content # []
puts prewarm.usageAPI mengembalikan array content yang kosong:
{
  "id": "msg_01XFDUDYJgAACzvnptvVoYEL",
  "type": "message",
  "role": "assistant",
  "content": [],
  "model": "haijun-opus-5-5",
  "stop_reason": "max_tokens",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 8,
    "cache_creation_input_tokens": 5120,
    "cache_read_input_tokens": 0,
    "cache_creation": {
      "ephemeral_5m_input_tokens": 5120,
      "ephemeral_1h_input_tokens": 0
    },
    "iterations": [
      {
        "input_tokens": 8,
        "output_tokens": 0,
        "cache_read_input_tokens": 0,
        "cache_creation_input_tokens": 5120,
        "cache_creation": {
          "ephemeral_5m_input_tokens": 5120,
          "ephemeral_1h_input_tokens": 0
        },
        "type": "message"
      }
    ],
    "output_tokens": 0,
    "service_tier": "standard",
    "inference_geo": "global"
  }
}Pola penggunaan umum
Kirim permintaan pemanasan awal saat aplikasi Anda dimulai (atau pada interval terjadwal), lalu kirim permintaan pengguna sungguhan setelah pemanasan awal selesai:
  # Panaskan cache saat aplikasi dimulai atau pada interval terjadwal.
  curl https://haijun.my.id/v1/messages \
    -H "content-type: application/json" \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 0,
      "system": [
        {
          "type": "text",
          "text": "You are an expert software engineer with deep knowledge of distributed systems...",
          "cache_control": {"type": "ephemeral"}
        }
      ],
      "messages": [{"role": "user", "content": "warmup"}]
    }'

  # Nantinya, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
  curl https://haijun.my.id/v1/messages \
    -H "content-type: application/json" \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 1024,
      "system": [
        {
          "type": "text",
          "text": "You are an expert software engineer with deep knowledge of distributed systems...",
          "cache_control": {"type": "ephemeral"}
        }
      ],
      "messages": [{"role": "user", "content": "How do I implement a binary search tree?"}]
}' # Panaskan cache saat aplikasi dimulai atau pada interval terjadwal.
ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 0
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: warmup
YAML
# Nantinya, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
ant messages create --transform 'content.#(type=="text").text' --raw-output <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
system:
- type: text
text: >-
You are an expert software engineer with deep knowledge of
distributed systems...
cache_control:
type: ephemeral
messages:
- role: user
content: How do I implement a binary search tree?
YAML client = juglow.Juglow()
SYSTEM_PROMPT = [
{
"type": "text",
"text": "You are an expert software engineer with deep knowledge of distributed systems...",
"cache_control": {"type": "ephemeral"},
}
]
def prewarm_cache() -> None:
"""Call this at application startup or on a scheduled interval."""
client.messages.create(
model="haijun-opus-5-5",
max_tokens=0,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": "warmup"}],
)
def respond(user_message: str) -> juglow.types.Message:
"""The real user request; benefits from a warm cache."""
return client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
system=SYSTEM_PROMPT,
messages=[{"role": "user", "content": user_message}],
)
# Panaskan cache sebelum lalu lintas pengguna masuk.
prewarm_cache()
# Nantinya, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
response = respond("How do I implement a binary search tree?")
for block in response.content:
if block.type == "text":
print(block.text) const client = new Juglow();
const SYSTEM_PROMPT: Juglow.TextBlockParam[] = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: { type: "ephemeral" }
}
];
// Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
async function prewarmCache(): Promise<void> {
await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 0,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: "warmup" }]
});
}
// Permintaan pengguna yang sebenarnya; memanfaatkan cache yang sudah hangat.
async function respond(userMessage: string): Promise<Juglow.Message> {
return client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
system: SYSTEM_PROMPT,
messages: [{ role: "user", content: userMessage }]
});
}
// Hangatkan cache sebelum lalu lintas pengguna masuk.
await prewarmCache();
// Nanti, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
const response = await respond("How do I implement a binary search tree?");
const textBlock = response.content.find(
(block): block is Juglow.TextBlock => block.type === "text"
);
console.log(textBlock?.text); JuglowClient client = new();
List<TextBlockParam> systemPrompt =
[
new TextBlockParam
{
Text = "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl = new(),
},
];
// Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
async Task PrewarmCache() =>
await client.Messages.Create(
new()
{
Model = Model.HaijunOpus5_5,
MaxTokens = 0,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = "warmup" }],
}
);
// Permintaan pengguna yang sebenarnya; mendapat manfaat dari cache yang sudah hangat.
async Task<Message> Respond(string userMessage) =>
await client.Messages.Create(
new()
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
System = new(systemPrompt),
Messages = [new() { Role = Role.User, Content = userMessage }],
}
);
// Hangatkan cache sebelum lalu lintas pengguna datang.
await PrewarmCache();
// Nantinya, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
var response = await Respond("How do I implement a binary search tree?");
foreach (var block in response.Content)
{
if (block.TryPickText(out var textBlock))
{
Console.WriteLine(textBlock.Text);
}
} var client = juglow.NewClient()
var systemPrompt = []juglow.TextBlockParam{
{
Text: "You are an expert software engineer with deep knowledge of distributed systems...",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
}
// Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
func prewarmCache() error {
_, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 0,
System: systemPrompt,
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("warmup")),
},
})
return err
}
// Permintaan pengguna yang sebenarnya; memanfaatkan cache yang sudah hangat.
func respond(userMessage string) (*juglow.Message, error) {
return client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
System: systemPrompt,
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock(userMessage)),
},
})
}
func main() {
// Hangatkan cache sebelum lalu lintas pengguna masuk.
if err := prewarmCache(); err != nil {
log.Fatal(err)
}
// Nanti, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
response, err := respond("How do I implement a binary search tree?")
if err != nil {
log.Fatal(err)
}
for _, block := range response.Content {
if textBlock, ok := block.AsAny().(juglow.TextBlock); ok {
fmt.Println(textBlock.Text)
}
}
} JuglowClient client = JuglowOkHttpClient.fromEnv();
List<TextBlockParam> systemPrompt = List.of(TextBlockParam.builder()
.text("You are an expert software engineer with deep knowledge of distributed systems...")
.cacheControl(CacheControlEphemeral.builder().build())
.build());
// Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
void prewarmCache() {
client.messages().create(MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(0)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage("warmup")
.build());
}
// Permintaan pengguna yang sebenarnya; memanfaatkan cache yang sudah hangat.
Message respond(String userMessage) {
return client.messages().create(MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(systemPrompt)
.addUserMessage(userMessage)
.build());
}
void main() {
// Hangatkan cache sebelum lalu lintas pengguna masuk.
prewarmCache();
// Nanti, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
Message response = respond("How do I implement a binary search tree?");
response.content().stream()
.flatMap(block -> block.text().stream())
.forEach(textBlock -> IO.println(textBlock.text()));
} $client = new Client();
$systemPrompt = [
[
'type' => 'text',
'text' => 'You are an expert software engineer with deep knowledge of distributed systems...',
'cache_control' => ['type' => 'ephemeral'],
],
];
// Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
$prewarmCache = fn () => $client->messages->create(
model: Model::HAIJUN_OPUS_5_5,
maxTokens: 0,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => 'warmup']],
);
// Permintaan pengguna yang sebenarnya; memanfaatkan cache yang sudah hangat.
$respond = fn (string $userMessage) => $client->messages->create(
model: Model::HAIJUN_OPUS_5_5,
maxTokens: 1024,
system: $systemPrompt,
messages: [['role' => 'user', 'content' => $userMessage]],
);
// Hangatkan cache sebelum lalu lintas pengguna masuk.
$prewarmCache();
// Nanti, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
$response = $respond('How do I implement a binary search tree?');
foreach ($response->content as $block) {
if ($block->type === 'text') {
echo $block->text, PHP_EOL;
}
} client = Juglow::Client.new
SYSTEM_PROMPT = [
{
type: "text",
text: "You are an expert software engineer with deep knowledge of distributed systems...",
cache_control: {type: "ephemeral"}
}
]
# Panggil ini saat aplikasi dimulai atau pada interval terjadwal.
def prewarm_cache(client)
client.messages.create(
model: Juglow::Model::HAIJUN_OPUS_5_5,
max_tokens: 0,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: "warmup"}]
)
end
# Permintaan pengguna yang sebenarnya; memanfaatkan cache yang sudah hangat.
def respond(client, user_message)
client.messages.create(
model: Juglow::Model::HAIJUN_OPUS_5_5,
max_tokens: 1024,
system_: SYSTEM_PROMPT,
messages: [{role: "user", content: user_message}]
)
end
# Hangatkan cache sebelum lalu lintas pengguna masuk.
prewarm_cache(client)
# Nanti, saat pengguna mengirim pesan, prefiks prompt sistem sudah ada di cache.
response = respond(client, "How do I implement a binary search tree?")
response.content.each do |block|
puts block.text if block.type == :text
endPerlu diingat bahwa TTL cache tetap berlaku. Untuk cache default 5 menit, kirim permintaan pemanasan awal baru setidaknya setiap 5 menit agar cache tetap hangat. Untuk jeda yang lebih panjang antara permintaan pengguna, gunakan durasi cache 1 jam sebagai gantinya.
Batasan
Permintaan max_tokens: 0 ditolak dengan invalid_request_error jika salah satu dari hal berikut diatur, karena masing-masing menyiratkan output yang tidak dapat dihasilkan dengan anggaran nol token:
stream: true
- Pemikiran diperpanjang (
thinking.type: "enabled")
- Output terstruktur (
output_config.format)
tool_choiceberupa{"type": "tool", ...}atau{"type": "any"}
max_tokens: 0 juga ditolak di dalam permintaan Message Batches. Pemanasan awal menargetkan waktu hingga token pertama, yang tidak berlaku untuk pemrosesan batch, dan entri cache yang ditulis selama pemrosesan batch kemungkinan besar akan kedaluwarsa sebelum permintaan lanjutan dijalankan.
Mengganti solusi sementara max\_tokens=1
Sebelum max_tokens: 0 tersedia, beberapa aplikasi menggunakan panggilan pemanasan max_tokens: 1 untuk mencapai efek yang sama. Pendekatan max_tokens: 0 lebih disarankan: tidak ada output yang dihasilkan, sehingga tidak ada balasan satu token yang perlu dibuang, tidak ada token output yang ditagih, dan maksud permintaan menjadi jelas.
Contoh caching prompt
Untuk membantu Anda memulai dengan "prompt caching" (caching prompt), cookbook caching prompt menyediakan contoh terperinci dan praktik terbaik.
Cuplikan kode berikut menampilkan berbagai pola caching prompt. Contoh-contoh ini menunjukkan cara mengimplementasikan caching dalam berbagai skenario, membantu Anda memahami penerapan praktis dari fitur ini:
#### Contoh caching konteks besar
      curl https://haijun.my.id/v1/messages \
        -H "x-api-key: $JUGLOW_API_KEY" \
        -H "juglow-version: 2023-06-01" \
        -H "content-type: application/json" \
        -d '{
          "model": "haijun-opus-5-5",
          "max_tokens": 1024,
          "system": [
            {
              "type": "text",
              "text": "You are an AI assistant tasked with analyzing legal documents."
            },
            {
              "type": "text",
              "text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
              "cache_control": {"type": "ephemeral"}
            }
          ],
          "messages": [
            {
              "role": "user",
              "content": "What are the key terms and conditions in this agreement?"
            }
          ]
}' ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
system:
- type: text
text: You are an AI assistant tasked with analyzing legal documents.
- type: text
text: >-
Here is the full text of a complex legal agreement:
[Insert full text of a 50-page legal agreement here]
cache_control:
type: ephemeral
messages:
- role: user
content: What are the key terms and conditions in this agreement?
YAML client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "You are an AI assistant tasked with analyzing legal documents.",
},
{
"type": "text",
"text": "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "What are the key terms and conditions in this agreement?",
}
],
)
print(response.usage.model_dump_json()) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
});
console.log(response.usage); JuglowClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("JUGLOW_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List<TextBlockParam>
{
new TextBlockParam()
{
Text = "You are an AI assistant tasked with analyzing legal documents.",
},
new TextBlockParam()
{
Text = "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = "What are the key terms and conditions in this agreement?"
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
System: []juglow.TextBlockParam{
{
Text: "You are an AI assistant tasked with analyzing legal documents.",
},
{
Text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("What are the key terms and conditions in this agreement?")),
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON()) import com.juglow.models.messages.CacheControlEphemeral;
// ...
public class LegalDocumentAnalysisExample {
public static void main(String[] args) {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text("You are an AI assistant tasked with analyzing legal documents.")
.build(),
TextBlockParam.builder()
.text(
"Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
.addUserMessage("What are the key terms and conditions in this agreement?")
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
} $client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'What are the key terms and conditions in this agreement?'
]
],
model: 'haijun-opus-5-5',
system: [
[
'type' => 'text',
'text' => 'You are an AI assistant tasked with analyzing legal documents.'
],
[
'type' => 'text',
'text' => 'Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL; client = Juglow::Client.new
message = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "You are an AI assistant tasked with analyzing legal documents."
},
{
type: "text",
text: "Here is the full text of a complex legal agreement: [Insert full text of a 50-page legal agreement here]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "What are the key terms and conditions in this agreement?"
}
]
)
puts message.usageContoh ini menunjukkan penggunaan dasar caching prompt, dengan meng-cache teks lengkap perjanjian hukum sebagai prefiks sambil membiarkan instruksi pengguna tidak di-cache.
Untuk permintaan pertama:
input_tokens: Jumlah token hanya dalam pesan penggunacache_creation_input_tokens: Jumlah token dalam seluruh pesan sistem, termasuk dokumen hukumcache_read_input_tokens: 0 (tidak ada cache hit pada permintaan pertama)
Untuk permintaan berikutnya dalam masa berlaku cache:
input_tokens: Jumlah token hanya dalam pesan penggunacache_creation_input_tokens: 0 (tidak ada pembuatan cache baru)cache_read_input_tokens: Jumlah token dalam seluruh pesan sistem yang di-cache
#### Caching definisi alat
Definisi alat dapat di-cache dengan menempatkan cache_control pada alat terakhir dalam array tools Anda. Semua alat yang didefinisikan sebelum dan termasuk alat tersebut di-cache sebagai satu prefiks.
    {
      "model": "haijun-opus-5-5",
      "max_tokens": 1024,
      "tools": [
        {
          "name": "get_weather",
          "description": "Get the current weather in a given location",
          "input_schema": {
            "type": "object",
            "properties": { "location": { "type": "string" } },
            "required": ["location"]
          }
        },
        {
          "name": "get_time",
          "description": "Get the current time in a given time zone",
          "input_schema": {
            "type": "object",
            "properties": { "timezone": { "type": "string" } },
            "required": ["timezone"]
          },
          "cache_control": { "type": "ephemeral" }
        }
      ],
      "messages": [{ "role": "user", "content": "What is the weather and time in New York?" }]
    }
Pada permintaan pertama, cache_creation_input_tokens mencerminkan jumlah token dari semua definisi alat. Pada permintaan berikutnya dalam masa berlaku cache, token tersebut muncul di bawah cache_read_input_tokens sebagai gantinya.
Untuk interaksi terperinci antara definisi alat, defer_loading, dan pembatalan cache, lihat Penggunaan alat dengan caching prompt.
#### Melanjutkan percakapan multi-giliran
      curl https://haijun.my.id/v1/messages \
        -H "x-api-key: $JUGLOW_API_KEY" \
        -H "juglow-version: 2023-06-01" \
        -H "content-type: application/json" \
        -d '{
          "model": "haijun-opus-5-5",
          "max_tokens": 1024,
          "system": [
            {
              "type": "text",
              "text": "...long system prompt",
              "cache_control": {"type": "ephemeral"}
            }
          ],
          "messages": [
            {
              "role": "user",
              "content": [
                {
                  "type": "text",
                  "text": "Hello, can you tell me more about the solar system?"
                }
              ]
            },
            {
              "role": "assistant",
              "content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
            },
            {
              "role": "user",
              "content": [
                {
                  "type": "text",
                  "text": "Good to know."
                },
                {
                  "type": "text",
                  "text": "Tell me more about Mars.",
                  "cache_control": {"type": "ephemeral"}
                }
              ]
            }
          ]
}' ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
system:
- type: text
text: "...long system prompt"
cache_control:
type: ephemeral
messages:
- role: user
content:
- type: text
text: Hello, can you tell me more about the solar system?
- role: assistant
content: >-
Certainly! The solar system is the collection of celestial bodies that
orbit our Sun. It consists of eight planets, numerous moons, asteroids,
comets, and other objects. The planets, in order from closest to farthest
from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus,
and Neptune. Each planet has its own unique characteristics and features.
Is there a specific aspect of the solar system you would like to know
more about?
- role: user
content:
- type: text
text: Good to know.
- type: text
text: Tell me more about Mars.
cache_control:
type: ephemeral
YAML client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
system=[
{
"type": "text",
"text": "...long system prompt",
"cache_control": {"type": "ephemeral"},
}
],
messages=[
# ...percakapan panjang sejauh ini
{
"role": "user",
"content": [
{
"type": "text",
"text": "Hello, can you tell me more about the solar system?",
}
],
},
{
"role": "assistant",
"content": "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?",
},
{
"role": "user",
"content": [
{"type": "text", "text": "Good to know."},
{
"type": "text",
"text": "Tell me more about Mars.",
"cache_control": {"type": "ephemeral"},
},
],
},
],
)
print(response.usage.model_dump_json()) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
// ...percakapan panjang sejauh ini
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content:
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you'd like to know more about?"
},
{
role: "user",
content: [
{
type: "text",
text: "Good to know."
},
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage); JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
System = new MessageCreateParamsSystem(new List<TextBlockParam>
{
new TextBlockParam()
{
Text = "...long system prompt",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new()
{
Role = Role.User,
Content = new MessageParamContent(new List<ContentBlockParam>
{
new ContentBlockParam(new TextBlockParam("Hello, can you tell me more about the solar system?")),
}),
},
new()
{
Role = Role.Assistant,
Content = "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List<ContentBlockParam>
{
new ContentBlockParam(new TextBlockParam("Good to know.")),
new ContentBlockParam(new TextBlockParam()
{
Text = "Tell me more about Mars.",
CacheControl = new CacheControlEphemeral(),
}),
})
}
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
System: []juglow.TextBlockParam{
{
Text: "...long system prompt",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("Hello, can you tell me more about the solar system?")),
juglow.NewAssistantMessage(juglow.NewTextBlock("Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?")),
{
Role: juglow.MessageParamRoleUser,
Content: []juglow.ContentBlockParamUnion{
juglow.NewTextBlock("Good to know."),
{OfText: &juglow.TextBlockParam{
Text: "Tell me more about Mars.",
CacheControl: juglow.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON()) import com.juglow.models.messages.CacheControlEphemeral;
// ...
public class ConversationWithCacheControlExample {
public static void main(String[] args) {
JuglowClient client = JuglowOkHttpClient.fromEnv();
// Buat prompt sistem sementara
TextBlockParam systemPrompt = TextBlockParam.builder()
.text("...long system prompt")
.cacheControl(CacheControlEphemeral.builder().build())
.build();
// Buat parameter pesan
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.systemOfTextBlockParams(List.of(systemPrompt))
// Pesan pengguna pertama (tanpa kontrol cache)
.addUserMessage("Hello, can you tell me more about the solar system?")
// Respons asisten
.addAssistantMessage(
"Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
)
// Pesan pengguna kedua (dengan kontrol cache)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(TextBlockParam.builder().text("Good to know.").build()),
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Tell me more about Mars.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
} $client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Hello, can you tell me more about the solar system?'
]
]
],
[
'role' => 'assistant',
'content' => "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
],
[
'role' => 'user',
'content' => [
['type' => 'text', 'text' => 'Good to know.'],
[
'type' => 'text',
'text' => 'Tell me more about Mars.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'haijun-opus-5-5',
system: [
[
'type' => 'text',
'text' => '...long system prompt',
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL; client = Juglow::Client.new
message = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
system: [
{
type: "text",
text: "...long system prompt",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: [
{
type: "text",
text: "Hello, can you tell me more about the solar system?"
}
]
},
{
role: "assistant",
content: "Certainly! The solar system is the collection of celestial bodies that orbit our Sun. It consists of eight planets, numerous moons, asteroids, comets, and other objects. The planets, in order from closest to farthest from the Sun, are: Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and Neptune. Each planet has its own unique characteristics and features. Is there a specific aspect of the solar system you would like to know more about?"
},
{
role: "user",
content: [
{ type: "text", text: "Good to know." },
{
type: "text",
text: "Tell me more about Mars.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usageContoh ini menunjukkan cara menggunakan caching prompt dalam percakapan multi-giliran.
Pada setiap giliran, blok terakhir dari pesan terakhir ditandai dengan cache_control sehingga percakapan dapat di-cache secara bertahap. Sistem secara otomatis mencari dan menggunakan urutan blok terpanjang yang sebelumnya telah di-cache untuk pesan lanjutan. Artinya, blok yang sebelumnya ditandai dengan blok cache_control kemudian tidak lagi ditandai, tetapi blok tersebut tetap akan dianggap sebagai cache hit (dan juga penyegaran cache!) jika dikenai dalam waktu 5 menit.
Selain itu, perhatikan bahwa parameter cache_control ditempatkan pada pesan sistem. Ini untuk memastikan bahwa jika pesan tersebut dikeluarkan dari cache (setelah tidak digunakan selama lebih dari 5 menit), pesan tersebut akan ditambahkan kembali ke cache pada permintaan berikutnya.
Pendekatan ini berguna untuk mempertahankan konteks dalam percakapan yang sedang berlangsung tanpa memproses informasi yang sama berulang kali.
Jika ini diatur dengan benar, Anda akan melihat hal berikut dalam respons usage dari setiap permintaan:
input_tokens: Jumlah token dalam pesan pengguna baru (akan minimal)cache_creation_input_tokens: Jumlah token dalam giliran asisten dan pengguna yang barucache_read_input_tokens: Jumlah token dalam percakapan hingga giliran sebelumnya
#### Menggabungkan semuanya: Beberapa breakpoint cache
      curl https://haijun.my.id/v1/messages \
        -H "x-api-key: $JUGLOW_API_KEY" \
        -H "juglow-version: 2023-06-01" \
        -H "content-type: application/json" \
        -d '{
          "model": "haijun-opus-5-5",
          "max_tokens": 1024,
          "tools": [
            {
              "name": "search_documents",
              "description": "Search through the knowledge base",
              "input_schema": {
                "type": "object",
                "properties": {
                  "query": {
                    "type": "string",
                    "description": "Search query"
                  }
                },
                "required": ["query"]
              }
            },
            {
              "name": "get_document",
              "description": "Retrieve a specific document by ID",
              "input_schema": {
                "type": "object",
                "properties": {
                  "doc_id": {
                    "type": "string",
                    "description": "Document ID"
                  }
                },
                "required": ["doc_id"]
              },
              "cache_control": {"type": "ephemeral"}
            }
          ],
          "system": [
            {
              "type": "text",
              "text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
              "cache_control": {"type": "ephemeral"}
            },
            {
              "type": "text",
              "text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
              "cache_control": {"type": "ephemeral"}
            }
          ],
          "messages": [
            {
              "role": "user",
              "content": "Can you search for information about Mars rovers?"
            },
            {
              "role": "assistant",
              "content": [
                {
                  "type": "tool_use",
                  "id": "tool_1",
                  "name": "search_documents",
                  "input": {"query": "Mars rovers"}
                }
              ]
            },
            {
              "role": "user",
              "content": [
                {
                  "type": "tool_result",
                  "tool_use_id": "tool_1",
                  "content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
                }
              ]
            },
            {
              "role": "assistant",
              "content": [
                {
                  "type": "text",
                  "text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
                }
              ]
            },
            {
              "role": "user",
              "content": [
                {
                  "type": "text",
                  "text": "Yes, please tell me about the Perseverance rover specifically.",
                  "cache_control": {"type": "ephemeral"}
                }
              ]
            }
          ]
}' ant messages create --transform usage <<'YAML'
model: haijun-opus-5-5
max_tokens: 1024
tools:
- name: search_documents
description: Search through the knowledge base
input_schema:
type: object
properties:
query:
type: string
description: Search query
required: [query]
- name: get_document
description: Retrieve a specific document by ID
input_schema:
type: object
properties:
doc_id:
type: string
description: Document ID
required: [doc_id]
cache_control:
type: ephemeral
system:
- type: text
text: |-
You are a helpful research assistant with access to a document knowledge base.
# Instructions
- Always search for relevant documents before answering
- Provide citations for your sources
- Be objective and accurate in your responses
- If multiple documents contain relevant information, synthesize them
- Acknowledge when information is not available in the knowledge base
cache_control:
type: ephemeral
- type: text
text: |-
# Knowledge Base Context
Here are the relevant documents for this conversation:
## Document 1: Solar System Overview
The solar system consists of the Sun and all objects that orbit it...
## Document 2: Planetary Characteristics
Each planet has unique features. Mercury is the smallest planet...
## Document 3: Mars Exploration
Mars has been a target of exploration for decades...
[Additional documents...]
cache_control:
type: ephemeral
messages:
- role: user
content: Can you search for information about Mars rovers?
- role: assistant
content:
- type: tool_use
id: tool_1
name: search_documents
input:
query: Mars rovers
- role: user
content:
- type: tool_result
tool_use_id: tool_1
content: >-
Found 3 relevant documents: Document 3 (Mars Exploration),
Document 7 (Rover Technology), Document 9 (Mission History)
- role: assistant
content:
- type: text
text: >-
I found 3 relevant documents about Mars rovers. Let me get more
details from the Mars Exploration document.
- role: user
content:
- type: text
text: Yes, please tell me about the Perseverance rover specifically.
cache_control:
type: ephemeral
YAML client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
tools=[
{
"name": "search_documents",
"description": "Search through the knowledge base",
"input_schema": {
"type": "object",
"properties": {
"query": {"type": "string", "description": "Search query"}
},
"required": ["query"],
},
},
{
"name": "get_document",
"description": "Retrieve a specific document by ID",
"input_schema": {
"type": "object",
"properties": {
"doc_id": {"type": "string", "description": "Document ID"}
},
"required": ["doc_id"],
},
"cache_control": {"type": "ephemeral"},
},
],
system=[
{
"type": "text",
"text": "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
"cache_control": {"type": "ephemeral"},
},
{
"type": "text",
"text": "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
"cache_control": {"type": "ephemeral"},
},
],
messages=[
{
"role": "user",
"content": "Can you search for information about Mars rovers?",
},
{
"role": "assistant",
"content": [
{
"type": "tool_use",
"id": "tool_1",
"name": "search_documents",
"input": {"query": "Mars rovers"},
}
],
},
{
"role": "user",
"content": [
{
"type": "tool_result",
"tool_use_id": "tool_1",
"content": "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}
],
},
{
"role": "assistant",
"content": [
{
"type": "text",
"text": "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
}
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": "Yes, please tell me about the Perseverance rover specifically.",
"cache_control": {"type": "ephemeral"},
}
],
},
],
)
print(response.usage.model_dump_json()) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content:
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
});
console.log(response.usage); JuglowClient client = new()
{
ApiKey = Environment.GetEnvironmentVariable("JUGLOW_API_KEY")
};
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
Tools =
[
new ToolUnion(new Tool()
{
Name = "search_documents",
Description = "Search through the knowledge base",
InputSchema = new InputSchema()
{
Properties = new Dictionary<string, JsonElement>
{
["query"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Search query" }),
},
Required = ["query"],
},
}),
new ToolUnion(new Tool()
{
Name = "get_document",
Description = "Retrieve a specific document by ID",
InputSchema = new InputSchema()
{
Properties = new Dictionary<string, JsonElement>
{
["doc_id"] = JsonSerializer.SerializeToElement(new { type = "string", description = "Document ID" }),
},
Required = ["doc_id"],
},
CacheControl = new CacheControlEphemeral(),
}),
],
System = new MessageCreateParamsSystem(new List<TextBlockParam>
{
new TextBlockParam()
{
Text = "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl = new CacheControlEphemeral(),
},
new TextBlockParam()
{
Text = "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl = new CacheControlEphemeral(),
},
}),
Messages =
[
new() { Role = Role.User, Content = "Can you search for information about Mars rovers?" },
new()
{
Role = Role.Assistant,
Content = new MessageParamContent(new List<ContentBlockParam>
{
new ContentBlockParam(new ToolUseBlockParam()
{
ID = "tool_1",
Name = "search_documents",
Input = new Dictionary<string, JsonElement>
{
["query"] = JsonSerializer.SerializeToElement("Mars rovers"),
},
}),
}),
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List<ContentBlockParam>
{
new ContentBlockParam(new ToolResultBlockParam()
{
ToolUseID = "tool_1",
Content = "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
}),
}),
},
new()
{
Role = Role.Assistant,
Content = "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.",
},
new()
{
Role = Role.User,
Content = new MessageParamContent(new List<ContentBlockParam>
{
new ContentBlockParam(new TextBlockParam()
{
Text = "Yes, please tell me about the Perseverance rover specifically.",
CacheControl = new CacheControlEphemeral(),
}),
}),
},
]
};
var message = await client.Messages.Create(parameters);
Console.WriteLine(message.Usage); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
Tools: []juglow.ToolUnionParam{
{OfTool: &juglow.ToolParam{
Name: "search_documents",
Description: juglow.String("Search through the knowledge base"),
InputSchema: juglow.ToolInputSchemaParam{
Properties: map[string]any{
"query": map[string]any{
"type": "string",
"description": "Search query",
},
},
Required: []string{"query"},
},
}},
{OfTool: &juglow.ToolParam{
Name: "get_document",
Description: juglow.String("Retrieve a specific document by ID"),
InputSchema: juglow.ToolInputSchemaParam{
Properties: map[string]any{
"doc_id": map[string]any{
"type": "string",
"description": "Document ID",
},
},
Required: []string{"doc_id"},
},
CacheControl: juglow.NewCacheControlEphemeralParam(),
}},
},
System: []juglow.TextBlockParam{
{
Text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
{
Text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
CacheControl: juglow.NewCacheControlEphemeralParam(),
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("Can you search for information about Mars rovers?")),
juglow.NewAssistantMessage(juglow.NewToolUseBlock(
"tool_1",
map[string]any{"query": "Mars rovers"},
"search_documents",
)),
juglow.NewUserMessage(juglow.NewToolResultBlock(
"tool_1",
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)",
false,
)),
juglow.NewAssistantMessage(juglow.NewTextBlock("I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.")),
{
Role: juglow.MessageParamRoleUser,
Content: []juglow.ContentBlockParamUnion{
{OfText: &juglow.TextBlockParam{
Text: "Yes, please tell me about the Perseverance rover specifically.",
CacheControl: juglow.NewCacheControlEphemeralParam(),
}},
},
},
},
})
if err != nil {
log.Fatal(err)
}
fmt.Println(response.Usage.RawJSON()) import com.juglow.models.messages.CacheControlEphemeral;
// ...
public class MultipleCacheBreakpointsExample {
public static void main(String[] args) {
JuglowClient client = JuglowOkHttpClient.fromEnv();
// Skema alat pencarian
InputSchema searchSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("query", Map.of("type", "string", "description", "Search query"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("query")))
.build();
// Skema alat pengambil dokumen
InputSchema getDocSchema = InputSchema.builder()
.properties(
JsonValue.from(
Map.of("doc_id", Map.of("type", "string", "description", "Document ID"))
)
)
.putAdditionalProperty("required", JsonValue.from(List.of("doc_id")))
.build();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
// Alat dengan cache control pada alat terakhir
.addTool(
Tool.builder()
.name("search_documents")
.description("Search through the knowledge base")
.inputSchema(searchSchema)
.build()
)
.addTool(
Tool.builder()
.name("get_document")
.description("Retrieve a specific document by ID")
.inputSchema(getDocSchema)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
// Prompt sistem dengan cache control terpisah untuk instruksi dan konteks
.systemOfTextBlockParams(
List.of(
TextBlockParam.builder()
.text(
"You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build(),
TextBlockParam.builder()
.text(
"# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]"
)
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
// Riwayat percakapan
.addUserMessage("Can you search for information about Mars rovers?")
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolUse(
ToolUseBlockParam.builder()
.id("tool_1")
.name("search_documents")
.input(JsonValue.from(Map.of("query", "Mars rovers")))
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofToolResult(
ToolResultBlockParam.builder()
.toolUseId("tool_1")
.content(
"Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
)
.build()
)
)
)
.addAssistantMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text(
"I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
)
.build()
)
)
)
.addUserMessageOfBlockParams(
List.of(
ContentBlockParam.ofText(
TextBlockParam.builder()
.text("Yes, please tell me about the Perseverance rover specifically.")
.cacheControl(CacheControlEphemeral.builder().build())
.build()
)
)
)
.build();
Message message = client.messages().create(params);
System.out.println(message.usage());
}
} $client = new Client();
$message = $client->messages->create(
maxTokens: 1024,
messages: [
[
'role' => 'user',
'content' => 'Can you search for information about Mars rovers?'
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'tool_use',
'id' => 'tool_1',
'name' => 'search_documents',
'input' => ['query' => 'Mars rovers']
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'tool_result',
'tool_use_id' => 'tool_1',
'content' => 'Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)'
]
]
],
[
'role' => 'assistant',
'content' => [
[
'type' => 'text',
'text' => 'I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document.'
]
]
],
[
'role' => 'user',
'content' => [
[
'type' => 'text',
'text' => 'Yes, please tell me about the Perseverance rover specifically.',
'cache_control' => ['type' => 'ephemeral']
]
]
]
],
model: 'haijun-opus-5-5',
system: [
[
'type' => 'text',
'text' => "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
'cache_control' => ['type' => 'ephemeral']
],
[
'type' => 'text',
'text' => "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
'cache_control' => ['type' => 'ephemeral']
]
],
tools: [
[
'name' => 'search_documents',
'description' => 'Search through the knowledge base',
'input_schema' => [
'type' => 'object',
'properties' => [
'query' => [
'type' => 'string',
'description' => 'Search query'
]
],
'required' => ['query']
]
],
[
'name' => 'get_document',
'description' => 'Retrieve a specific document by ID',
'input_schema' => [
'type' => 'object',
'properties' => [
'doc_id' => [
'type' => 'string',
'description' => 'Document ID'
]
],
'required' => ['doc_id']
],
'cache_control' => ['type' => 'ephemeral']
]
],
);
echo json_encode($message->usage), PHP_EOL; client = Juglow::Client.new
message = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
tools: [
{
name: "search_documents",
description: "Search through the knowledge base",
input_schema: {
type: "object",
properties: {
query: {
type: "string",
description: "Search query"
}
},
required: ["query"]
}
},
{
name: "get_document",
description: "Retrieve a specific document by ID",
input_schema: {
type: "object",
properties: {
doc_id: {
type: "string",
description: "Document ID"
}
},
required: ["doc_id"]
},
cache_control: { type: "ephemeral" }
}
],
system: [
{
type: "text",
text: "You are a helpful research assistant with access to a document knowledge base.\n\n# Instructions\n- Always search for relevant documents before answering\n- Provide citations for your sources\n- Be objective and accurate in your responses\n- If multiple documents contain relevant information, synthesize them\n- Acknowledge when information is not available in the knowledge base",
cache_control: { type: "ephemeral" }
},
{
type: "text",
text: "# Knowledge Base Context\n\nHere are the relevant documents for this conversation:\n\n## Document 1: Solar System Overview\nThe solar system consists of the Sun and all objects that orbit it...\n\n## Document 2: Planetary Characteristics\nEach planet has unique features. Mercury is the smallest planet...\n\n## Document 3: Mars Exploration\nMars has been a target of exploration for decades...\n\n[Additional documents...]",
cache_control: { type: "ephemeral" }
}
],
messages: [
{
role: "user",
content: "Can you search for information about Mars rovers?"
},
{
role: "assistant",
content: [
{
type: "tool_use",
id: "tool_1",
name: "search_documents",
input: { query: "Mars rovers" }
}
]
},
{
role: "user",
content: [
{
type: "tool_result",
tool_use_id: "tool_1",
content: "Found 3 relevant documents: Document 3 (Mars Exploration), Document 7 (Rover Technology), Document 9 (Mission History)"
}
]
},
{
role: "assistant",
content: [
{
type: "text",
text: "I found 3 relevant documents about Mars rovers. Let me get more details from the Mars Exploration document."
}
]
},
{
role: "user",
content: [
{
type: "text",
text: "Yes, please tell me about the Perseverance rover specifically.",
cache_control: { type: "ephemeral" }
}
]
}
]
)
puts message.usageContoh komprehensif ini menunjukkan cara menggunakan keempat breakpoint cache yang tersedia untuk mengoptimalkan berbagai bagian prompt Anda:
- Cache alat (breakpoint cache 1): Parameter
cache_controlpada definisi alat terakhir meng-cache semua definisi alat.
- Cache instruksi yang dapat digunakan ulang (breakpoint cache 2): Instruksi statis dalam prompt sistem di-cache secara terpisah. Instruksi ini jarang berubah antar permintaan.
- Cache konteks RAG (breakpoint cache 3): Dokumen basis pengetahuan di-cache secara independen, memungkinkan Anda memperbarui dokumen RAG tanpa membatalkan cache alat atau instruksi.
- Cache riwayat percakapan (breakpoint cache 4): Pesan pengguna terakhir ditandai dengan
cache_controluntuk memungkinkan caching percakapan secara bertahap seiring berjalannya percakapan.
Pendekatan ini memberikan fleksibilitas maksimum:
- Jika Anda menambahkan giliran baru ke percakapan tanpa mengubah konten sebelumnya, keempat segmen cache digunakan ulang
- Jika Anda memperbarui dokumen RAG tetapi mempertahankan alat dan instruksi yang sama, dua segmen cache pertama digunakan ulang
- Jika Anda mengubah percakapan tetapi mempertahankan alat, instruksi, dan dokumen yang sama, tiga segmen pertama digunakan ulang
- Perubahan pada breakpoint mana pun membatalkan segmen tersebut dan semua yang ada setelahnya, sementara segmen yang di-cache sebelumnya tetap valid
Untuk permintaan pertama:
input_tokens: Minimal (token setelah breakpoint cache terakhir, mendekati 0 dalam contoh ini)cache_creation_input_tokens: Token dalam semua segmen yang di-cache (alat + instruksi + dokumen RAG + riwayat percakapan)cache_read_input_tokens: 0 (tidak ada cache hit)
Untuk permintaan berikutnya yang hanya berisi pesan pengguna baru (dan breakpoint keempat dipindahkan ke pesan terakhir yang baru tersebut, seperti dalam contoh):
input_tokens: Minimal (token setelah breakpoint cache terakhir, mendekati 0 dalam contoh ini)cache_creation_input_tokens: Token dalam pesan pengguna baru dan giliran asisten sebelumnya (segmen percakapan baru yang sedang di-cache)cache_read_input_tokens: Semua token yang sebelumnya di-cache (alat + instruksi + dokumen RAG + percakapan sebelumnya)
Pola ini sangat efektif untuk:
- Aplikasi RAG dengan konteks dokumen yang besar
- Sistem agen yang menggunakan banyak alat
- Percakapan berdurasi panjang yang perlu mempertahankan konteks
- Aplikasi yang perlu mengoptimalkan berbagai bagian prompt secara independen
Retensi data
Caching prompt (baik otomatis maupun eksplisit) memenuhi syarat ZDR. Juglow tidak menyimpan teks mentah dari prompt Anda atau respons Haijun.
Representasi cache KV (key-value) dan hash kriptografis dari konten yang di-cache hanya disimpan di memori dan tidak disimpan secara permanen (at rest). Entri yang di-cache memiliki masa berlaku minimum 5 menit (standar) atau 1 jam (diperpanjang), setelah itu entri tersebut segera dihapus, meskipun tidak seketika. Entri cache diisolasi antar organisasi dan, pada Haijun API, Haijun Platform on AWS, dan Microsoft Foundry, antar workspace dalam satu organisasi.
Untuk kelayakan ZDR di semua fitur, lihat API dan retensi data.
FAQ
#### Apakah saya memerlukan beberapa breakpoint cache atau cukup satu di akhir?
Dalam sebagian besar kasus, satu breakpoint cache di akhir konten statis Anda sudah cukup. Penulisan cache hanya terjadi pada blok yang Anda tandai. Tempatkan breakpoint pada blok terakhir yang tetap identik di seluruh permintaan, dan setiap permintaan berikutnya akan membaca entri yang sama. Jika blok setelahnya bervariasi per permintaan (timestamp, pesan yang masuk), tempatkan breakpoint sebelum blok tersebut, pada blok stabil terakhir.
Anda hanya memerlukan beberapa breakpoint jika:
- Percakapan yang terus bertambah mendorong breakpoint Anda 20 blok atau lebih melewati penulisan cache terakhir, sehingga entri sebelumnya berada di luar jendela lookback
- Anda ingin meng-cache bagian-bagian yang diperbarui dengan frekuensi berbeda secara independen
- Anda memerlukan kontrol eksplisit atas apa yang di-cache untuk optimasi biaya
Contoh: Jika Anda memiliki instruksi sistem (jarang berubah) dan konteks RAG (berubah setiap hari), Anda dapat menggunakan dua breakpoint untuk meng-cache keduanya secara terpisah.
#### Apakah breakpoint cache menambah biaya?
Tidak, breakpoint cache itu sendiri gratis. Anda hanya membayar untuk:
- Menulis konten ke cache (25% lebih mahal dari token input dasar untuk TTL 5 menit)
- Membaca dari cache (sebagian kecil dari harga token input dasar, lihat Harga)
- Token input reguler untuk konten yang tidak di-cache
Jumlah breakpoint tidak memengaruhi harga; yang penting hanyalah jumlah konten yang di-cache dan dibaca.
#### Bagaimana cara menghitung total token input dari field usage?
Respons usage mencakup tiga field token input terpisah yang bersama-sama mewakili total input Anda:
total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokenscache_read_input_tokens: Token yang diambil dari cache (semua yang ada sebelum breakpoint cache yang telah di-cache)cache_creation_input_tokens: Token baru yang sedang ditulis ke cache (pada breakpoint cache)input_tokens: Token setelah breakpoint cache terakhir yang tidak di-cache
Penting: input_tokens TIDAK mewakili semua token input, hanya bagian setelah breakpoint cache terakhir Anda. Jika Anda memiliki konten yang di-cache, input_tokens biasanya akan jauh lebih kecil daripada total input Anda.
Contoh: Dengan dokumen 200 ribu token yang di-cache dan pertanyaan pengguna sebanyak 50 token:
cache_read_input_tokens: 200.000cache_creation_input_tokens: 0input_tokens: 50- Total: 200.050 token
Rincian ini sangat penting untuk memahami biaya dan penggunaan batas laju Anda. Lihat Melacak performa cache untuk detail lebih lanjut.
#### Berapa lama masa berlaku cache?
Masa berlaku minimum default cache (TTL) adalah 5 menit. Masa berlaku ini diperbarui setiap kali konten yang di-cache digunakan.
Jika Anda merasa 5 menit terlalu singkat, Juglow juga menawarkan TTL cache 1 jam.
#### Kapan masa berlaku cache dimulai?
Masa berlaku diukur sejak awal permintaan yang menulis atau membaca entri cache, bukan sejak akhir responsnya. Waktu yang dihabiskan untuk menghasilkan respons dihitung dalam masa berlaku, sehingga jendela waktu bagi permintaan lanjutan untuk menggunakan ulang cache adalah masa berlaku dikurangi waktu pembuatan respons.
Jika permintaan Anda menghasilkan respons yang panjang dan permintaan berikutnya mungkin baru dimulai setelah masa berlaku habis, gunakan TTL cache 1 jam.
#### Berapa banyak breakpoint cache yang dapat saya gunakan?
Anda dapat mendefinisikan hingga 4 breakpoint cache (menggunakan parameter cache_control) dalam prompt Anda.
#### Apakah caching prompt tersedia untuk semua model?
Caching prompt didukung pada semua model Haijun yang aktif.
#### Bagaimana caching prompt bekerja dengan thinking?
Mengubah parameter thinking (beralih mode, atau mengubah anggaran dalam mode diperpanjang) membatalkan prefiks pesan yang di-cache, dan juga dapat membatalkan prompt sistem dan alat yang di-cache, karena konfigurasi thinking dirender ke dalam prompt. Nilai output_config.effort berperilaku dengan cara yang sama.
Untuk detail lebih lanjut tentang pembatalan cache, lihat Apa yang membatalkan cache.
Untuk informasi lebih lanjut tentang thinking, termasuk interaksinya dengan penggunaan alat dan caching prompt, lihat Thinking dan caching prompt.
#### Bagaimana cara mengaktifkan caching prompt?
Cara termudah adalah menambahkan "cache_control": {"type": "ephemeral"} di tingkat teratas body permintaan Anda (caching otomatis). Sebagai alternatif, sertakan setidaknya satu breakpoint cache_control pada blok konten individual (breakpoint cache eksplisit).
#### Dapatkah saya menggunakan caching prompt dengan fitur API lainnya?
Ya, caching prompt dapat digunakan bersama fitur API lainnya seperti penggunaan alat dan kemampuan vision. Namun, mengubah ada tidaknya gambar dalam prompt atau memodifikasi pengaturan penggunaan alat akan merusak cache.
Untuk detail lebih lanjut tentang pembatalan cache, lihat Apa yang membatalkan cache.
#### Bagaimana caching prompt memengaruhi harga?
Caching prompt memperkenalkan struktur harga baru di mana penulisan cache 5 menit berbiaya 25% lebih mahal dari token input dasar, penulisan cache 1 jam berbiaya 2x token input dasar, dan cache hit berbiaya sebagian kecil dari harga token input dasar (lihat Harga untuk pengali per model).
#### Dapatkah saya menghapus cache secara manual?
Saat ini, tidak ada cara untuk menghapus cache secara manual. Prefiks yang di-cache akan kedaluwarsa secara otomatis setelah minimal 5 menit tidak aktif.
#### Bagaimana cara melacak efektivitas strategi caching saya?
Anda dapat memantau performa cache menggunakan field cache_creation_input_tokens dan cache_read_input_tokens dalam respons API.
#### Apa yang dapat merusak cache?
Lihat Apa yang membatalkan cache untuk detail lebih lanjut tentang pembatalan cache, termasuk daftar perubahan yang memerlukan pembuatan entri cache baru.
#### Bagaimana caching prompt menangani privasi dan pemisahan data?
Caching prompt dirancang dengan langkah-langkah privasi dan pemisahan data yang kuat:
- Kunci cache dihasilkan menggunakan hash kriptografis dari prompt hingga titik kontrol cache. Ini berarti hanya permintaan dengan prompt yang identik yang dapat mengakses cache tertentu.
- Pada Haijun API, Haijun Platform on AWS, dan Microsoft Foundry, cache diisolasi per workspace dalam satu organisasi. Pada Bedrock dan Google Cloud, cache diisolasi per organisasi. Dalam setiap kasus, cache tidak pernah dibagikan antar organisasi, bahkan untuk prompt yang identik. Lihat Penyimpanan dan berbagi cache untuk detailnya.
- Mekanisme caching dirancang untuk menjaga integritas dan privasi setiap percakapan atau konteks yang unik.
- Aman untuk menggunakan
cache_controldi mana saja dalam prompt Anda. Agar caching menghasilkan pembacaan, tempatkan breakpoint di akhir prefiks yang stabil: menempatkannya pada blok yang berubah di setiap permintaan (seperti timestamp atau input bebas dari pengguna) akan menulis entri baru setiap kali dan tidak pernah menghasilkan hit.
Langkah-langkah ini memastikan bahwa caching prompt menjaga privasi dan keamanan data sambil menawarkan manfaat performa.
#### Dapatkah saya menggunakan caching prompt dengan Batches API?
Ya, caching prompt dapat digunakan dengan permintaan Batches API Anda. Namun, karena permintaan batch asinkron dapat diproses secara bersamaan dan dalam urutan apa pun, cache hit disediakan berdasarkan upaya terbaik (best-effort).
Cache 1 jam dapat membantu meningkatkan cache hit Anda. Cara paling hemat biaya untuk menggunakannya adalah sebagai berikut:
- Kumpulkan sekumpulan permintaan pesan yang memiliki prefiks yang sama.
- Kirim permintaan batch dengan satu permintaan yang memiliki prefiks bersama ini dan blok cache 1 jam. Ini akan menulis prefiks ke cache 1 jam.
- Segera setelah ini selesai, kirimkan sisa permintaan. Anda harus memantau job untuk mengetahui kapan job tersebut selesai.
Ini biasanya lebih baik daripada menggunakan cache 5 menit karena permintaan batch umumnya membutuhkan waktu antara 5 menit hingga 1 jam untuk selesai.
#### Mengapa saya melihat error AttributeError: 'Beta' object has no attribute 'prompt_caching' di Python?
Error ini biasanya muncul ketika Anda telah meng-upgrade SDK atau menggunakan contoh kode yang sudah usang. Caching prompt tidak lagi memerlukan prefiks beta. Alih-alih:
client.beta.prompt_caching.messages.create(**params)Gunakan:
client.messages.create(**params)#### Mengapa saya melihat 'TypeError: Cannot read properties of undefined (reading 'messages')'?
Error ini biasanya muncul ketika Anda telah meng-upgrade SDK atau menggunakan contoh kode yang sudah usang. Caching prompt tidak lagi memerlukan prefiks beta. Alih-alih:
client.beta.promptCaching.messages.create(/* ... */);Gunakan:
client.messages.create(/* ... */);