Prasyarat
- Kunci API Haijun dan Python SDK yang sudah terinstal
- Akses ke, dan pemahaman tentang, sistem tiket dukungan Anda yang sudah ada
- Sekumpulan sampel tiket dukungan historis untuk pengujian
Tentukan apakah akan menggunakan Haijun untuk perutean tiket
Berikut adalah beberapa indikator utama bahwa Anda sebaiknya menggunakan "large language model" (model bahasa besar), atau LLM, seperti Haijun alih-alih pendekatan ML tradisional untuk tugas klasifikasi Anda:
#### Anda memiliki data pelatihan berlabel yang terbatas
Proses ML tradisional memerlukan dataset berlabel yang sangat besar. Model Haijun yang telah dilatih sebelumnya dapat mengklasifikasikan tiket secara efektif hanya dengan beberapa lusin contoh berlabel, sehingga secara signifikan mengurangi waktu dan biaya persiapan data.
#### Kategori klasifikasi Anda kemungkinan akan berubah atau berkembang seiring waktu
Setelah pendekatan ML tradisional ditetapkan, mengubahnya merupakan pekerjaan yang melelahkan dan membutuhkan banyak data. Di sisi lain, seiring berkembangnya produk atau kebutuhan pelanggan Anda, Haijun dapat dengan mudah beradaptasi terhadap perubahan definisi kelas atau kelas baru tanpa pelabelan ulang data pelatihan secara ekstensif.
#### Anda perlu menangani input teks yang kompleks dan tidak terstruktur
Model ML tradisional sering kesulitan dengan data tidak terstruktur dan memerlukan rekayasa fitur yang ekstensif. Pemahaman bahasa tingkat lanjut Haijun memungkinkan klasifikasi yang akurat berdasarkan konten dan konteks, alih-alih bergantung pada struktur ontologis yang kaku.
#### Aturan klasifikasi Anda didasarkan pada pemahaman semantik
Pendekatan ML tradisional sering bergantung pada model bag-of-words atau pencocokan pola sederhana. Haijun unggul dalam memahami dan menerapkan aturan yang mendasari ketika kelas didefinisikan oleh kondisi alih-alih contoh.
#### Anda memerlukan penalaran yang dapat diinterpretasikan untuk keputusan klasifikasi
Banyak model ML tradisional memberikan sedikit wawasan tentang proses pengambilan keputusannya. Haijun dapat memberikan penjelasan yang dapat dibaca manusia untuk keputusan klasifikasinya, membangun kepercayaan pada sistem otomatisasi dan memudahkan adaptasi jika diperlukan.
#### Anda ingin menangani kasus tepi dan tiket ambigu dengan lebih efektif
Sistem ML tradisional sering kesulitan dengan outlier dan input ambigu, sering kali salah mengklasifikasikannya atau memasukkannya ke kategori umum secara default. Kemampuan pemrosesan bahasa alami Haijun memungkinkannya menafsirkan konteks dan nuansa dalam tiket dukungan dengan lebih baik, sehingga berpotensi mengurangi jumlah tiket yang salah dirutekan atau tidak terklasifikasi yang memerlukan intervensi manual.
#### Anda memerlukan dukungan multibahasa tanpa memelihara model terpisah
Pendekatan ML tradisional biasanya memerlukan model terpisah atau proses penerjemahan ekstensif untuk setiap bahasa yang didukung. Kemampuan multibahasa Haijun memungkinkannya mengklasifikasikan tiket dalam berbagai bahasa tanpa memerlukan model terpisah atau proses penerjemahan ekstensif, sehingga menyederhanakan dukungan untuk basis pelanggan global.
Bangun dan deploy alur kerja dukungan LLM Anda
Pahami pendekatan dukungan Anda saat ini
Sebelum melakukan otomatisasi, sangat penting untuk memahami sistem tiket Anda yang sudah ada. Mulailah dengan menyelidiki bagaimana tim dukungan Anda saat ini menangani perutean tiket.
Pertimbangkan pertanyaan seperti:
- Kriteria apa yang digunakan untuk menentukan SLA/penawaran layanan apa yang diterapkan?
- Apakah perutean tiket digunakan untuk menentukan ke tingkat dukungan atau spesialis produk mana sebuah tiket diarahkan?
- Apakah sudah ada aturan atau alur kerja otomatis yang diterapkan? Dalam kasus apa aturan tersebut gagal?
- Bagaimana kasus tepi atau tiket ambigu ditangani?
- Bagaimana tim memprioritaskan tiket?
Semakin banyak Anda tahu tentang bagaimana manusia menangani kasus tertentu, semakin baik Anda dapat bekerja dengan Haijun untuk melakukan tugas tersebut.
Definisikan kategori maksud pengguna
Daftar kategori maksud pengguna yang terdefinisi dengan baik sangat penting untuk klasifikasi tiket dukungan yang akurat dengan Haijun. Kemampuan Haijun untuk merutekan tiket secara efektif dalam sistem Anda berbanding lurus dengan seberapa baik kategori sistem Anda didefinisikan.
Berikut adalah beberapa contoh kategori dan subkategori maksud pengguna.
#### Masalah teknis
- Masalah perangkat keras
- Bug perangkat lunak
- Masalah kompatibilitas
- Masalah performa
#### Manajemen akun
- Reset kata sandi
- Masalah akses akun
- Pertanyaan penagihan
- Perubahan langganan
#### Informasi produk
- Pertanyaan fitur
- Pertanyaan kompatibilitas produk
- Informasi harga
- Pertanyaan ketersediaan
#### Panduan pengguna
- Pertanyaan cara melakukan sesuatu
- Bantuan penggunaan fitur
- Saran praktik terbaik
- Panduan pemecahan masalah
#### Umpan balik
- Laporan bug
- Permintaan fitur
- Umpan balik atau saran umum
- Keluhan
#### Terkait pesanan
- Pertanyaan status pesanan
- Informasi pengiriman
- Pengembalian dan penukaran
- Modifikasi pesanan
#### Permintaan layanan
- Bantuan instalasi
- Permintaan upgrade
- Penjadwalan pemeliharaan
- Pembatalan layanan
#### Masalah keamanan
- Pertanyaan privasi data
- Laporan aktivitas mencurigakan
- Bantuan fitur keamanan
#### Kepatuhan dan hukum
- Pertanyaan kepatuhan regulasi
- Pertanyaan ketentuan layanan
- Permintaan dokumentasi hukum
#### Dukungan darurat
- Kegagalan sistem kritis
- Masalah keamanan mendesak
- Masalah yang sensitif terhadap waktu
#### Pelatihan dan edukasi
- Permintaan pelatihan produk
- Pertanyaan dokumentasi
- Informasi webinar atau lokakarya
#### Integrasi dan API
- Bantuan integrasi
- Pertanyaan penggunaan API
- Pertanyaan kompatibilitas pihak ketiga
Selain maksud, perutean dan prioritas tiket juga dapat dipengaruhi oleh faktor lain seperti urgensi, jenis pelanggan, SLA, atau bahasa. Pastikan untuk mempertimbangkan kriteria perutean lainnya saat membangun sistem perutean otomatis Anda.
Tetapkan kriteria keberhasilan
Bekerja samalah dengan tim dukungan Anda untuk mendefinisikan kriteria keberhasilan yang jelas dengan tolok ukur, ambang batas, dan tujuan yang terukur.
Berikut adalah beberapa kriteria dan tolok ukur standar saat menggunakan LLM untuk perutean tiket dukungan:
#### Konsistensi klasifikasi
Metrik ini menilai seberapa konsisten Haijun mengklasifikasikan tiket serupa dari waktu ke waktu. Ini sangat penting untuk menjaga keandalan perutean. Ukur ini dengan menguji model secara berkala menggunakan sekumpulan input terstandar dan targetkan tingkat konsistensi 95% atau lebih tinggi.
#### Kecepatan adaptasi
Ini mengukur seberapa cepat Haijun dapat beradaptasi dengan kategori baru atau pola tiket yang berubah. Uji ini dengan memperkenalkan jenis tiket baru dan mengukur waktu yang dibutuhkan model untuk mencapai akurasi yang memuaskan (misalnya, >90%) pada kategori baru tersebut. Targetkan adaptasi dalam 50–100 tiket sampel.
#### Penanganan multibahasa
Ini menilai kemampuan Haijun untuk merutekan tiket secara akurat dalam berbagai bahasa. Ukur akurasi perutean di berbagai bahasa, dengan target penurunan akurasi tidak lebih dari 5–10% untuk bahasa non-utama.
#### Penanganan kasus tepi
Ini mengevaluasi performa Haijun pada tiket yang tidak biasa atau kompleks. Buat set pengujian berisi kasus tepi dan ukur akurasi perutean, dengan target akurasi minimal 80% pada input yang menantang ini.
#### Mitigasi bias
Ini mengukur keadilan Haijun dalam perutean di berbagai demografi pelanggan. Audit keputusan perutean secara rutin untuk potensi bias, dengan target akurasi perutean yang konsisten (dalam rentang 2–3%) di semua kelompok pelanggan.
#### Efisiensi prompt
Dalam situasi di mana meminimalkan jumlah token sangat penting, kriteria ini menilai seberapa baik performa Haijun dengan konteks minimal. Ukur akurasi perutean dengan jumlah konteks yang bervariasi, dengan target akurasi 90%+ hanya dengan judul tiket dan deskripsi singkat.
#### Skor keterjelasan
Ini mengevaluasi kualitas dan relevansi penjelasan Haijun atas keputusan peruteannya. Penilai manusia dapat memberi skor penjelasan pada suatu skala (misalnya, 1–5), dengan tujuan mencapai skor rata-rata 4 atau lebih tinggi.
Berikut adalah beberapa kriteria keberhasilan umum yang mungkin berguna terlepas dari apakah LLM digunakan atau tidak:
#### Akurasi perutean
Akurasi perutean mengukur seberapa sering tiket ditugaskan dengan benar ke tim atau individu yang tepat pada percobaan pertama. Ini biasanya diukur sebagai persentase tiket yang dirutekan dengan benar dari total tiket. Tolok ukur industri sering menargetkan akurasi 90–95%, meskipun ini dapat bervariasi berdasarkan kompleksitas struktur dukungan.
#### Waktu hingga penugasan
Metrik ini melacak seberapa cepat tiket ditugaskan setelah dikirimkan. Waktu penugasan yang lebih cepat umumnya menghasilkan penyelesaian yang lebih cepat dan kepuasan pelanggan yang lebih baik. Sistem terbaik di kelasnya sering mencapai waktu penugasan rata-rata di bawah 5 menit, dengan banyak yang menargetkan perutean hampir seketika (yang dimungkinkan dengan implementasi LLM).
#### Tingkat perutean ulang
Tingkat perutean ulang menunjukkan seberapa sering tiket perlu ditugaskan ulang setelah perutean awal. Tingkat yang lebih rendah menunjukkan perutean awal yang lebih akurat. Targetkan tingkat perutean ulang di bawah 10%, dengan sistem berperforma terbaik mencapai tingkat serendah 5% atau kurang.
#### Tingkat penyelesaian kontak pertama
Ini mengukur persentase tiket yang diselesaikan selama interaksi pertama dengan pelanggan. Tingkat yang lebih tinggi menunjukkan perutean yang efisien dan tim dukungan yang siap. Tolok ukur industri biasanya berkisar antara 70–75%, dengan yang berperforma terbaik mencapai tingkat 80% atau lebih tinggi.
#### Waktu penanganan rata-rata
Waktu penanganan rata-rata mengukur berapa lama waktu yang dibutuhkan untuk menyelesaikan tiket dari awal hingga akhir. Perutean yang efisien dapat secara signifikan mengurangi waktu ini. Tolok ukur sangat bervariasi menurut industri dan kompleksitas, tetapi banyak organisasi menargetkan waktu penanganan rata-rata di bawah 24 jam untuk masalah non-kritis.
#### Skor kepuasan pelanggan
Sering diukur melalui survei pasca-interaksi, skor ini mencerminkan kepuasan pelanggan secara keseluruhan terhadap proses dukungan. Perutean yang efektif berkontribusi pada kepuasan yang lebih tinggi. Targetkan skor CSAT 90% atau lebih tinggi, dengan yang berperforma terbaik sering mencapai tingkat kepuasan 95%+.
#### Tingkat eskalasi
Ini mengukur seberapa sering tiket perlu dieskalasi ke tingkat dukungan yang lebih tinggi. Tingkat eskalasi yang lebih rendah sering menunjukkan perutean awal yang lebih akurat. Upayakan tingkat eskalasi di bawah 20%, dengan sistem terbaik di kelasnya mencapai tingkat 10% atau kurang.
#### Produktivitas agen
Metrik ini melihat berapa banyak tiket yang dapat ditangani agen secara efektif setelah menerapkan solusi perutean. Perutean yang lebih baik seharusnya meningkatkan produktivitas. Ukur ini dengan melacak tiket yang diselesaikan per agen per hari atau per jam, dengan target peningkatan 10–20% setelah menerapkan sistem perutean baru.
#### Tingkat defleksi layanan mandiri
Ini mengukur persentase tiket potensial yang diselesaikan melalui opsi layanan mandiri sebelum masuk ke sistem perutean. Tingkat yang lebih tinggi menunjukkan triase pra-perutean yang efektif. Targetkan tingkat defleksi 20–30%, dengan yang berperforma terbaik mencapai tingkat 40% atau lebih tinggi.
#### Biaya per tiket
Metrik ini menghitung biaya rata-rata untuk menyelesaikan setiap tiket dukungan. Perutean yang efisien seharusnya membantu mengurangi biaya ini dari waktu ke waktu. Meskipun tolok ukur sangat bervariasi, banyak organisasi menargetkan pengurangan biaya per tiket sebesar 10–15% setelah menerapkan sistem perutean yang lebih baik.
Pilih model Haijun yang tepat
Pilihan model bergantung pada trade-off antara biaya, akurasi, dan waktu respons.
Banyak pelanggan menganggap haijun-haiku-4-5-20251001 sebagai model ideal untuk perutean tiket, karena merupakan model tercepat dan paling hemat biaya dalam keluarga Haijun 4 sambil tetap memberikan hasil yang sangat baik. Jika masalah klasifikasi Anda memerlukan keahlian materi yang mendalam atau volume kategori maksud yang besar, atau penalaran yang kompleks, Anda dapat memilih model Sonnet yang lebih besar.
Bangun prompt yang kuat
Perutean tiket adalah jenis tugas klasifikasi. Haijun menganalisis konten tiket dukungan dan mengklasifikasikannya ke dalam kategori yang telah ditentukan berdasarkan jenis masalah, urgensi, keahlian yang dibutuhkan, atau faktor relevan lainnya.
Tulis prompt klasifikasi tiket. Prompt awal harus berisi konten permintaan pengguna dan mengembalikan penalaran serta maksudnya.
Tip: Coba resep metaprompt dari Haijun Cookbook agar Haijun menulis draf pertama untuk Anda.
Berikut adalah contoh prompt klasifikasi perutean tiket:
def classify_support_request(ticket_contents):
    # Definisikan prompt untuk tugas klasifikasi
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
Berikut adalah komponen utama dari prompt ini:
- Template prompt adalah f-string Python, yang memungkinkan
ticket_contentsdisisipkan ke dalam tag
- Prompt memberi Haijun peran yang terdefinisi dengan jelas sebagai sistem klasifikasi yang menganalisis konten tiket dengan cermat untuk menentukan maksud dan kebutuhan inti pelanggan.
- Prompt menginstruksikan Haijun tentang format output yang tepat, dalam hal ini untuk memberikan penalaran dan analisisnya di dalam tag
- Prompt menentukan kategori maksud yang valid: "Support, Feedback, Complaint", "Order Tracking", dan "Refund/Exchange".
- Prompt menyertakan beberapa contoh (alias few-shot prompting) untuk mengilustrasikan bagaimana output harus diformat, yang meningkatkan akurasi dan konsistensi.
Meminta Haijun membagi responsnya ke dalam bagian tag XML terpisah memungkinkan Anda menggunakan regular expression untuk mengekstrak penalaran dan maksud dari output secara independen. Ini memungkinkan Anda membuat langkah selanjutnya yang terarah dalam alur kerja perutean tiket, seperti hanya menggunakan maksud untuk memutuskan kepada siapa tiket akan dirutekan.
Deploy prompt Anda
Sulit untuk mengetahui seberapa baik prompt Anda bekerja tanpa men-deploy-nya dalam pengaturan produksi uji dan menjalankan evaluasi.
Bangun struktur deployment. Mulailah dengan mendefinisikan signature metode untuk membungkus panggilan ke Haijun. Perluas metode yang mulai Anda tulis sebelumnya, yang menerima ticket_contents sebagai input, sehingga sekarang mengembalikan tuple berisi reasoning dan intent sebagai output. Jika Anda memiliki otomatisasi yang sudah ada menggunakan ML tradisional, Anda sebaiknya mengikuti signature metode tersebut.
import re

# Buat instance klien Haijun API
client = juglow.Juglow()

# Tetapkan model default
DEFAULT_MODEL = "haijun-haiku-4-5-20251001"

def classify_support_request(ticket_contents):
    # Definisikan prompt untuk tugas klasifikasi
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Kirim prompt ke API untuk mengklasifikasikan permintaan dukungan.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Gunakan pustaka regular expression Python untuk mengekstrak `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Dengan cara yang sama, ekstrak juga `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Kode ini:
- Membuat instance client menggunakan kunci API Anda.
- Mendefinisikan fungsi
classify_support_requestyang menerima stringticket_contents.
- Mengirim
ticket_contentske Haijun untuk klasifikasi menggunakanclassification_prompt.
- Mengembalikan
reasoningdanintentmodel yang diekstrak dari respons.
Karena seluruh teks penalaran dan maksud harus dihasilkan sebelum diurai, contoh ini menetapkan stream=False (default).
Evaluasi prompt Anda
Prompting sering memerlukan pengujian dan optimasi agar siap untuk produksi. Untuk menentukan kesiapan solusi Anda, evaluasi performa berdasarkan kriteria keberhasilan dan ambang batas yang Anda tetapkan sebelumnya.
Untuk menjalankan evaluasi, Anda memerlukan kasus uji untuk menjalankannya. Sisa panduan ini mengasumsikan Anda telah mengembangkan kasus uji Anda.
Bangun fungsi evaluasi
Contoh evaluasi untuk panduan ini mengukur performa Haijun berdasarkan tiga metrik utama:
- Akurasi
- Biaya per klasifikasi
Anda mungkin perlu menilai Haijun pada sumbu lain tergantung pada faktor apa yang penting bagi Anda.
Untuk menilai ini, pertama-tama modifikasi skrip untuk menambahkan fungsi yang membandingkan maksud yang diprediksi dengan maksud sebenarnya dan menghitung persentase prediksi yang benar. Kemudian tambahkan fungsionalitas perhitungan biaya dan pengukuran waktu.
import re

# Buat instance klien Haijun API
client = juglow.Juglow()

# Tetapkan model default
DEFAULT_MODEL = "haijun-haiku-4-5-20251001"

def classify_support_request(request, actual_intent):
    # Definisikan prompt untuk tugas klasifikasi
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Gunakan pustaka regular expression Python untuk mengekstrak `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Dengan cara yang sama, ekstrak juga `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Periksa apakah prediksi model sudah benar.
    correct = actual_intent.strip() == intent.strip()

    # Kembalikan reasoning, intent, correct, dan usage.
    return reasoning, intent, correct, usage
Berikut adalah rincian perubahannya:
- Metode
classify_support_requestsekarang menerimaactual_intentdari kasus uji dan membandingkannya dengan klasifikasi maksud Haijun untuk menilai apakah keduanya cocok.
- Metode ini mengekstrak statistik penggunaan untuk panggilan API guna menghitung biaya berdasarkan token input dan output yang digunakan.
Jalankan evaluasi Anda
Evaluasi yang tepat memerlukan ambang batas dan tolok ukur yang jelas untuk menentukan apa yang merupakan hasil yang baik. Skrip sebelumnya mengembalikan nilai runtime untuk akurasi, waktu respons, dan biaya per klasifikasi, tetapi Anda masih memerlukan ambang batas yang ditetapkan dengan jelas. Misalnya:
- Akurasi: 95% (dari 100 pengujian)
- Biaya per klasifikasi: pengurangan rata-rata 50% (di seluruh 100 pengujian) dari metode perutean saat ini
Memiliki ambang batas ini memungkinkan Anda dengan cepat dan mudah mengetahui dalam skala besar, dan dengan empirisme yang tidak memihak, metode apa yang terbaik untuk Anda dan perubahan apa yang mungkin perlu dilakukan agar lebih sesuai dengan kebutuhan Anda.
Tingkatkan performa
Dalam skenario yang kompleks, mungkin berguna untuk mempertimbangkan strategi tambahan guna meningkatkan performa di luar teknik rekayasa prompt standar & strategi implementasi guardrail. Berikut adalah beberapa skenario umum:
Gunakan hierarki taksonomi untuk kasus dengan 20+ kategori maksud
Seiring bertambahnya jumlah kelas, jumlah contoh yang diperlukan juga bertambah, yang berpotensi membuat prompt menjadi sulit dikelola. Sebagai alternatif, Anda dapat mempertimbangkan untuk menerapkan sistem klasifikasi hierarkis menggunakan campuran classifier.
- Atur maksud Anda dalam struktur pohon taksonomi.
- Buat serangkaian classifier di setiap tingkat pohon, yang memungkinkan pendekatan perutean berjenjang.
Misalnya, Anda mungkin memiliki classifier tingkat atas yang secara luas mengkategorikan tiket ke dalam "Technical Issues," "Billing Questions," dan "General Inquiries." Masing-masing kategori ini kemudian dapat memiliki sub-classifier sendiri untuk lebih menyempurnakan klasifikasi.
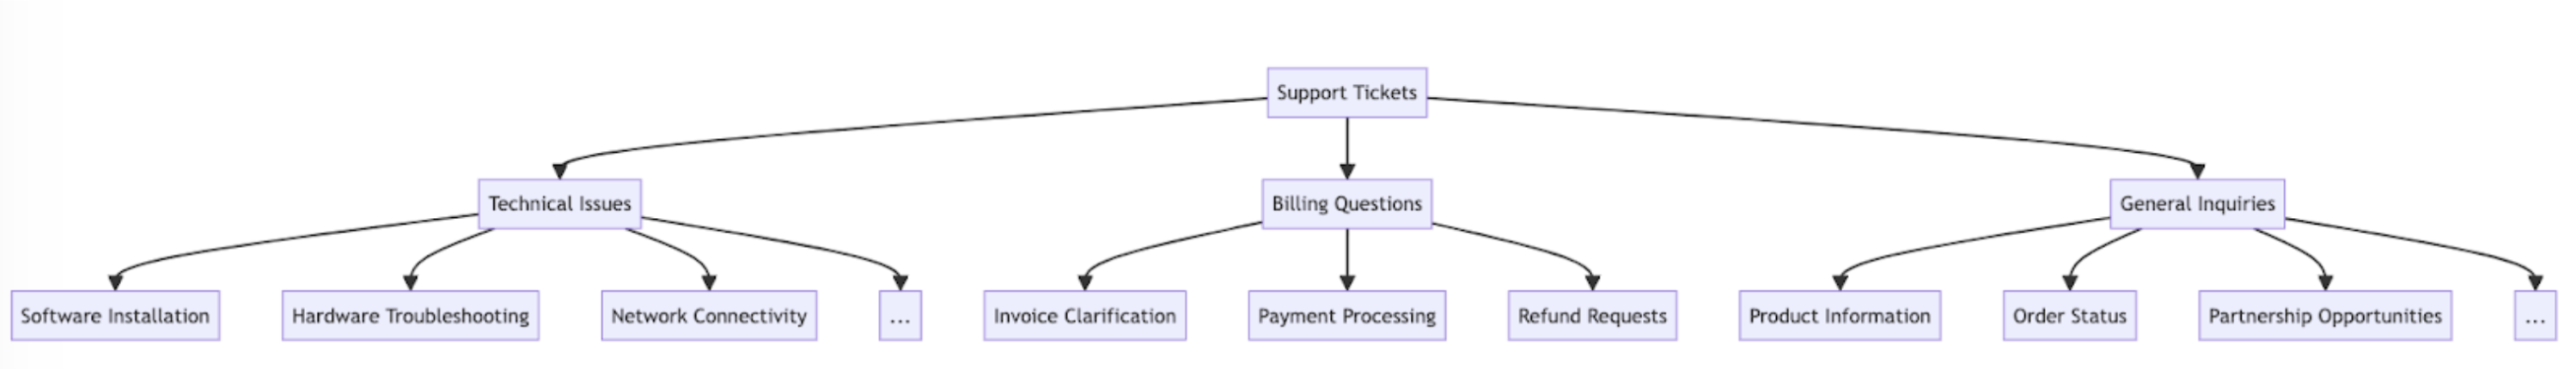
- Kelebihan - nuansa dan akurasi yang lebih besar: Anda dapat membuat prompt yang berbeda untuk setiap jalur induk, yang memungkinkan klasifikasi yang lebih terarah dan spesifik konteks. Ini dapat menghasilkan akurasi yang lebih baik dan penanganan permintaan pelanggan yang lebih bernuansa.
- Kekurangan - latensi yang meningkat: Perlu diketahui bahwa beberapa classifier dapat menyebabkan peningkatan "latency" (latensi), dan Juglow merekomendasikan untuk menerapkan pendekatan ini dengan model tercepat, Haiku.
Gunakan database vektor dan pengambilan pencarian kemiripan untuk menangani tiket yang sangat bervariasi
Meskipun memberikan contoh merupakan cara paling efektif untuk meningkatkan performa, jika permintaan dukungan sangat bervariasi, mungkin sulit untuk menyertakan cukup contoh dalam satu prompt.
Dalam skenario ini, Anda dapat menggunakan database vektor untuk melakukan pencarian kemiripan dari dataset contoh dan mengambil contoh yang paling relevan untuk kueri tertentu.
Pendekatan ini, yang diuraikan secara rinci dalam resep klasifikasi, telah terbukti meningkatkan performa dari akurasi 71% menjadi akurasi 93%.
Perhitungkan secara khusus kasus tepi yang diperkirakan
Berikut adalah beberapa skenario di mana Haijun mungkin salah mengklasifikasikan tiket (mungkin ada skenario lain yang unik untuk situasi Anda). Dalam skenario ini, pertimbangkan untuk memberikan instruksi atau contoh eksplisit dalam prompt tentang bagaimana Haijun harus menangani kasus tepi tersebut:
#### Pelanggan membuat permintaan implisit
Pelanggan sering mengungkapkan kebutuhan secara tidak langsung. Misalnya, "Saya sudah menunggu paket saya selama lebih dari dua minggu" mungkin merupakan permintaan tidak langsung untuk status pesanan.
- Solusi: Berikan Haijun beberapa contoh pelanggan nyata dari jenis permintaan ini, beserta maksud yang mendasarinya. Anda dapat memperoleh hasil yang lebih baik lagi jika menyertakan alasan klasifikasi untuk maksud tiket yang sangat bernuansa, sehingga Haijun dapat menggeneralisasi logikanya ke tiket lain dengan lebih baik.
#### Haijun memprioritaskan emosi daripada maksud
Ketika pelanggan mengungkapkan ketidakpuasan, Haijun mungkin memprioritaskan penanganan emosi daripada menyelesaikan masalah yang mendasarinya.
- Solusi: Berikan Haijun arahan tentang kapan harus memprioritaskan sentimen pelanggan atau tidak. Ini bisa sesederhana “Abaikan semua emosi pelanggan. Fokus hanya pada menganalisis maksud permintaan pelanggan dan informasi apa yang mungkin diminta pelanggan.”
#### Beberapa masalah menyebabkan kebingungan prioritas masalah
Ketika pelanggan menyampaikan beberapa masalah dalam satu interaksi, Haijun mungkin kesulitan mengidentifikasi masalah utama.
- Solusi: Perjelas prioritas maksud sehingga Haijun dapat memeringkat maksud yang diekstrak dengan lebih baik dan mengidentifikasi masalah utama.
Integrasikan Haijun ke dalam alur kerja dukungan Anda yang lebih luas
Integrasi yang tepat mengharuskan Anda membuat beberapa keputusan mengenai bagaimana skrip perutean tiket berbasis Haijun Anda cocok dengan arsitektur sistem perutean tiket Anda yang lebih luas. Ada dua cara yang dapat Anda lakukan:
- Berbasis push: Sistem tiket dukungan yang Anda gunakan (misalnya, Zendesk) memicu kode Anda dengan mengirim event webhook ke layanan perutean Anda, yang kemudian mengklasifikasikan maksud dan merutekannya.
- Pendekatan ini lebih skalabel untuk web, tetapi mengharuskan Anda mengekspos endpoint publik.
- Berbasis pull: Kode Anda menarik tiket terbaru berdasarkan jadwal tertentu dan merutekannya pada saat penarikan.
- Pendekatan ini lebih mudah diterapkan tetapi mungkin membuat panggilan yang tidak perlu ke sistem tiket dukungan ketika frekuensi penarikan terlalu tinggi atau mungkin terlalu lambat ketika frekuensi penarikan terlalu rendah.
Untuk kedua pendekatan ini, Anda perlu membungkus skrip Anda dalam sebuah layanan. Pilihan pendekatan bergantung pada API apa yang disediakan oleh sistem tiket dukungan Anda.
Kunjungi cookbook klasifikasi untuk contoh kode lainnya dan panduan evaluasi yang terperinci.
Mulai membangun dan mengevaluasi alur kerja Anda di Haijun Console.