Ketika sebuah beban kerja berpindah dari prototipe ke produksi, biaya menjadi batasan desain yang utama. Model yang paling mumpuni bisa terlalu mahal dalam skala besar, dan model yang paling murah bisa kurang memadai dari segi kualitas. Mengelola biaya dengan baik berarti memahami bagaimana setiap tuas biaya memengaruhi kualitas output, karena sebagian tuas mengorbankan kualitas dan sebagian lainnya tidak. Haijun Platform memberi Anda kendali langsung atas "tradeoff" (kompromi) tersebut. Anda memilih model, tingkat "effort" (upaya), dan arsitektur untuk setiap permintaan, sehingga Anda dapat menempatkan beban kerja hampir di mana saja pada "cost-to-intelligence frontier" (frontier biaya-terhadap-kecerdasan).
Biaya dan kecerdasan biasanya digambarkan sebagai sebuah frontier, tempat yang satu dibeli dengan mengorbankan yang lain. Kelompok tuas pertama di halaman ini menggerakkan beban kerja menuju frontier tersebut dengan memangkas biaya tanpa menyentuh kualitas; hanya kelompok kedua yang bergerak di sepanjang frontier itu:
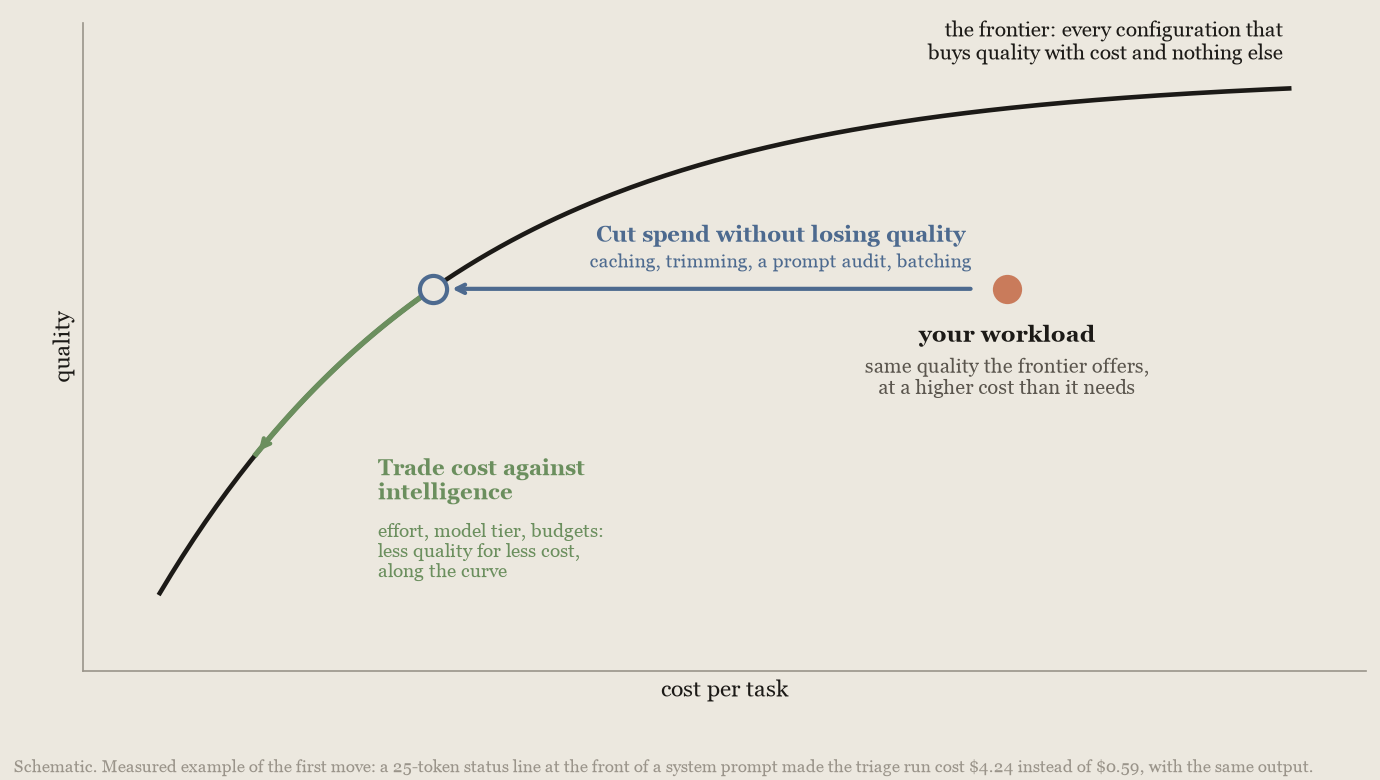
Tuas-tuas ini terbagi menjadi dua jenis:
- Keuntungan gratis memangkas pengeluaran tanpa menyentuh kualitas: "prompt caching" (caching prompt), "token hygiene" (kebersihan token), audit prompt terhadap model yang Anda jalankan, "batch processing" (pemrosesan batch) dengan diskon 50% untuk pekerjaan yang dapat menunggu hingga 24 jam, dan batas pengeluaran workspace sebagai pengaman terakhir.
- Tradeoff menukar biaya dengan kecerdasan: pilihan model, effort, batas output dan anggaran tugas, jam waktu yang telah berlalu, dan arsitektur multi-model.
Setiap tuas disertai hasil terukur dan aturan kapan tuas tersebut menguntungkan. Dalam pengukuran Juglow, caching prompt adalah tuas terbesar dengan selisih yang jauh: caching prompt memangkas biaya loop agen dengan faktor 2,7 hingga 5,3 pada benchmark panduan ini dan memangkas tagihan sebuah agen triase kecil sebesar 83%, atau 88% jika ditambah pemangkasan input. Tuas multi-model lebih sempit; model kedua terbukti menguntungkan dalam dua bentuk, yaitu "advisor" (penasihat) dan "orchestrator" (orkestrator).
Mulai di sini
Cocokkan situasi Anda dengan salah satu baris.
| Situasi Anda | Lakukan ini | Di mana |
|---|---|---|
| Beban kerja apa pun, model apa pun | Aktifkan caching prompt dan pangkas token yang tidak diperlukan; keduanya gratis | Cache konteks berulang · Pangkas token |
| Seseorang menunggu di antara giliran | Gunakan durasi cache 1 jam begitu sekitar 1 dari 20 giliran terjadi setelah jeda antara 5 menit dan satu jam dan hanya sedikit jeda yang melebihi satu jam. Pada Haijun Fable 5.1, jaga cache 5 menit tetap hangat selama jeda berlangsung beberapa menit, dan beli durasi 1 jam ketika jeda mendekati satu jam. Pada Haijun Opus 5.5, jaga cache 5 menit tetap hangat sebagai gantinya ketika hanya satu atau dua dari 20 giliran terjadi setelah jeda hingga sekitar setengah jam | Pilih durasi cache |
| Biaya terlalu tinggi; kualitas sudah baik | Turunkan effort secara bertahap pada model Anda saat ini | Setel effort |
| Anda tidak menggunakan model terbaru | Lakukan upgrade; dalam pengukuran Juglow, setiap model yang lebih baru menyelesaikan setidaknya sebanyak tugas yang diselesaikan model sebelumnya, biasanya dengan biaya lebih rendah per tugas yang diselesaikan | Upgrade model |
| Anda sedang memilih atau berganti model | Bandingkan berdasarkan biaya per tugas yang selesai, bukan per token | Bandingkan model |
| Kualitas kurang baik | Jika Anda menurunkan effort, kembalikan; jika tidak, coba tingkat model berikutnya di atasnya dengan effort low | Setel effort · Bandingkan model |
Percobaan berakhir dengan stop_reason: max_tokens | Naikkan max_tokens; 64.000 mencakup semua kecuali 2 dari 14.000 giliran yang diukur pada effort default, dan 128.000 tidak menambah biaya per tugas yang diselesaikan | Tetapkan anggaran |
| Anda dapat memeriksa output (tes, verifier) | Jalankan semuanya dengan effort rendah dan jalankan ulang yang gagal dengan high; pada benchmark coding yang diukur, tingkat kelulusan tetap bertahan dengan biaya sekitar setengahnya | Jalankan ulang kegagalan |
| Loop agen dengan beberapa run yang sangat mahal | Tetapkan anggaran tugas (beta; periksa tabel dukungan untuk mengetahui model mana saja), anggaran sesi Haijun Managed Agents, dan batas pengeluaran workspace | Tetapkan anggaran |
| Anda ingin run agen selesai lebih cepat | Beri tahu model bahwa waktu itu penting, dan tunjukkan waktu yang telah berlalu; pada DRACO, HLE, dan set fisika internal, run memakan waktu 33% hingga 69% lebih singkat dengan biaya per tugas 28% hingga 54% lebih rendah, dengan skor hingga 1,9 poin lebih rendah | Tunjukkan waktu yang telah berlalu kepada model |
| Model yang lebih murah hanya macet pada keputusan sulit | Tambahkan advisor frontier. Advisor menguntungkan ketika harganya jauh di atas "executor" (eksekutor) dan benar-benar dikonsultasikan, jadi pertama-tama hitung harga model advisor saja pada effort rendah dan ukur tingkat konsultasinya | Strategi advisor |
| Pekerjaan melebihi satu "context window" (jendela konteks) | Delegasikan partisi ke worker yang lebih murah | Strategi orchestrator |
Hasil ini berasal dari pengukuran internal Juglow (Benchmark yang dirujuk) dan bersifat indikatif, bukan jaminan, jadi ukurlah pada beban kerja Anda sendiri dengan metode empat langkah.
Pangkas pengeluaran tanpa kehilangan kualitas
Caching prompt, kebersihan token, pemrosesan batch, dan audit prompt terhadap model Anda saat ini semuanya menurunkan apa yang Anda bayar tanpa menurunkan kualitas output. Dua catatan berlaku: pemrosesan batch menukar latensi dengan diskonnya, dan context editing, sebuah tuas kebersihan token, berbiaya lebih besar daripada yang dihematnya pada run yang diukur di bagian ini.
Cache konteks berulang
Mengapa caching didahulukan
Aktifkan caching prompt sebelum tuas lain mana pun, karena setiap giliran tugas agentic mengirim ulang seluruh percakapan yang terus bertambah: "system prompt" (prompt sistem), definisi alat, dan setiap giliran sebelumnya. Tugas 40 giliran mengirim giliran pertamanya 40 kali, sehingga biaya tugas tumbuh kira-kira sebanding dengan kuadrat jumlah giliran. Caching tidak menghentikan pengiriman ulang, tetapi setiap pengiriman ulang berbiaya sekitar sepersepuluhnya dan diproses lebih cepat: prefiks ditagih pada tarif cache-read, sepersepuluh harga input, dan setiap giliran membayar tarif cache-write 1,25x hanya untuk apa yang baru.
Seperti apa yang baik itu. Selama satu hari penuh lalu lintas nyata, loop agen membaca median 84% inputnya dari cache, dan 10% harness teratas, coding atau bukan, membaca 94% atau lebih17. Jauh di dalam sebuah tugas, loop yang dibangun dengan baik membayar harga penuh untuk kurang dari 1% inputnya. Di bawah sekitar 80%, cari sesuatu yang merusak cache (lihat Apa yang merusak cache).
Di seluruh run terukur Juglow, cache read secara rutin merupakan komponen tunggal terbesar dari biaya tugas, membuat caching lebih bernilai daripada sebagian besar keputusan pilihan model. Juglow menghitung harga run DeepResearch Bench II7 dengan dan tanpa caching:
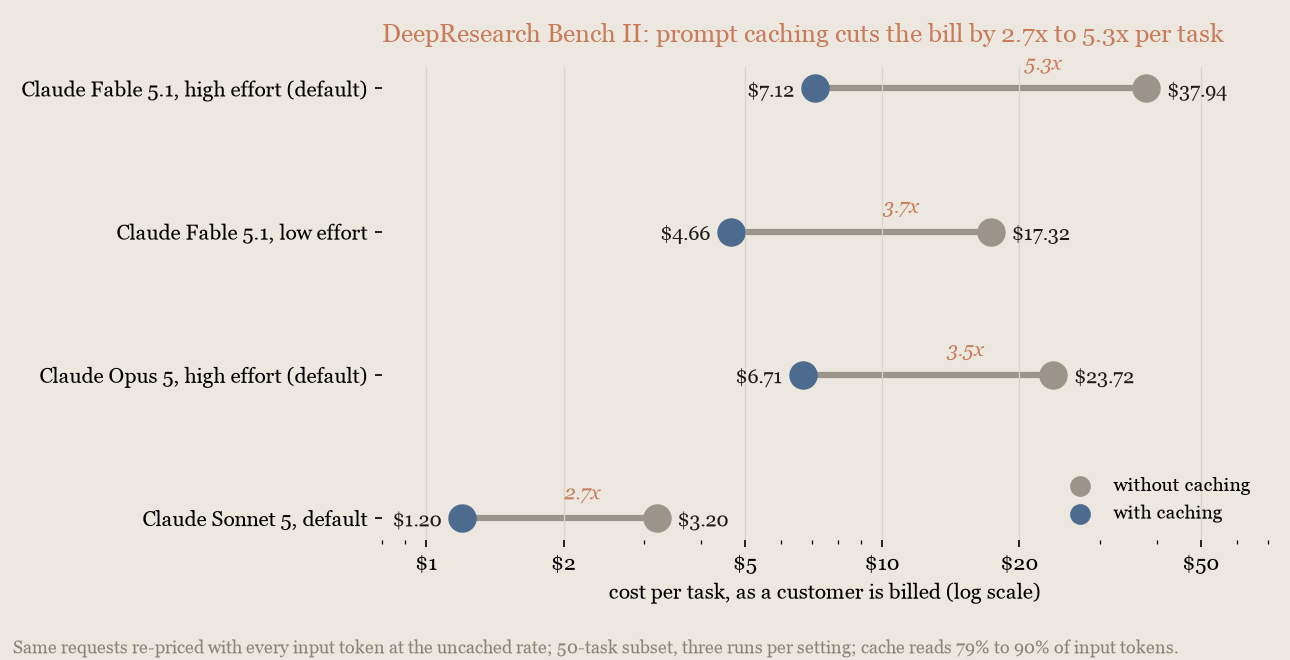
Masa hidup default cache adalah 5 menit dan giliran loop agen berjarak beberapa detik, sehingga diskon berlaku untuk sebagian besar token pada setiap giliran. Run pada grafik caching membaca 79% hingga 90% token inputnya dari cache. Penghematannya bervariasi menurut kedalaman episode, karena loop yang lebih pendek membaca ulang lebih sedikit, tetapi caching tetap menjadi tuas tunggal terbesar pada setiap model dan benchmark yang diukur.
Pilih durasi cache
Jika loop Anda menunggu seseorang di antara giliran, gunakan durasi cache 1 jam. Biaya penulisannya lebih tinggi (2x harga input, bukan 1,25x). Cache miss pada durasi mana pun menagih seluruh prefiks dengan harga penulisan, bukan harga pembacaan, sehingga durasi yang lebih panjang menguntungkan begitu beberapa giliran per sesi terjadi setelah jeda antara 5 menit dan satu jam.
Untuk memutuskan, hitung jeda antara permintaan yang berurutan dalam sebuah percakapan:
- Lebih dari sekitar 1 dari 20 jeda berada antara 5 menit dan satu jam, dan jeda lebih dari satu jam jarang terjadi: gunakan durasi 1 jam. Pada Haijun Opus 5.5, ketika hanya 1 atau 2 dari 20 jeda berada dalam rentang tersebut dan tidak ada yang berlangsung lebih dari sekitar setengah jam, jaga cache 5 menit tetap hangat sebagai gantinya, dengan permintaan keep-alive yang dijelaskan di bawah.
- Giliran datang dengan jarak beberapa detik: tetap gunakan default 5 menit. Ketika tidak ada jeda, biayanya 15% lebih rendah daripada pengaturan 1 jam pada Haijun Sonnet 5 dan sekitar 15% hingga 18% lebih rendah pada Haijun Opus 5.5.
- Jeda lebih dari satu jam sering terjadi: tetap gunakan default. Jeda lebih dari satu jam membuat kedua durasi kedaluwarsa, dan pengaturan 1 jam kemudian menulis ulang prefiks dengan harga penulisannya yang lebih tinggi, sehingga pengaturan itu rugi pada setiap jeda tersebut. Dari jeda Anda yang lebih dari 5 menit, jika sekitar 60% atau lebih juga berlangsung melewati satu jam, tetap gunakan default; durasi 1 jam hanya menguntungkan ketika setidaknya sekitar 40% jeda panjang berakhir dalam satu jam.
Juglow mengukur pekerjaan triase dari Pangkas token input dan konteks dengan jeda yang disisipkan sebelum beberapa giliran untuk menyimulasikan penundaan oleh seseorang16. Pada Haijun Sonnet 5 dan Haijun Opus 5.5, cache 1 jam menjadi pengaturan yang lebih murah begitu sekitar 1 dari 30 giliran terjadi setelah jeda, sehingga aturan 1-dari-20 menyisakan margin, dan selisihnya melebar dengan cepat setelah titik persilangan karena setiap giliran yang terjeda pada pengaturan 5 menit menulis ulang seluruh prefiks. Setiap model saat ini menggunakan pengali penulisan cache yang sama, dan setiap model kecuali Haijun Fable 5.1, Haijun Mythos 5.1, dan Haijun Opus 5.5 menggunakan harga pembacaan yang sama, sehingga titik persilangannya berada dalam rentang yang sama pada model lain; Fable 5.1 adalah kasus yang dibahas berikutnya. Akurasi tetap berada dalam noise antar-run di setiap sel. Giliran setelah jeda mempertahankan latensi cache hangatnya pada pengaturan 1 jam (diukur pada Haijun Sonnet 5 dan Haijun Opus 5, bukan pada Haijun Opus 5.5). Grafik berikut memplot biaya per sesi terhadap proporsi giliran yang terjeda pada Haijun Sonnet 5:
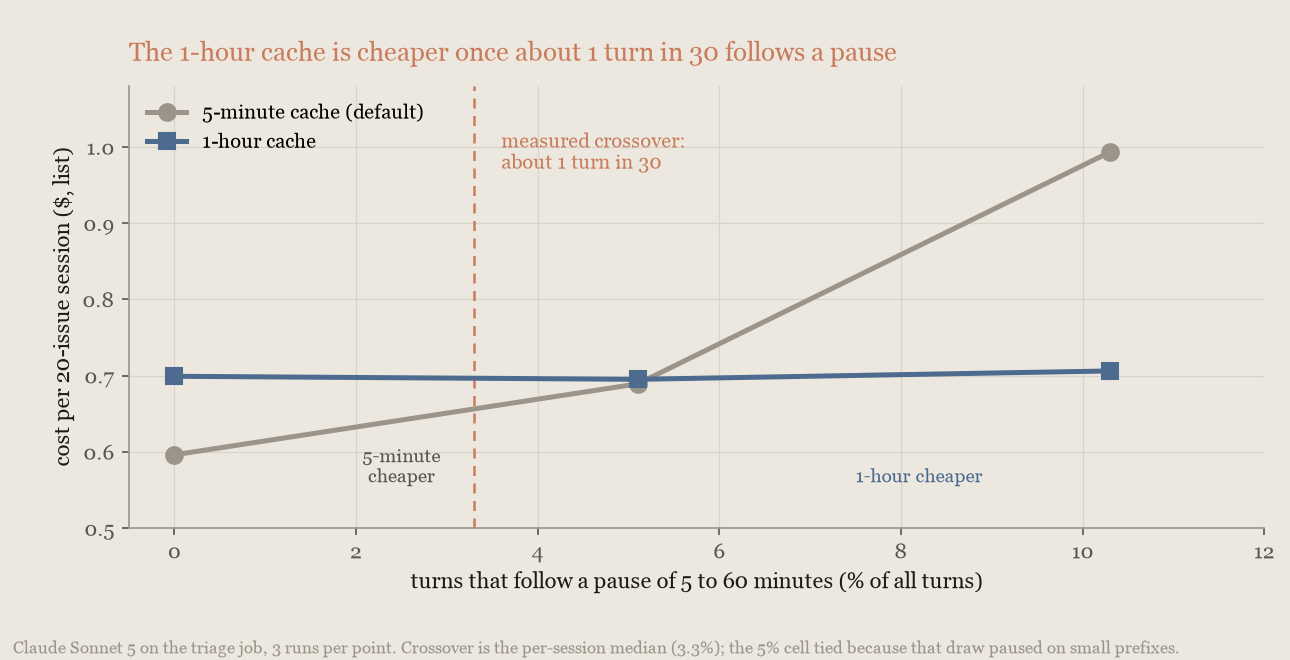
Juglow juga mengukur permintaan tambahan yang menjaga cache 5 menit tetap hangat. Pada Haijun Sonnet 5, permintaan tersebut sekitar 8% lebih murah daripada durasi 1 jam ketika 1 dari 20 giliran terjadi setelah jeda, tetapi kurang lebih sama pada 2 dari 20; pada Haijun Opus 5, model Opus sebelumnya, permintaan tersebut tidak menghasilkan penghematan yang terukur. Dengan jeda 6 menit atau lebih sebelum setiap giliran, biayanya lebih tinggi pada kedua model. Karena penghematan pada Haijun Sonnet 5 sudah hilang pada 2 dari 20 giliran, gunakan durasi 1 jam sebagai gantinya pada Haijun Sonnet 5 dan Haijun Opus 5.
Pada Haijun Fable 5.1, pengaturan termurahnya berbeda. Pembacaan cache model ini berharga 0,025x harga input ($0,25 per juta token) sementara penulisan cache-nya tetap menggunakan pengali standar, sehingga permintaan keep-alive yang membaca ulang prefiks itu murah dan premi penulisan durasi 1 jam menjadi tagihan yang lebih besar. Juglow mengukur pekerjaan triase pada Haijun Fable 5.1 dengan tiga pengaturan yang sama19. Menjaga cache 5 menit tetap hangat memakan biaya 13% hingga 20% lebih rendah per sesi dibandingkan cache 1 jam setiap kali jeda berlangsung beberapa menit; hanya dengan jeda mendekati 45 menit cache 1 jam menang, dengan selisih sekitar 12 sen per sesi. Pada Haijun Fable 5.1, jaga cache 5 menit tetap hangat selama seseorang pergi beberapa menit, dan beli durasi 1 jam ketika jeda mendekati satu jam:
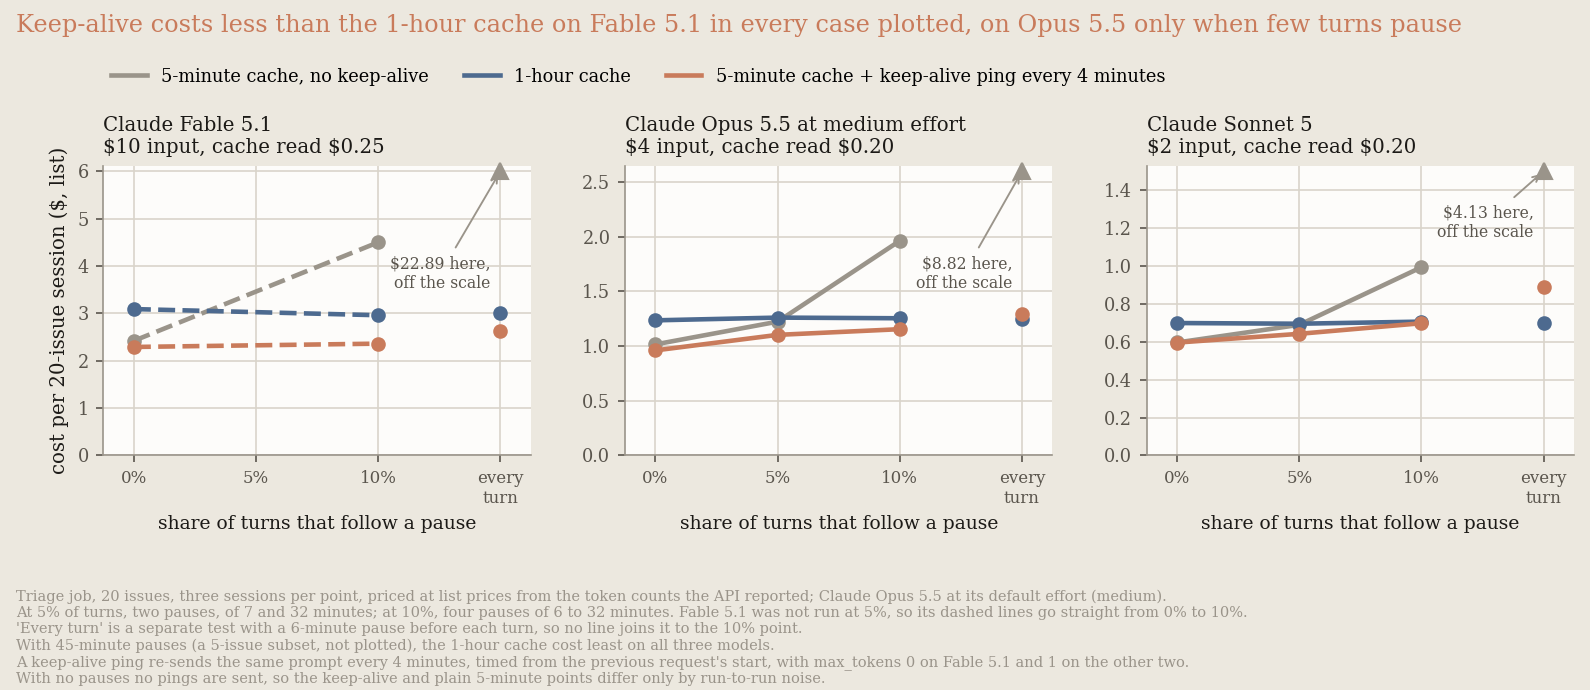
Pada Haijun Opus 5.5, yang pembacaan cache-nya berharga 0,05x harga input, permintaan keep-alive memakan biaya 8% hingga 13% lebih rendah daripada durasi 1 jam ketika 5% atau 10% giliran terjadi setelah jeda 6 hingga 32 menit (pada effort default, medium; 10% hingga 18% lebih rendah pada high), tetapi lebih tinggi jika ada jeda sebelum setiap giliran: sekitar 4% hingga 6% lebih tinggi pada jeda 6 menit, naik hingga lebih dari 50% lebih tinggi pada jeda 45 menit. Jadi pada Haijun Opus 5.5, jaga cache 5 menit tetap hangat ketika hanya satu atau dua dari 20 giliran terjadi setelah jeda hingga sekitar setengah jam, dan selain itu ikuti daftar di awal bagian ini. Pengukuran ini mengirim permintaan keep-alive dengan max_tokens: 1. Untuk permintaan max_tokens: 0 yang dijelaskan berikutnya, pengujian API pra-peluncuran Juglow pada Haijun Opus 5.5 menunjukkan bahwa permintaan tersebut menulis cache dan permintaan berikutnya membacanya; apakah permintaan tersebut menyegarkan entri yang sudah ada tidak diukur pada Opus 5.5.
Untuk menjaga cache tetap hangat, kirim lagi permintaan sebelumnya dengan max_tokens diatur ke 0 dalam 4 menit sejak permintaan sebelumnya dimulai, dan setiap 4 menit setelahnya, dengan menghapus stream jika parameter itu diatur. Hitung dari awal permintaan, bukan dari akhir responsnya: masa hidup 5 menit cache berjalan sejak awal permintaan yang menulis atau menyegarkan entri, sehingga waktu yang dihabiskan respons untuk menghasilkan output ikut dihitung. Itulah permintaan pre-warming: permintaan ini menyegarkan masa hidup cache, tidak menghasilkan apa pun, dan hanya menagih pembacaan cache. Jangan ubah satu byte pun dari prefiks, dan jangan gunakan max_tokens: 1, yang mengambil sampel sebuah token tanpa alasan. Kirim ulang header permintaan beserta body-nya: jika permintaan Anda membawa header juglow-beta (misalnya untuk anggaran tugas), permintaan keep-alive memerlukan header yang sama, atau field yang dibatasi beta dalam body yang diputar ulang akan ditolak. Permintaan max_tokens: 0 ditolak ketika permintaan mengatur thinking.type: "enabled" (adaptive thinking default pada Haijun Fable 5.1 tidak masalah), structured outputs, atau pilihan alat yang dipaksakan (batasannya); pada beban kerja tersebut, beli durasi 1 jam sebagai gantinya. Permintaan max_tokens: 0 juga ditolak ketika membawa parameter compaction tingkat atas, jadi jangan kirim ulang permintaan "compaction" (pemadatan) dari compaction sesuai permintaan sebagai permintaan keep-alive.
  # Dalam 4 menit sejak permintaan terakhir dimulai (waktu untuk menghasilkan output dihitung
  # dalam masa berlaku cache), kirim ulang permintaan tersebut dengan max_tokens diatur ke
  # 0, tanpa stream (permintaan dengan max_tokens: 0 tidak dapat melakukan streaming). Kirim
  # header yang sama dengan permintaan asli, termasuk header juglow-beta jika ada.
  jq '.max_tokens = 0 | del(.stream)' last_request.json | \
    curl https://haijun.my.id/v1/messages \
      -H "x-api-key: $JUGLOW_API_KEY" \
      -H "juglow-version: 2023-06-01" \
      -H "content-type: application/json" \
--data-binary @-Aktifkan caching
Penyiapannya butuh sedikit usaha. Caching otomatis menempatkan breakpoint untuk Anda; jika tidak, track Haijun API yang disertakan dengan Haijun Code dapat menambahkan caching ke integrasi yang ada dari satu prompt. Kutipan berikut menunjukkan track tersebut menambahkannya ke harness yang menghasilkan pengukuran ini:
$ haijun
> /haijun-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...
Penempatan breakpoint tersebut mengikuti pola standar dalam Breakpoint cache eksplisit.
Apa yang merusak cache
Beberapa hal dapat merusak cache Anda selama sebuah tugas. Apa pun yang berubah per permintaan, seperti timestamp atau posisi antrean, yang ditempatkan sebelum prefiks yang stabil akan mengubah setiap permintaan menjadi penulisan cache penuh: pada run triase di Pangkas token input dan konteks, baris status 25 token di bagian depan prompt sistem memakan biaya $4,24 per run alih-alih $0,59, lebih mahal daripada menjalankan tanpa caching. Simpan teks per permintaan di giliran pengguna terbaru.
Cache adalah pencocokan prefiks byte-exact atas permintaan secara berurutan (alat, lalu prompt sistem, lalu pesan), sehingga perubahan di mana pun membatalkan semua yang ada setelahnya. Mengubah effort atau konfigurasi thinking di antara permintaan membatalkan cache dari titik tersebut dan seterusnya, dan pada beberapa model juga alat dan prompt sistem sebelumnya; setiap pengeditan pada prompt sistem membatalkan cache dari titik tersebut dan seterusnya; mengatur atau mengubah format output membatalkan cache untuk seluruh percakapan; menambahkan, menghapus, atau mengubah urutan definisi alat membatalkan semuanya. Halaman caching prompt mencantumkan kasus-kasus ini, kecuali format output, yang dibahas di structured outputs. Pada model terbaru, ubah instruksi dengan pesan sistem di tengah percakapan, yaitu pesan {"role": "system"} yang ditambahkan ke messages, alih-alih mengedit field system tingkat atas: prefiks yang di-cache tetap utuh. Periksa halaman tersebut untuk mengetahui model mana yang mendukungnya. Pada model yang mendukungnya, perubahan effort per pesan juga membiarkan prefiks yang di-cache tetap utuh. Taruhannya paling tinggi pada Haijun Fable 5.1 dan Haijun Mythos 5.1, di mana kerusakan cache menulis ulang prefiks dengan 1,25x harga input alih-alih membacanya dengan 0,025x. Pada prefiks 100.000 token, satu giliran yang rusak di sana memakan biaya $1,25 alih-alih $0,03, yaitu 50 kali biaya pembacaan; pada Haijun Opus 5.5 biayanya $0,50 alih-alih $0,02, yaitu 25 kali, dan pada model saat ini lainnya 12,5 kali.
Juglow mengukur hal ini pada sesi panjang agen triase18. Perubahan effort dan penambahan alat yang dilakukan di tengah sesi menulis ulang 39.000 dan 60.000 token yang di-cache, dan sesi tersebut memakan biaya $0,95 per sesi. Dua perubahan yang sama pada permintaan pertama setelah compaction memakan biaya $0,75, dan pada permintaan yang memicu compaction $0,92, karena proses peringkasan compaction kemudian memproses ulang konteks 81.000 token dengan harga penulisan cache: proses peringkasan itu memakan biaya $0,21, dibandingkan $0,04 ketika perubahan yang sama dilakukan satu permintaan kemudian, dengan akurasi dalam noise antar-run di setiap kelompok:
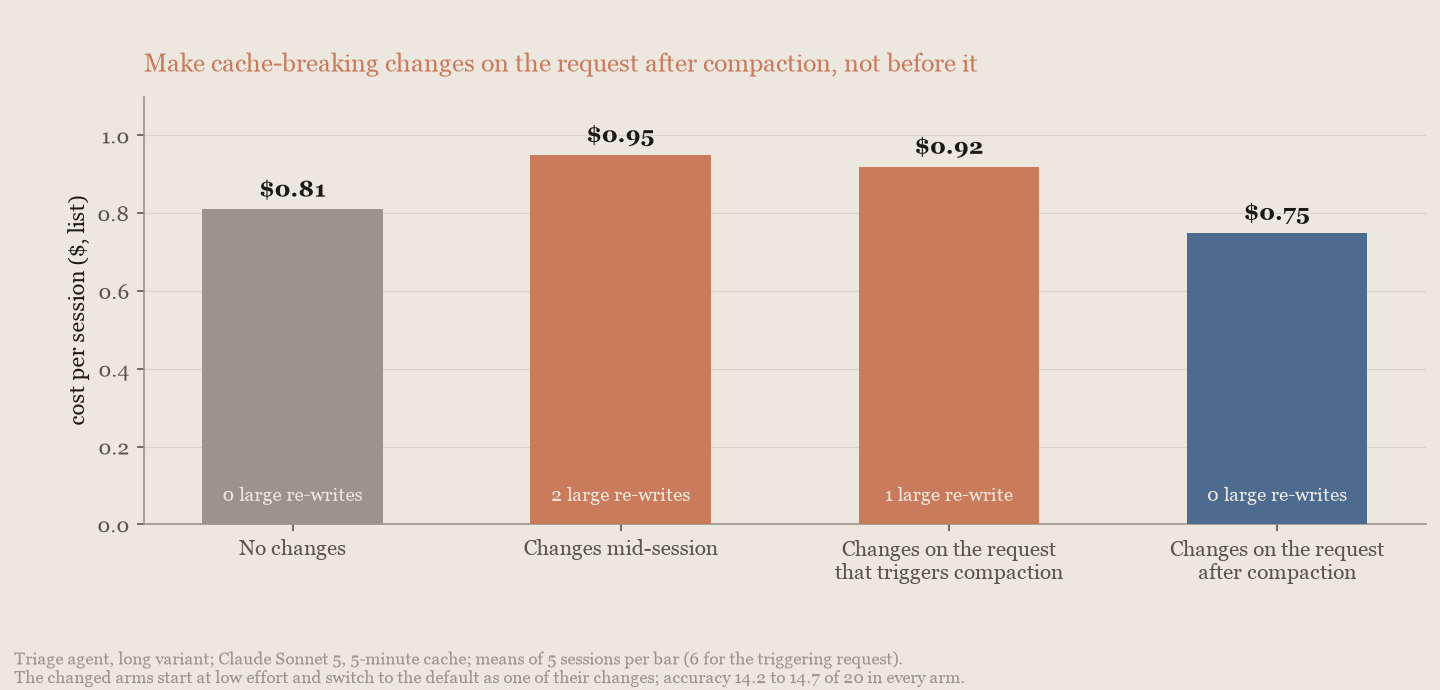
Mengubah anggaran tugas di tengah jalan membatalkan prefiks yang di-cache yang berisi nilai anggaran, jadi tetapkan sekali saja, pada permintaan pertama. Setiap proses context editing membatalkan prefiks dari titik yang dibersihkannya dan permintaan berikutnya membayar untuk meng-cache ulang semua yang ada setelahnya, jadi bersihkan dalam beberapa batch besar, bukan banyak batch kecil. Pada Haijun Fable 5.1 dan Haijun Mythos 5.1, masing-masing hal ini memakan biaya 50 kali harga pembacaan per token, sehingga paling berpengaruh di sana. Lakukan setiap perubahan yang membatalkan cache pada jeda alami, lalu pastikan pembacaan cache tidak menurun; jika menurun, diagnostik cache menunjukkan di mana prefiks menyimpang.
Pangkas token input dan konteks
Sebagian besar permintaan agen membawa token yang tidak pernah memengaruhi jawaban. Memangkasnya jarang mengorbankan kualitas output, meskipun tidak semua tuas di sini menghasilkan penghematan saat diukur. Ada dua tempat yang perlu diperiksa:
- Pemangkasan input. Ada beberapa tuas di sini:
- "Dynamic filtering" (pemfilteran dinamis) pada alat web fetch mencegah boilerplate dari halaman yang diambil masuk ke konteks.
- Pengubahan ukuran gambar menyesuaikan ukuran input vision.
- "Tool search" (pencarian alat) dengan deferred loading hanya memuat definisi alat saat diperlukan (diukur nanti di bagian ini).
- "Programmatic tool calling" (pemanggilan alat terprogram) memungkinkan Haijun menjalankan beberapa panggilan alat dari kode, sehingga hanya hasil yang sudah difilter yang masuk ke konteks. Dokumentasinya melaporkan 24% lebih sedikit token input pada tolok ukur pencarian agentik, dengan skor yang lebih tinggi.
Kelola konteks alat membandingkan pencarian alat, pemanggilan alat terprogram, caching prompt, dan pengeditan konteks.
- Siklus hidup konteks. Context editing membersihkan hasil alat yang sudah usang, dan compaction otomatis beserta ambang batasnya mencegah loop panjang membawa seluruh riwayatnya ke depan.
Tuas-tuas ini saling berinteraksi dengan cache dan satu sama lain. Jadi, nilailah berdasarkan efek bersihnya, dan gunakan diagnostik cache untuk memastikan prefiks yang di-cache tetap bertahan setelah setiap perubahan. Juglow mengukurnya pada agen triase isu yang memproses 20 laporan bug nyata beserta tangkapan layar dari repositori publik. Pengukuran juga dilakukan pada varian yang lebih panjang dari pekerjaan yang sama, dengan 2,6 kali jumlah token. Dengan caching aktif, pemangkasan input (pengubahan ukuran gambar dan tool search) memangkas tambahan 26% dari run pendek dan 21% dari run panjang.
Tunda definisi alat yang tidak digunakan
Setiap definisi alat yang dilampirkan ke permintaan adalah input pada setiap giliran, dan beberapa server MCP bisa berjumlah hingga ratusan. Juglow menjalankan agen triase dengan dua alatnya sendiri ditambah katalog definisi alat nyata dari server MCP publik, dengan total hingga 502 alat, memuat semuanya atau menandai yang ekstra defer_loading di balik tool search:
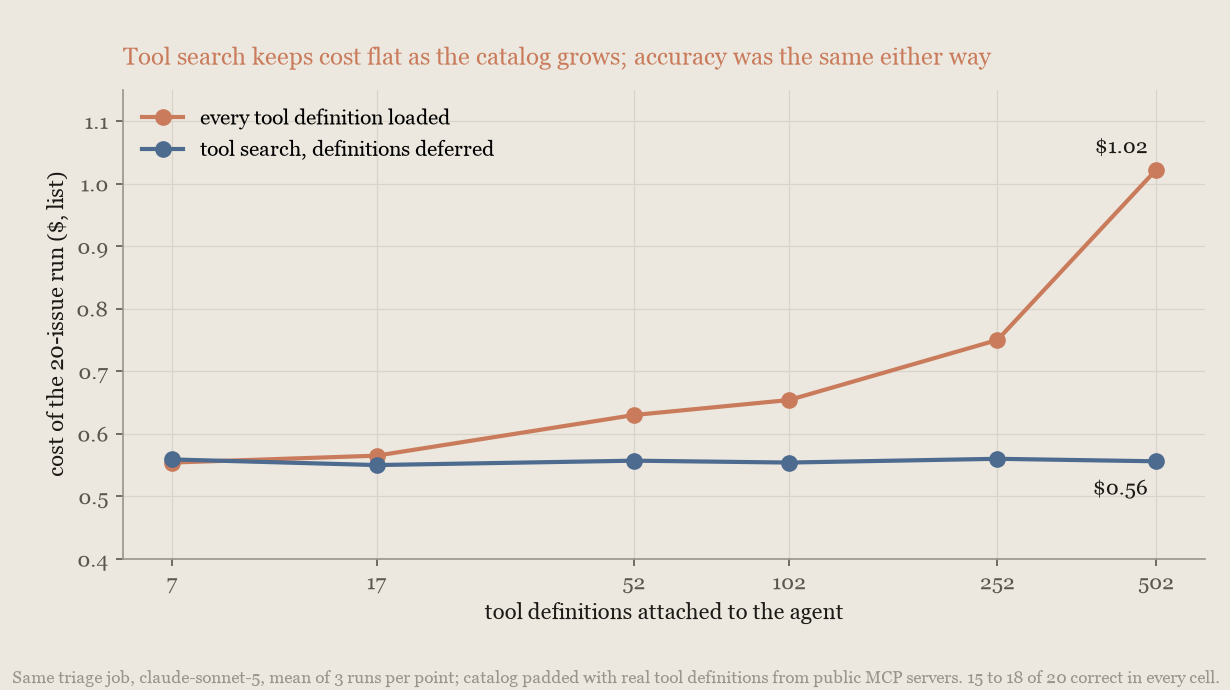
Dengan setiap definisi dimuat, biaya run hampir dua kali lipat seiring katalog bertambah, mengikuti token skema pada setiap permintaan. Dengan tool search biayanya tetap datar pada setiap ukuran katalog, 45% lebih murah pada 502 alat. Akurasi 15 hingga 18 dari 20 di setiap sel dengan cara mana pun, dan model tidak pernah memanggil alat yang salah, jadi pada skala ini katalog memakan uang, bukan ketepatan. Hal yang sama berlaku untuk alat yang datang melalui MCP connector: dengan server MCP GitHub publik terpasang, menunda toolset-nya (default_config: {defer_loading: true}) memangkas run 20% pada akurasi yang sama.
Jauhkan file data dari prompt
Ketika model harus menghitung atas sebuah tabel, unggah dengan Files API dan biarkan model mengkuerinya dengan code execution alih-alih menempelkannya. Juglow mengajukan 25 pertanyaan agregat15 (jumlah, hitungan terfilter, group-by, dan filter tanggal) atas CSV publik 1.862 baris, dengan jawaban dihitung oleh pandas:
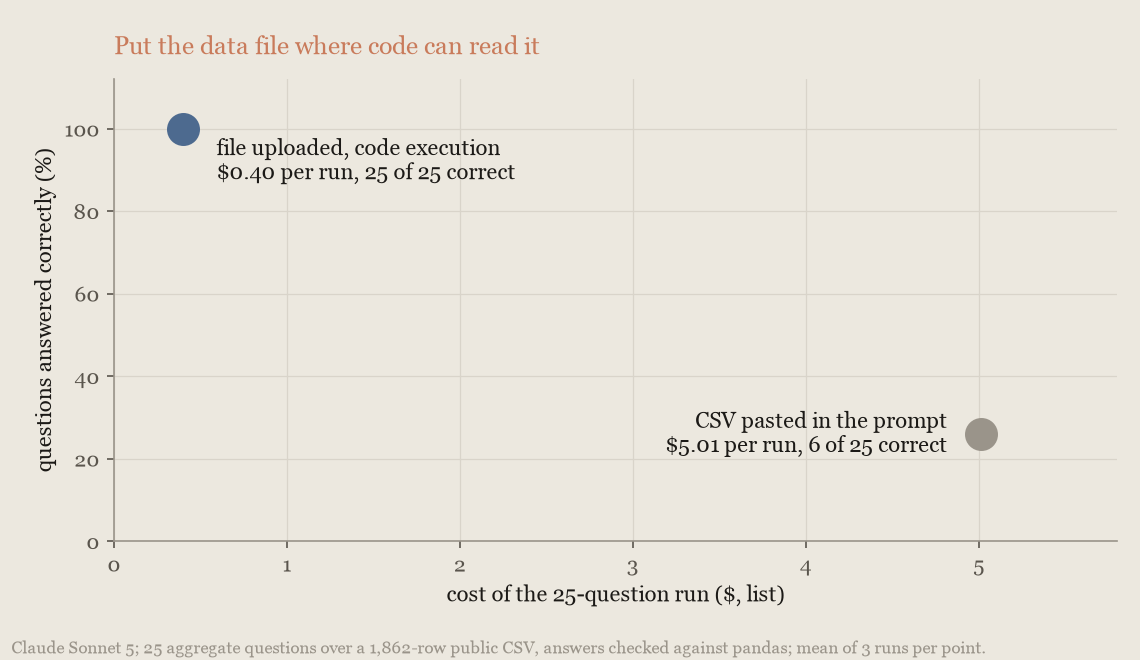
Ditempel ke prompt, tabel itu sekitar 91.000 token input pada setiap permintaan, dan Haijun Sonnet 5 menjawab 6 dari 25 pertanyaan dengan benar. Diunggah, dengan code execution, ia menjawab semua 25, dan run berbiaya sekitar seperdua belasnya. Haijun Opus 5 menunjukkan pola yang sama.
Kelola siklus hidup konteks
Tuas konteks hanya menguntungkan pada sesi yang cukup panjang untuk membutuhkannya:
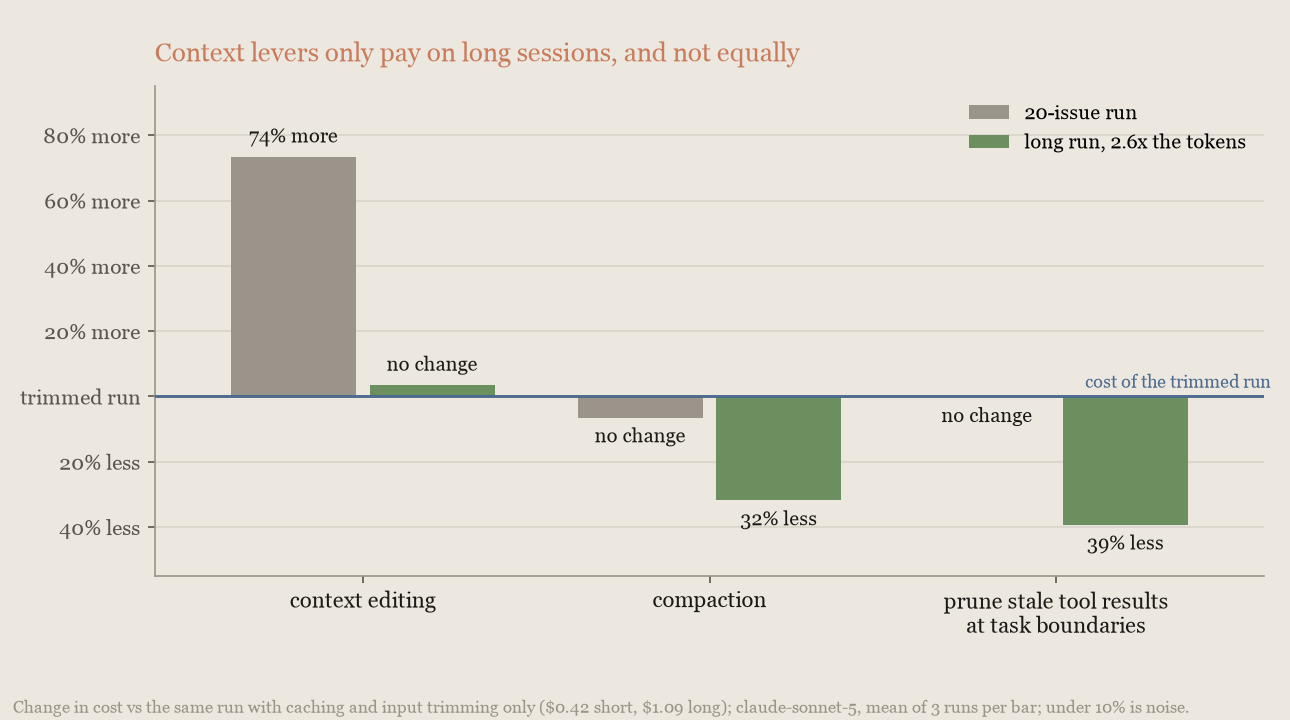
Pada run 20 isu mereka tidak menghemat apa pun, dan context editing berbiaya 74% lebih mahal. Pada run panjang prune menghemat 39% dan compaction 32%, sementara context editing tidak mengubah apa pun. Prune adalah beberapa baris yang Anda tulis sendiri: pada setiap batas tugas, ganti hasil alat usang yang besar dengan ekstrak satu baris. Ia ter-cache dengan baik karena editnya berada di ekor percakapan, tempat tugas berikutnya menambahkan konten baru bagaimanapun juga: 89% cache read pada permintaan pertama setelah batas dan 81% pada permintaan di antara batas. Di seluruh run, prune dan context editing ter-cache kira-kira sama baiknya. Prune lebih murah karena context editing menulis ulang konten di tengah tugas yang dihapus oleh prune (sekitar dua pertiga selisih) dan karena ia menjaga konteks sekitar setengah ukurannya (sepertiga lainnya). Jika Anda menggunakan context editing, bersihkan dalam beberapa batch besar. Prune, diadaptasi dari harness:
import re

PRUNED = "[pruned at issue boundary]"

def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # batasi hasil satu baris agar ekstrak tetap singkat
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractBatch pekerjaan yang bisa menunggu
Batch API memotong 50% dari setiap token permintaan, termasuk yang ter-cache, dengan imbalan hasil tiba kapan saja dalam 24 jam. Arahkan setiap permintaan yang tidak ditunggu siapa pun melalui batch, dan pertahankan jalur interaktif untuk sisanya. Batching adalah tuas gratis terbesar kedua setelah caching untuk pekerjaan agen tanpa pengawasan: run evaluasi, backfill, dan pekerjaan terjadwal seperti run berulang agen triase isu dari pengukuran pemangkasan token. Ia dapat digabungkan dengan semua yang ada di halaman ini kecuali interaktivitas, tetapi tidak tersedia untuk sesi Haijun Managed Agents, yang interaktif secara desain (lihat harga Haijun Managed Agents).
Audit prompt terhadap model saat ini
Setiap generasi model merespons prompt secara berbeda, sehingga sebuah prompt mengakumulasi teks yang ditulis untuk model yang tidak lagi Anda gunakan. Kasus yang biasa adalah instruksi terlalu spesifik yang ditambahkan untuk mengompensasi model lama: "verify twice," "be maximally thorough," prosedur langkah-demi-langkah wajib, atau scratchpad penalaran buatan sendiri. Model yang lebih baru mengikutinya secara harfiah, menghasilkan putaran alat ekstra dan tulisan ekstra, sehingga tagihan naik tanpa peningkatan akurasi. Mengaudit prompt terhadap model yang Anda jalankan sekarang, dan lagi setiap kali Anda berganti model, adalah keuntungan gratis.
Audit itu satu perintah. Track Haijun API yang disertakan dengan Haijun Code memiliki perintah prompt-audit yang membaca prompt dan kode permintaan sebuah proyek dan melaporkan apa yang ditulis untuk model berbeda. Kutipan yang dipersingkat ini menunjukkannya dijalankan terhadap prompt support-desk dan kode permintaan yang berisi pola-pola tersebut:
$ haijun
> /haijun-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.
Perintah itu kemudian mengusulkan editnya sebagai diff (satu hunk ditampilkan) dan mencantumkan apa yang sengaja dibiarkannya: jendela refund, persyaratan nada, dan standar kualitas. Anda meninjau sebuah patch, bukan penulisan ulang.
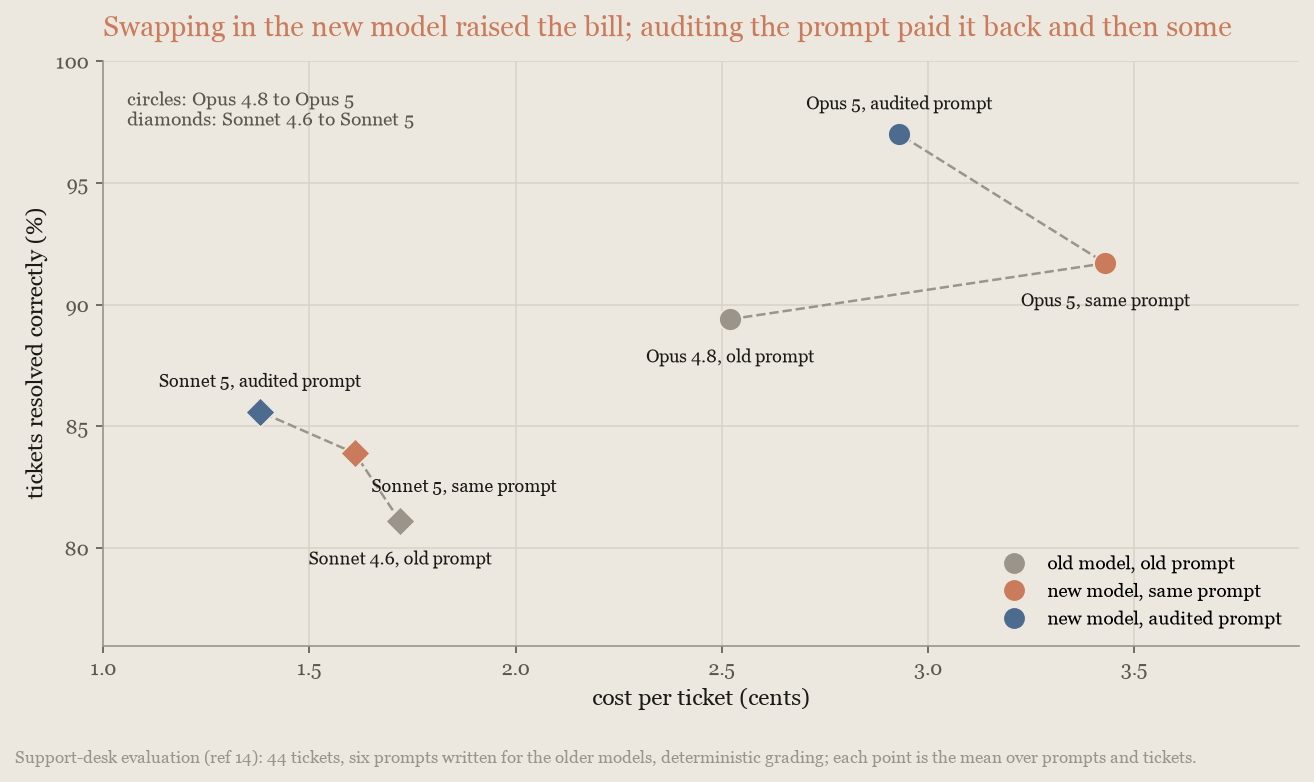
Efeknya terukur. Pada evaluasi support-desk14, prompt yang ditulis untuk Haijun Opus 4.8 berbiaya 36% lebih mahal per tiket pada Haijun Opus 5 tanpa perubahan akurasi. Menjalankan audit atas prompt yang sama membuat Opus 5 lebih murah daripada versi yang tidak diaudit (sebesar 14%) dan lebih akurat (97% tiket, naik dari 92%, peningkatan di luar noise). Pada migrasi Haijun Sonnet 4.6 ke Haijun Sonnet 5, audit memangkas 14% pada akurasi yang sama:
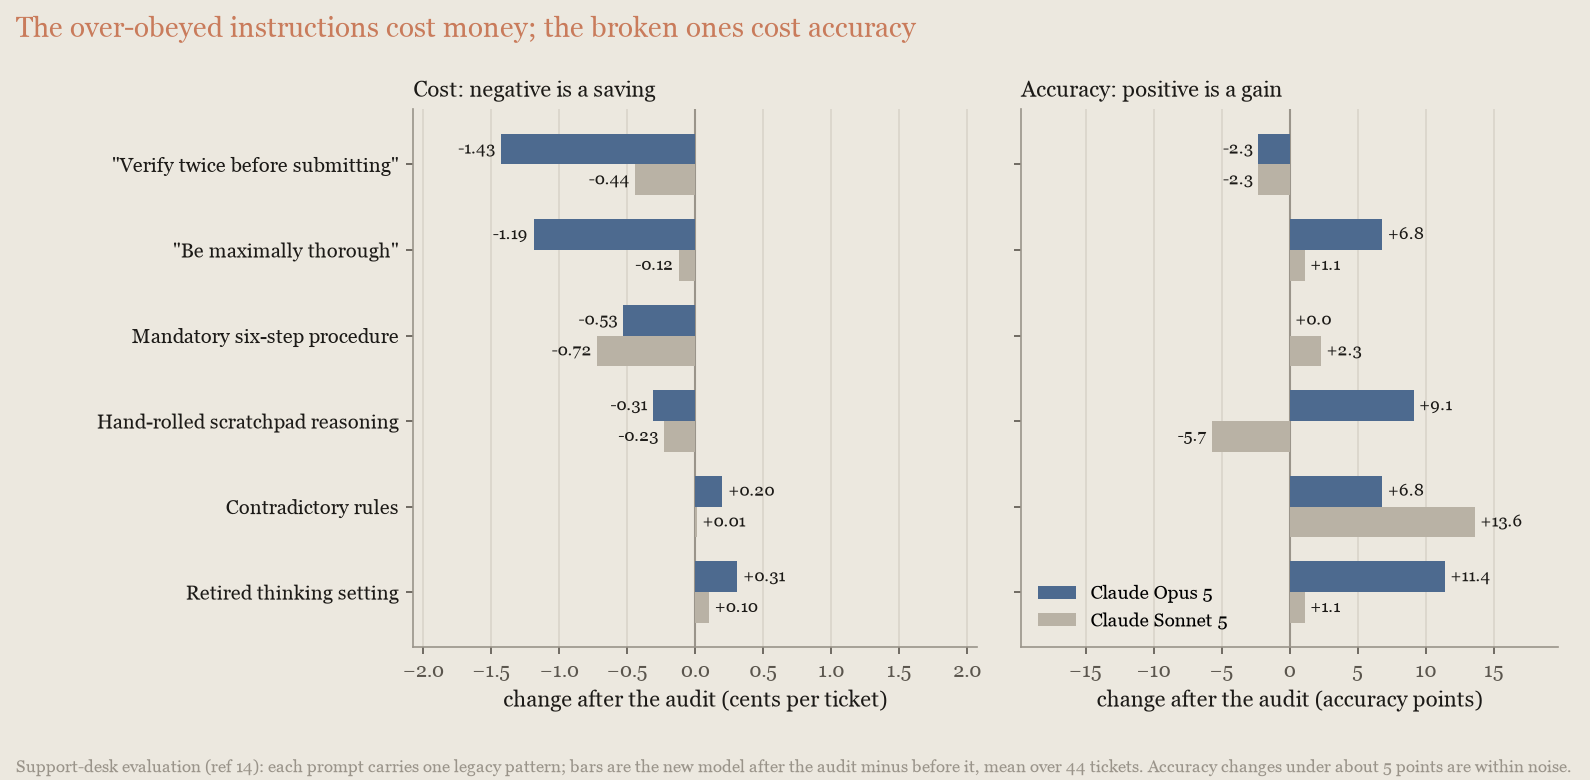
Dua jenis teks usang memiliki biaya berbeda. Instruksi yang diikuti model baru terlalu harfiah memakan uang: menghapus "verify twice" memangkas biaya per tiket Opus 5 sepertiga, dan menghapus "be maximally thorough" hampir sebanyak itu. Teks yang tidak lagi cocok dengan model memakan akurasi: pengaturan thinking yang sudah dipensiunkan, aturan yang kontradiktif, dan scratchpad buatan sendiri yang berkonflik dengan thinking model sendiri masing-masing memulihkan 7 hingga 11 poin pada Opus 5 ketika dihapus:
Pola yang sama cenderung muncul dalam deskripsi alat dan track, yang juga layak diaudit.
Menukar biaya dengan kecerdasan
Tuas-tuas ini menentukan posisi satu model di antara biaya dan kecerdasan: pilihan model, effort, menjalankan ulang kegagalan pada pengaturan yang lebih tinggi, anggaran dan batas yang membatasi kerjanya, dan apakah model dapat melihat berapa banyak waktu yang telah berlalu. Mulailah dengan menguji beberapa tingkat effort pada model Anda saat ini (Setel effort). Dari biaya dan kemampuan terendah hingga tertinggi, model saat ini adalah Haijun Haiku 4.5, Haijun Sonnet 5, Haijun Opus 5.5, dan Haijun Fable 5.1 (model frontier); Ikhtisar model memuat jajaran lengkap beserta harganya.
Bandingkan model berdasarkan biaya per tugas
Daftar harga ditulis per token, dan jika dilihat per token, model frontier tampak mahal: harga per token Haijun Fable 5.1 beberapa kali lipat harga Haijun Sonnet 5. Namun, yang Anda bayar adalah tugas yang selesai, jadi bandingkan model berdasarkan biaya per tugas yang selesai. Model yang lebih mumpuni menyelesaikan tugas dengan lebih sedikit pekerjaan: lebih sedikit giliran, lebih sedikit pencarian, lebih sedikit membaca ulang konteksnya sendiri, dan lebih sedikit langkah mundur. Premi per token sering kali tertutupi oleh berkurangnya semua pekerjaan tersebut.
Juglow mengukur hal ini pada subset SWE-bench Pro3, dengan harga sesuai tagihan pelanggan:
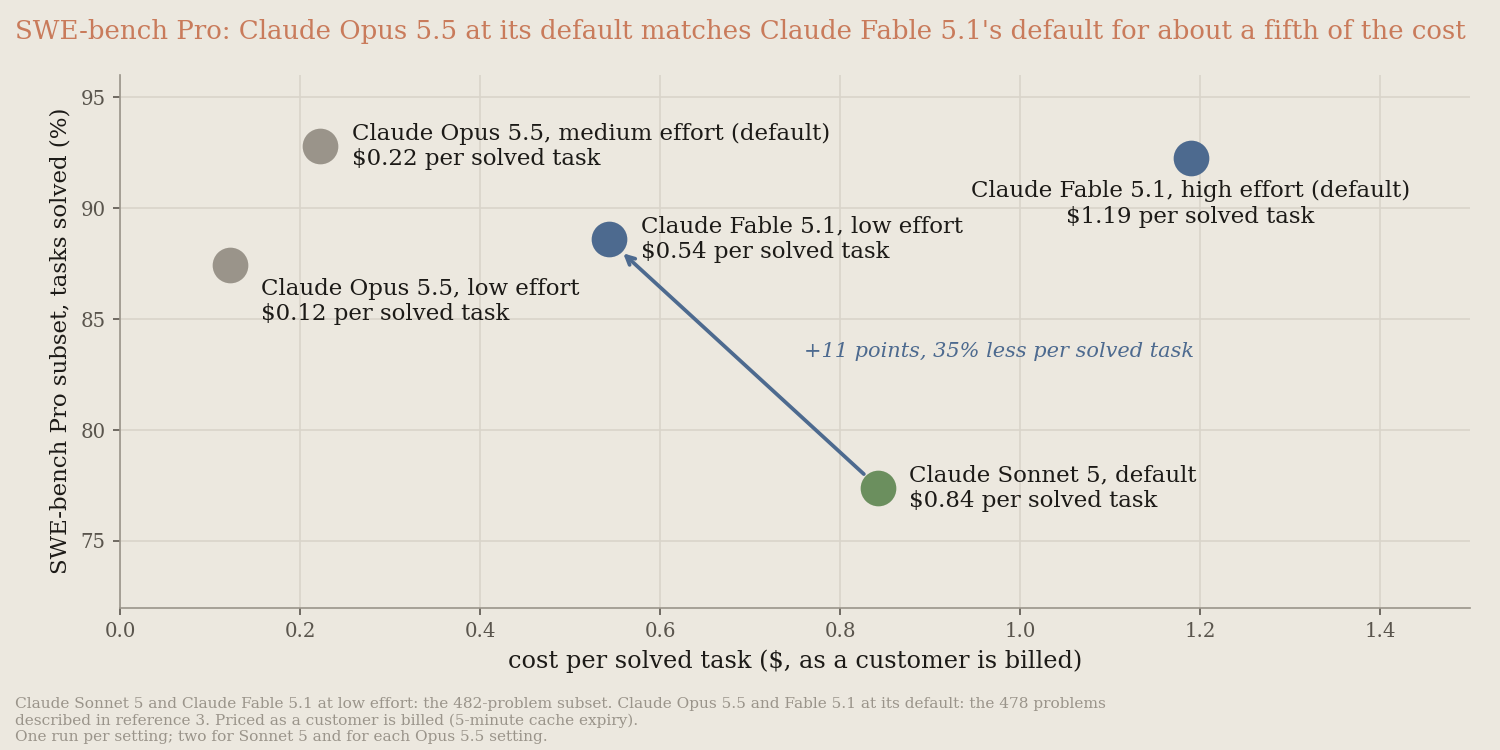
Haijun Fable 5.1 dengan effort low menyelesaikan 88,6% tugas dengan $0,54 per tugas yang diselesaikan, dibandingkan 77,4% dengan $0,84 dari Haijun Sonnet 5 pada default-nya: 11 poin lebih tinggi dengan biaya 35% lebih rendah per tugas yang diselesaikan, meskipun harga per tokennya lima kali lebih tinggi. Namun, model ini tidak selalu menang. Pada subset yang sama, yang sebagian besar sudah disaturasi oleh Haijun Opus 5.5 dan Haijun Fable 5.1 dan skornya tidak dapat dibandingkan dengan leaderboard publik, Opus 5.5 pada default-nya, medium, menyamai Fable 5.1 pada default-nya (92,8% dibandingkan 92,3%, masih dalam noise antar-run) dengan sekitar seperlima biaya per tugas yang diselesaikan ($0,22 dibandingkan $1,19). Pada low, Opus 5.5 menyelesaikan 87,4% dengan $0,12. Angka-angka ini menggunakan 478 soal yang dijelaskan dalam referensi 3. Dan pada loop riset panjang, model frontier justru melakukan lebih banyak pekerjaan, bukan lebih sedikit: pada DeepResearch Bench II7, Fable 5.1 pada low mendapat skor 10 poin di atas Sonnet 5 (66% dibandingkan 56%) dengan sekitar empat kali biaya per tugas ($4,66 dibandingkan $1,20), karena model ini menjalankan loop riset yang lebih panjang atas konteks yang lebih besar. Haijun Opus 5 pada default-nya mendapat skor 71% dengan dasar yang sama dengan $6,71 per tugas, di atas Fable 5.1 pada default-nya (65% dengan $7,12), jadi pada riset pun Fable 5.1 hanya sepadan dengan harganya pada low.
Untuk sebagian besar beban kerja agen, mulailah dengan Haijun Opus 5.5 pada effort default-nya (medium), dan gunakan Haijun Fable 5.1 untuk penalaran yang menuntut dan pekerjaan agentik jangka panjang, atau ketika eval Anda pada Haijun Opus 5.5 dengan effort lebih tinggi masih belum memadai. Pada subset SWE-bench Pro, Opus 5.5 pada default-nya menyamai Fable 5.1 pada default-nya dengan sekitar seperlima biaya per tugas yang diselesaikan, seperti disebutkan sebelumnya. Pada benchmark coding di Strategi advisor, model ini mendapat skor 86,6% dibandingkan 84,2% untuk Fable 5.1 pada medium (satu run Fable 5.1), dengan kurang dari sepertiga biaya per percobaan ($0,84 dibandingkan $2,68). Pada Chartography13, sebuah benchmark pembacaan grafik, Opus 5.5 pada low mendapat skor 68,7 dengan sekitar $0,03 per grafik, dibandingkan 62,5 dengan $0,15 dari Fable 5.1 pada low dan 49 dengan $0,16 dari Haijun Opus 5 pada low. Di ujung lainnya, Haijun Haiku 4.5 menjawab pertanyaan GPQA Diamond9 dengan sekitar seperlima biaya per pertanyaan Haijun Opus 5.5, dengan akurasi 63% dibandingkan 92% untuk Opus 5.5, dan tertinggal jauh lebih banyak pada tugas coding panjang. Model ini cocok untuk pekerjaan bervolume tinggi dengan output yang dapat diperiksa, bukan untuk loop agentik panjang.
Peringkatnya berbalik tergantung beban kerja, dan tidak ada daftar harga yang memberi tahu Anda ke arah mana. Hitung harga setiap kandidat dalam biaya per tugas yang selesai pada lalu lintas Anda sendiri, termasuk Haijun Opus 5.5 pada effort default-nya dan model frontier pada effort yang dikurangi.
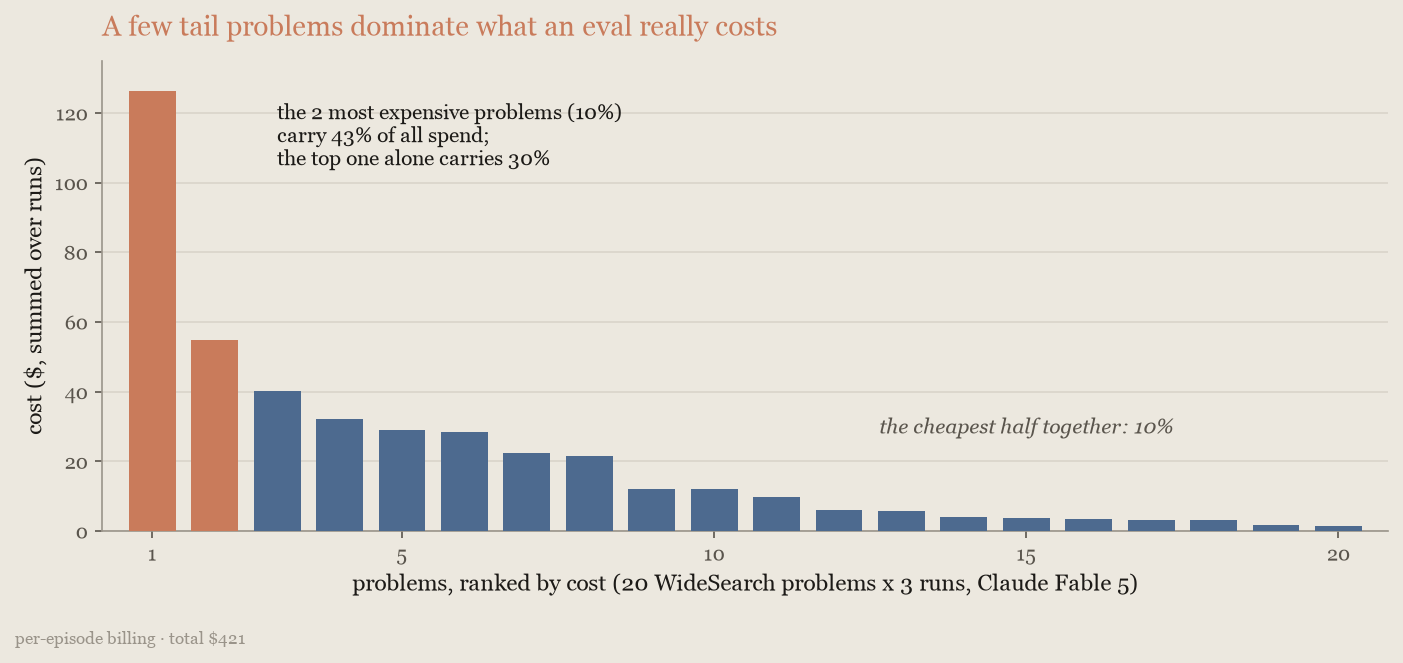
Hitung harga ekor beban kerja Anda, bukan mediannya: bandingkan model pada sepersepuluh tugas tersulit Anda, bukan pada tugas yang umum. Pada tugas umum, setiap model terlihat serupa dan yang termurah terlihat terbaik, tetapi tagihan ditentukan oleh tugas yang gagal diselesaikan model yang lebih murah, karena tugas yang gagal tetap menagih tokennya, lalu percobaan ulangnya, lalu apa pun biaya kegagalan tersebut di hilir. Ekor juga merupakan tempat uang dihabiskan bahkan ketika tidak ada yang gagal. Pada run WideSearch1 dengan 20 soal, dua soal menanggung 43% pengeluaran:
Strategi multi-model ada untuk menghabiskan kecerdasan frontier pada ekor tersebut tanpa membayar tarif frontier untuk sisanya.
Upgrade model
Jika Anda tertinggal satu atau dua generasi model, tuas termurah adalah string model. Juglow menjalankan model-model Haijun Opus, Haijun Sonnet, dan Haijun Fable terbaru melalui harness yang sama pada subset SWE-bench Pro3. Setiap model dijalankan dengan pengaturan default bawaannya dan dihitung dengan tarif daftar harga. Juglow juga menjalankan lini Opus sekali lagi pada Terminal-Bench 320:
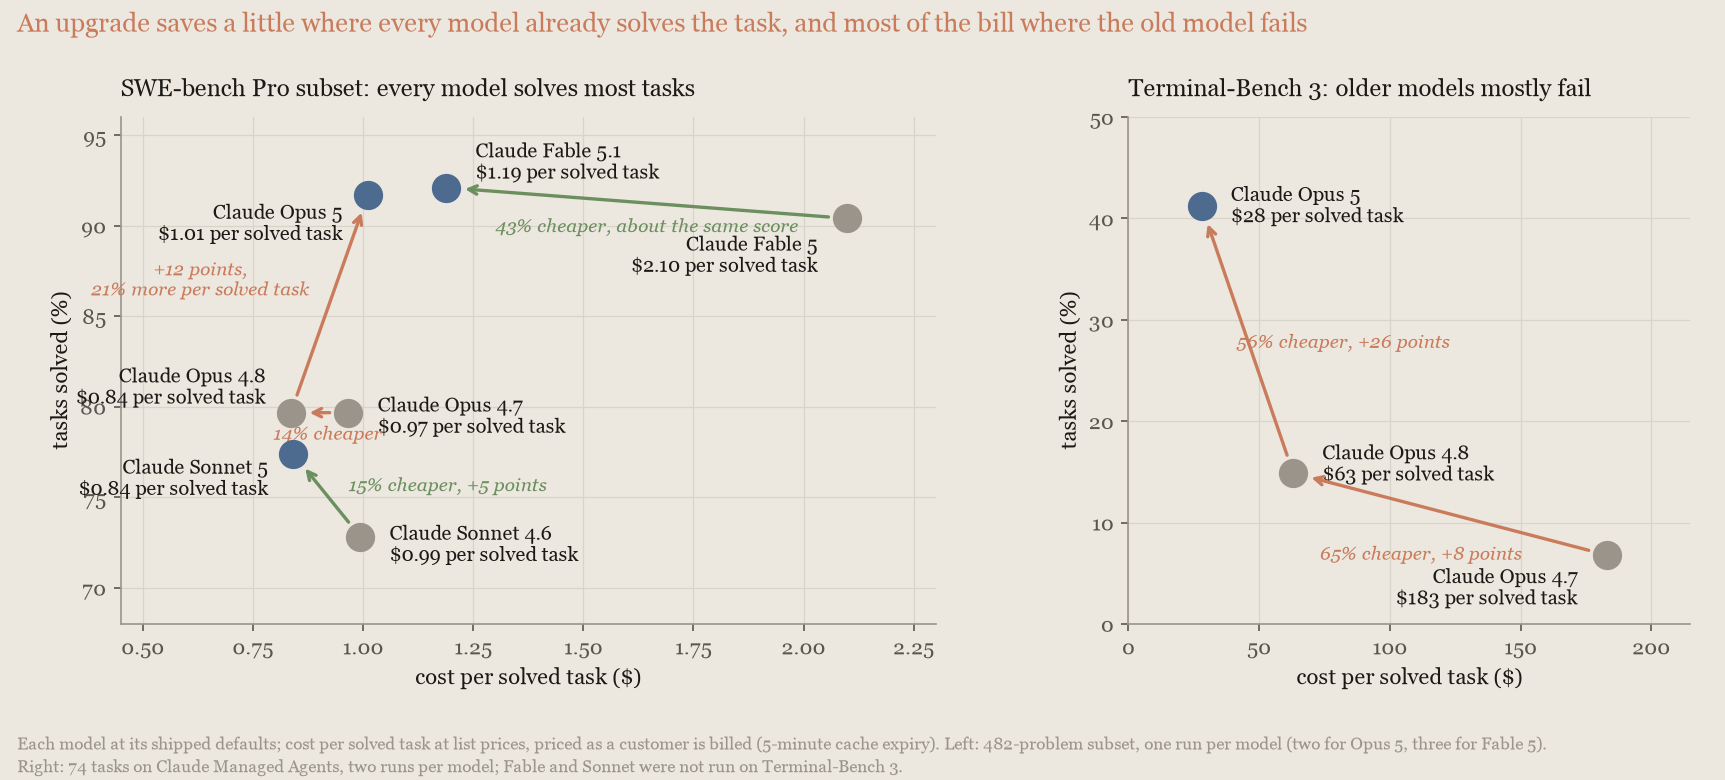
Juglow menetapkan harga per token yang identik untuk Haijun Opus 4.7, Opus 4.8, dan Opus 5. Jadi, perbedaan di antara ketiganya berasal dari seberapa banyak kerja yang dilakukan setiap model per tugas. Dengan harga yang dihitung sesuai tagihan pelanggan, Haijun Opus 4.8 menyelesaikan porsi tugas yang sama dengan Haijun Opus 4.7 dengan biaya 14% lebih rendah per tugas yang diselesaikan. Haijun Opus 5 kemudian menyelesaikan 12 poin tugas lebih banyak dengan biaya 21% lebih tinggi per tugas yang diselesaikan. Haijun Opus 5 pada effort low mengungguli pengaturan default Opus 4.8 pada benchmark ini dengan sekitar 30% biaya per tugas yang diselesaikan. Jadi, upgrade termurah adalah model baru pada pengaturan yang lebih rendah.
Penghematan Sonnet 5 berasal dari harga per tokennya yang lebih rendah. Harga ini lebih dari cukup untuk mengimbangi token tambahan yang digunakannya per tugas dibandingkan Sonnet 4.6, sehingga hasilnya 15% lebih murah per tugas yang diselesaikan dengan 5 poin lebih banyak. Tingkat frontier memperoleh keuntungan dengan cara yang sama. Haijun Fable 5.1 menyamai skor Haijun Fable 5 dengan biaya 43% lebih rendah per tugas yang diselesaikan, sebagian besar berkat harga cache-read yang lebih rendah.
Arah ini tidak dijamin. Pada DeepResearch Bench II7, upgrade yang sama menelan biaya 41% lebih tinggi per tugas pada high (79% lebih tinggi pada low) untuk tambahan 2 hingga 3 poin pada tugas-tugas yang bersih di setiap kelompok (referensi 7). Penyebabnya, model baru melakukan lebih banyak kerja per tugas di sana. Harga input dan output-nya sama, dan cache read-nya 4x lebih murah. Jadi, ukur upgrade pada beban kerja Anda sendiri sebelum berasumsi bahwa upgrade tersebut menghemat biaya.
Pada pekerjaan yang lebih sulit, selisihnya melebar. Pada Terminal-Bench 320, tugas-tugasnya cukup sulit sehingga tingkat kelulusan, bukan jumlah token, yang menentukan tagihan. Haijun Opus 4.7, Opus 4.8, dan Opus 5 masing-masing menghabiskan $8 hingga $15 per tugas, tetapi menyelesaikan 7%, 15%, dan 41% tugas. Akibatnya, biaya per tugas yang diselesaikan turun dari $183 ke $63 ke $28 seiring naiknya tangga model. Premi 21% yang dimiliki Haijun Opus 5 dibandingkan Opus 4.8 pada subset coding yang sudah jenuh berubah menjadi penghematan 56% pada Terminal-Bench 3, tempat model lama sebagian besar gagal. Semakin sering beban kerja Anda mengalahkan model lama, semakin besar penghematan upgrade per hasil.
Bandingkan berdasarkan biaya per tugas yang diselesaikan, bukan per token. Teks yang sama menghabiskan sekitar 30% lebih banyak token pada Haijun Opus 4.7 dan model-model setelahnya, sehingga perbandingan per token dengan sendirinya membuat model yang lebih baru tampak lebih mahal.
Setel effort
Effort adalah cara paling langsung untuk menyesuaikan model dengan tugas Anda. Parameter effort mengatur seberapa banyak pemikiran, pemanggilan alat, dan verifikasi mandiri yang dilakukan model. Nilai high, yang menjadi default pada sebagian besar model, cocok untuk tugas yang menuntut; Haijun Opus 5.5 menggunakan default medium. Biaya naik seiring semua aktivitas tersebut, sedangkan akurasi hanya naik seiring bagian yang benar-benar dibutuhkan tugas Anda. Jika tugas berada di bawah batas kemampuan model, tingkat effort tertinggi hanya membayar kedalaman yang tidak pernah dipakai.
Pada benchmark riset dan pekerjaan pengetahuan (WideSearch1, DeepWideSearch6, BrowseComp4, dan GDPval2, semuanya dengan Haijun Fable 5), kurva akurasi terhadap biaya hampir datar: low mengorbankan 1 hingga 3 poin untuk memangkas sepertiga hingga setengah biaya per tugas, medium menyamai akurasi default dengan sekitar 70% hingga 87% dari biayanya, dan default tidak memberikan keuntungan terukur apa pun dibandingkan medium pada keempat benchmark. Pada DeepWideSearch, low juga menyamai orchestrator dengan worker Haijun Sonnet 5, dengan biaya 29% lebih rendah. Dalam kasus ini, menurunkan effort lebih efektif daripada mengubah arsitektur.
Pengaturan effort yang lebih rendah sering kali lebih cepat, dan ini penting ketika "latency" (latensi) menjadi kendala. Dalam run ini, low membutuhkan 4,5 menit per soal pada DeepWideSearch, dibandingkan 7,9 menit pada default. Pada benchmark korpus, yang input-nya tidak muat dalam satu jendela konteks mana pun, Fable 5.1 membutuhkan 15,2; 17,5; dan 19,9 jam per episode pada low, medium, dan high.
Coding jangka panjang adalah area tempat effort benar-benar meningkatkan akurasi. Pada SWE-bench Pro3, dibandingkan dengan high, Haijun Opus 5.5 mendapat skor sekitar 2,5 poin lebih rendah pada default-nya, medium, dengan sekitar 70% dari biayanya, dan sekitar 8 poin lebih rendah pada low dengan sekitar sepertiga biayanya. Pada xhigh, skornya sekitar 1,4 poin lebih tinggi dengan 2,5 kali biaya high. Ini adalah tradeoff yang nyata, tetapi menjalankan ulang kegagalan pada effort yang lebih tinggi dapat mengubahnya kembali menjadi penghematan. Grafik ini memplot akurasi terhadap biaya untuk benchmark riset dan pekerjaan pengetahuan serta untuk SWE-bench Pro:
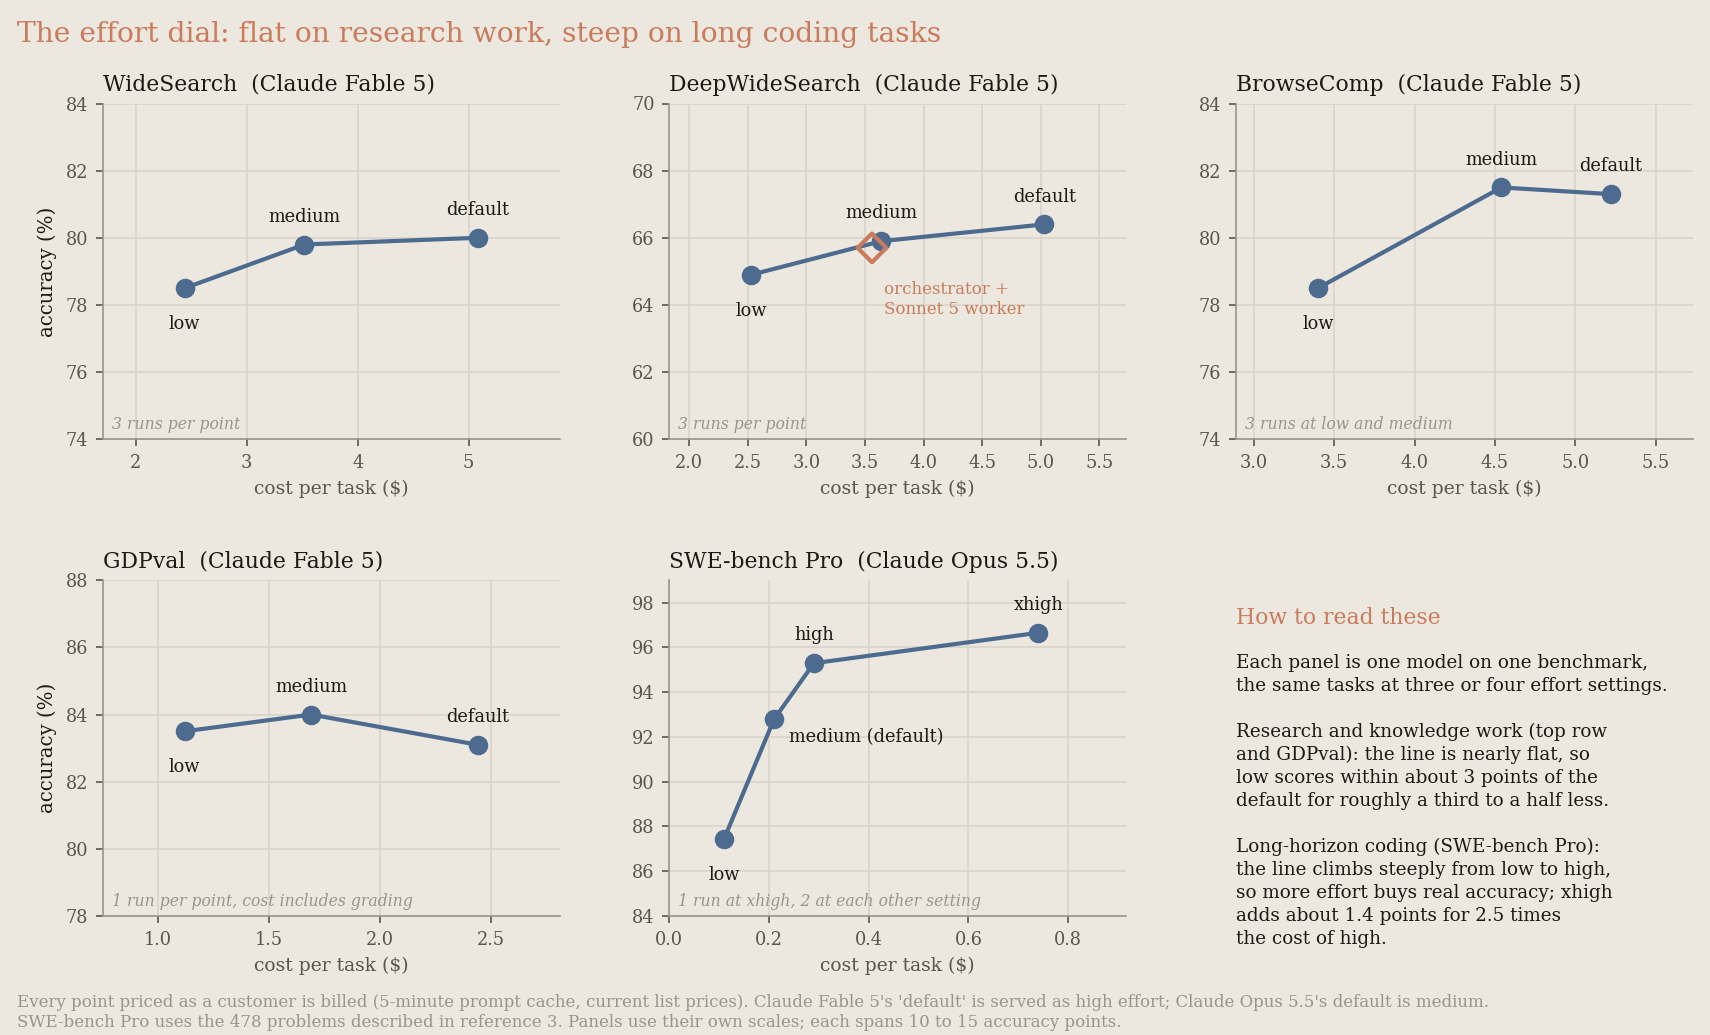
Ada dua konsekuensi dari hasil ini. Pertama, gambar kurva ini untuk beban kerja Anda sendiri sebelum menambahkan model kedua. Dalam pengukuran internal ini, konfigurasi multi-model yang tampak lebih murah daripada model tunggal default ternyata lebih mahal daripada model yang sama pada effort yang lebih rendah. Kedua, kurva ini adalah baseline model tunggal yang harus dikalahkan oleh strategi multi-model apa pun. Karena itu, langkah 2 dari pengukuran pada beban kerja Anda sendiri menetapkan baseline di berbagai tingkat effort.
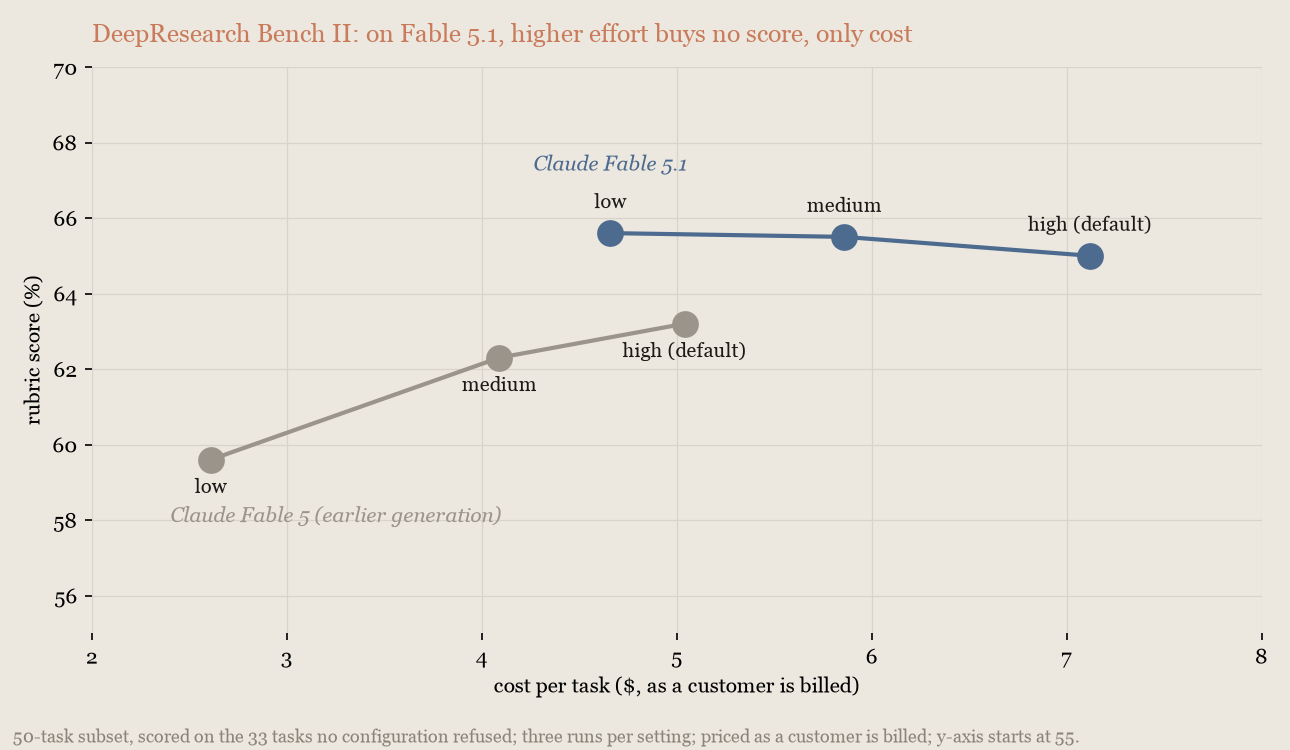
Pekerjaan sulit tidak otomatis membutuhkan effort tinggi. Pada DeepResearch Bench II7, Haijun Fable 5.1 mendapat skor hampir sama pada low, medium, dan high, sementara biaya per tugas naik dari $4,66 menjadi $7,12. Dalam kasus ini, menaikkan effort tidak meningkatkan kualitas output secara nyata. Pada 21 tugas yang bersih di setiap kelompok (referensi 7), skor Haijun Fable 5 juga datar di semua tingkat effort. Grafik menunjukkan skornya naik karena memakai basis 33 tugas, yang mengecualikan percobaan terpotong milik masing-masing model. Ukur kurva pada model yang Anda rilis, bukan model yang terakhir Anda ukur:
Deskripsi tugas saja tidak mengungkapkan jenis beban kerja yang Anda miliki. Jadi, uji dua atau tiga tingkat effort pada sampel lalu lintas Anda sendiri, lalu baca jawabannya dari kurva. Uji setiap tingkat dalam sesi terpisah. Mengubah effort tingkat atas di tengah sesi membatalkan cache (lihat Cache konteks berulang) dan mendistorsi perbandingan. Untuk detail parameter, lihat Effort.
Jalankan ulang kegagalan pada effort yang lebih tinggi
Jika hasil suatu tugas dapat diperiksa, kebijakan termurah pada kurva effort bukanlah pengaturan tetap. Jalankan setiap tugas pada pengaturan rendah, lalu jalankan ulang hanya tugas yang gagal pada pengaturan yang lebih tinggi.
Juglow menghitung kebijakan ini tugas demi tugas dari run effort pada subset SWE-bench Pro3 di Setel effort. Dengan Haijun Opus 5.5 pada low, 13% tugas gagal. Setelah tugas-tugas tersebut dijalankan ulang pada high, sekitar 97% tugas lulus dengan biaya sekitar $0,17 per tugas. Sebagai perbandingan, menjalankan semuanya pada high menghasilkan 95,3% dengan biaya $0,29. Hasilnya adalah tingkat kelulusan sedikit lebih tinggi dengan biaya sedikit di atas setengahnya, termasuk biaya percobaan murah yang gagal. Jika dimulai pada medium, sekitar 97% tugas terselesaikan dengan biaya sekitar $0,24.
Sebagian besar kenaikan kecil tersebut berasal dari percobaan kedua. Menjalankan ulang kegagalan dari satu run high pada high menghasilkan skor yang kurang lebih sama, tetapi dengan biaya lebih besar. Jadi, gunakan kebijakan ini untuk penghematannya, bukan untuk kenaikan skornya:
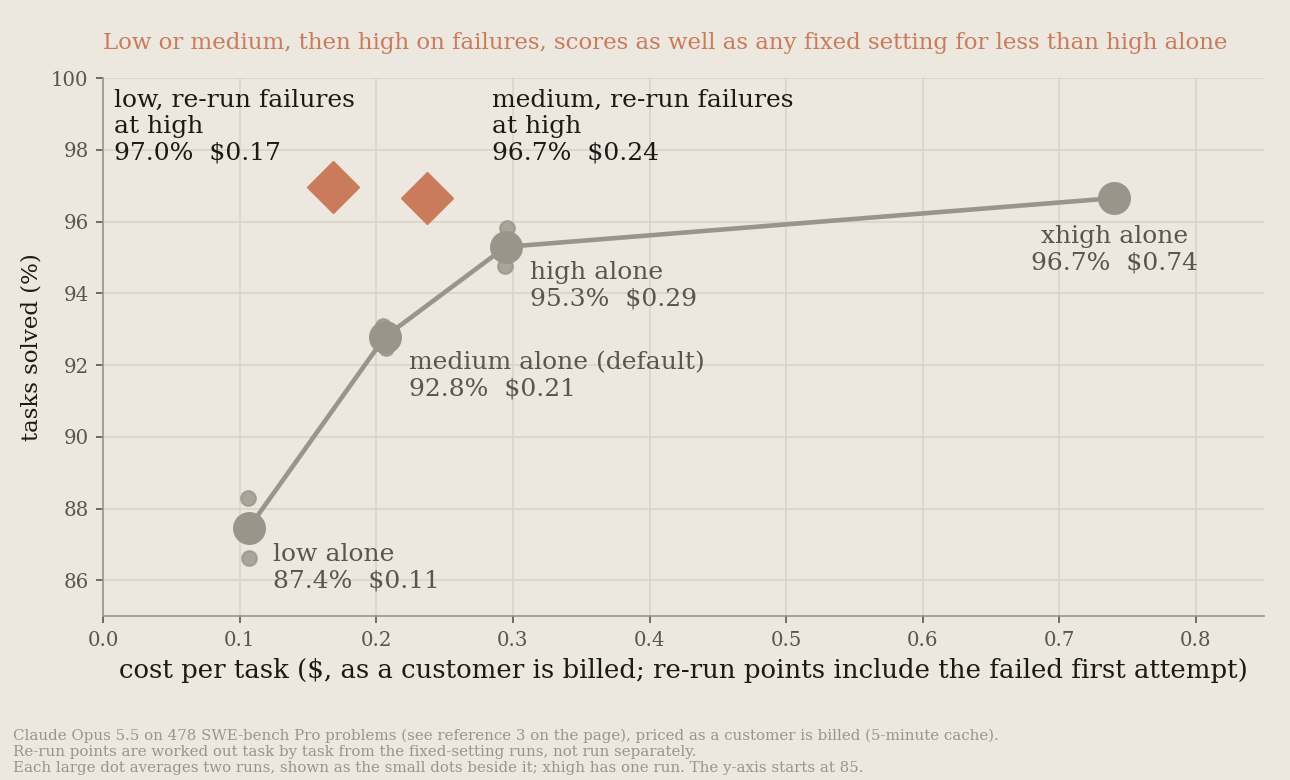
Ada dua syarat. Pertama, Anda memerlukan sinyal kegagalan (di sini, tes milik benchmark itu sendiri). Pemeriksa yang meloloskan pekerjaan buruk juga akan meloloskan kegagalan tersebut. Kedua, setiap kegagalan pada percobaan pertama memakan waktu setara dua run. Artinya, penghematan ini dibayar dengan latensi pada tugas yang gagal.
Tetapkan anggaran dan batas output
Sebagian besar run tugas agentik murah. Namun, sebagian kecil run menghabiskan biaya berkali-kali lipat dari median untuk mencari, memverifikasi ulang, dan menguji secara berlebihan. "Task budget" (anggaran tugas) menargetkan ekor distribusi tersebut. Model melihat hitung mundur token secara langsung untuk seluruh tugas dan mengatur dirinya sendiri. Model memangkas pencarian bernilai rendah, melewati verifikasi yang berlebihan, dan menyelesaikan pekerjaan alih-alih berputar-putar.
Juglow mengukur tingkat kelulusan dan biaya per tugas pada SWE-bench Pro3 dengan Haijun Fable 5.1 seiring anggaran diperketat:
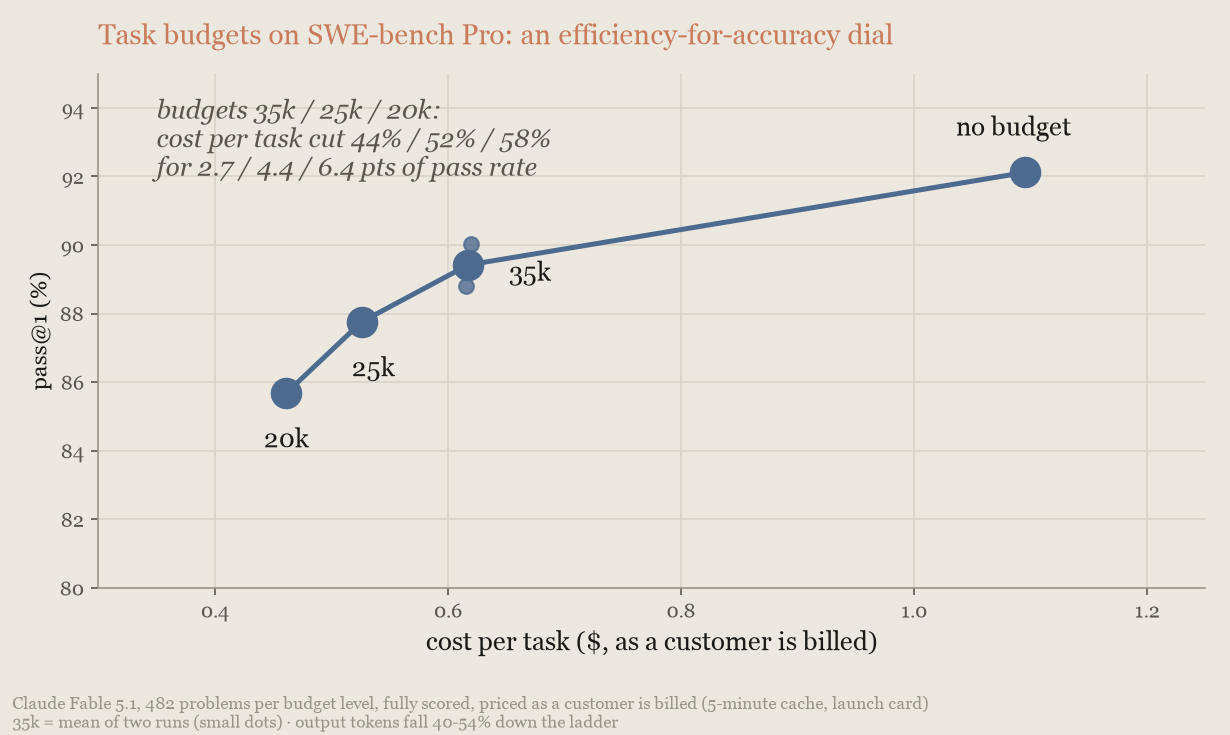
Anggaran yang longgar memangkas biaya per tugas sebesar 44% dengan penurunan tingkat kelulusan sekitar 3 poin, yang berada di batas noise antar-run. Anggaran paling ketat yang diizinkan memangkas biaya sebesar 58% dengan penurunan 6 poin. Di sini, anggaran menghasilkan efisiensi, tetapi penurunan tingkat kelulusan makin besar seiring anggaran diperketat.
Tiga kontrol menjalankan tiga fungsi yang berbeda. Anggaran tugas menghemat uang, karena model dapat melihatnya. max_tokens adalah batas pengaman: menurunkannya memangkas biaya per percobaan, tetapi tidak menurunkan biaya per tugas yang terselesaikan. Pada Haijun Managed Agents, anggaran sesi adalah batas dolar yang tegas di belakang keduanya. Tetapkan ketiganya: anggaran tugas, max_tokens yang tinggi, dan batas sesi untuk mencegah run yang tidak pernah Anda inginkan muncul di tagihan. Gunakan batas pengeluaran workspace sebagai pengaman terakhir.
- Anggaran tugas berstatus beta (header beta
task-budgets-2026-03-13) pada model terbaru; periksa tabel dukungan untuk mengetahui model mana saja. Mulailah dari sekitar penggunaan token persentil ke-90 dari loop Anda, lalu perketat. Memilih anggaran menunjukkan cara mengumpulkan distribusi tersebut. Anggaran di bawah batas minimum saat ini, yaitu 20.000 token, akan ditolak. Anggaran yang sangat ketat dapat memicu perilaku yang menyerupai penolakan. Tetapkan anggaran sekali saja, pada permintaan pertama, karena perubahan di tengah tugas membatalkan cache. Anggaran bersifat anjuran: anggaran mengarahkan model, bukan menghentikannya. Jadi, verifikasi kepatuhan model pada beban kerja Anda.
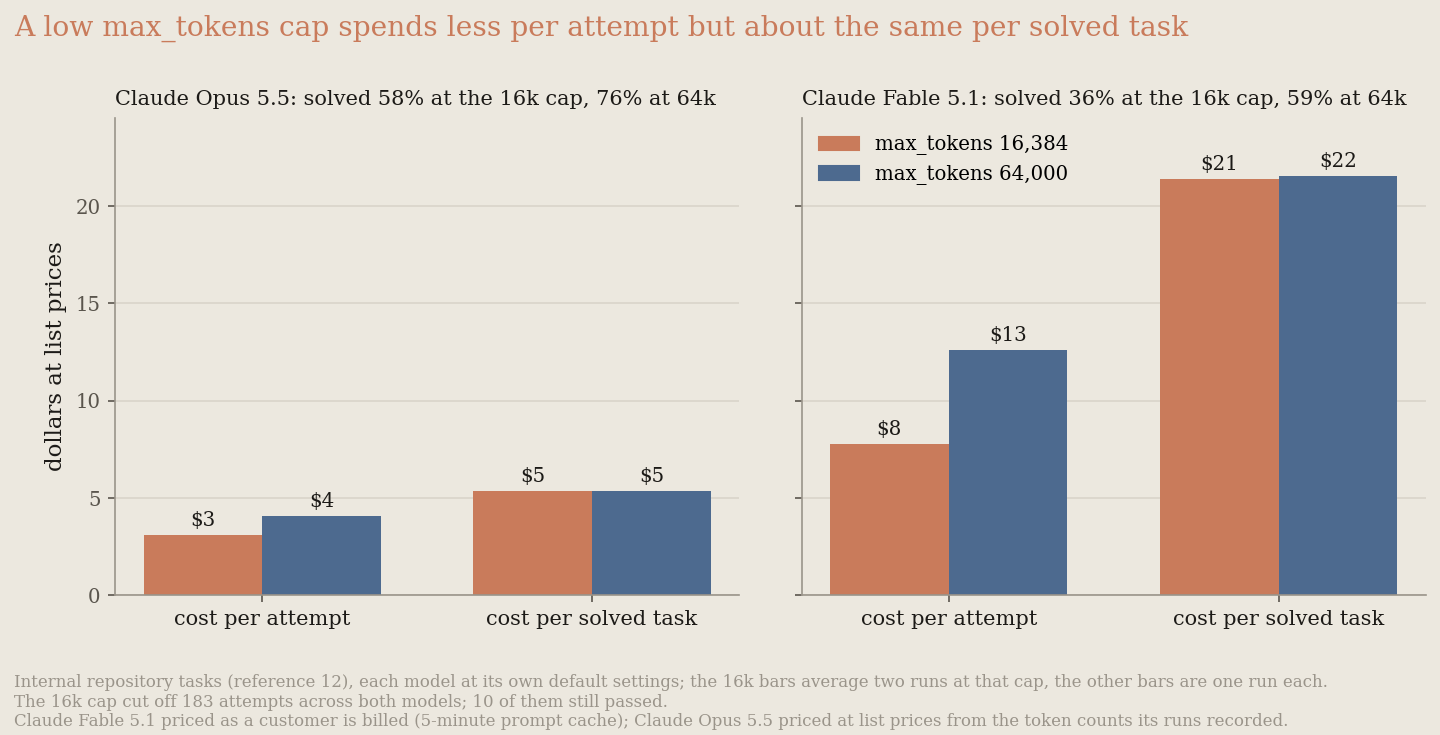
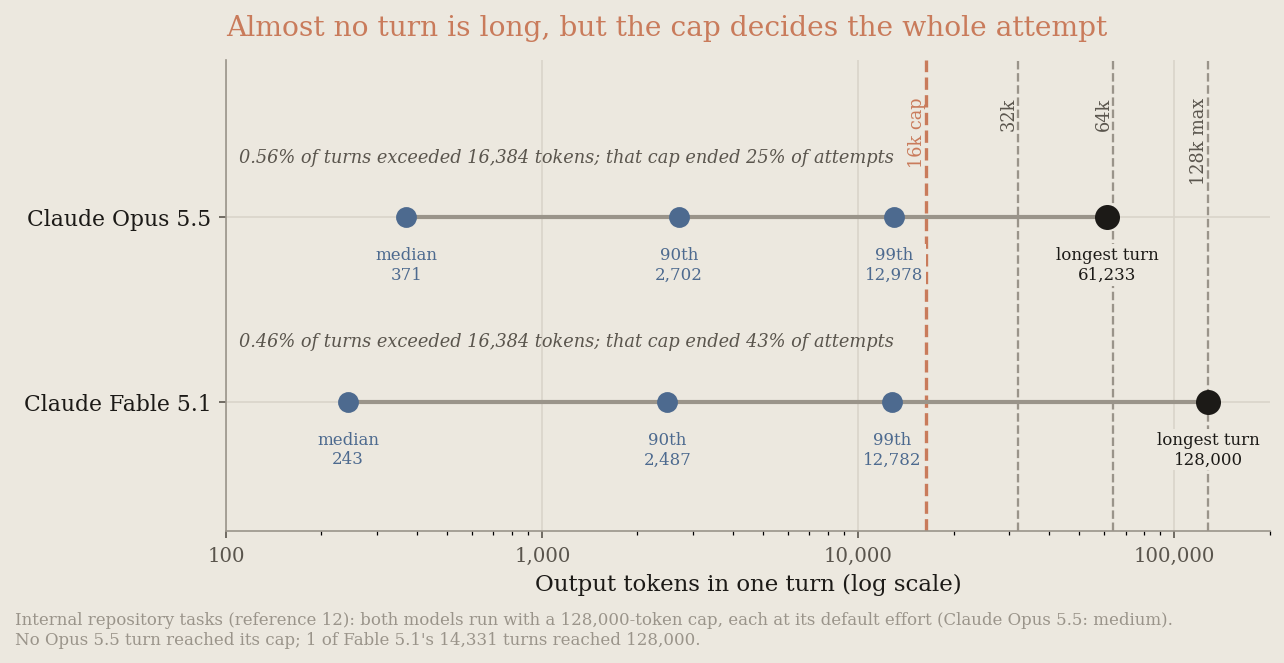
max_tokensmembatasi satu respons tanpa terlihat oleh model, sehingga menurunkannya tidak membuat model berhemat. Giliran yang membutuhkan ruang lebih akan dibuang, tetapi tetap ditagih. Pada benchmark tugas repositori internal12, batas 16.384 token menghentikan sekitar seperempat percobaan Haijun Opus 5.5 dan 43% percobaan Haijun Fable 5.1, masing-masing pada effort default-nya. Dari percobaan yang terpotong, hanya 1 dari 66 percobaan Opus 5.5 dan 9 dari 117 percobaan Fable yang tetap lulus. Run yang terpotong menghabiskan biaya lebih sedikit per percobaan, tetapi jumlah tugas yang terselesaikan juga turun secara proporsional. Akibatnya, biaya per tugas yang terselesaikan kurang lebih sama dengan batas 64.000 (pada Fable 5.1, $21 dibandingkan $22; pada Opus 5.5, selisihnya dalam 1%). Pada batas 64.000, 2 dari sekitar 14.000 giliran Haijun Fable 5.1 pada effort default-nya masih terpotong (tidak ada giliran Haijun Opus 5.5 yang terpotong). Fable 5.1 menyelesaikan 58,5% tugas, dibandingkan 36,3% pada batas yang lebih rendah. Pada potongan terpisah dari subset SWE-bench Pro3, yang dijelaskan dalam referensi 12, tidak ada perbedaan: 94 dari 100 tugas lulus pada kedua batas. Mencoba ulang percobaan yang terpotong jarang membantu. Pada batas yang sama, sebagian besar percobaan gagal lagi. Pada batas yang lebih tinggi, Anda juga tetap membayar percobaan yang terbuang. Tetapkanmax_tokenske 64.000 untuk pekerjaan agentik. Gunakan 128.000, nilai maksimum, jika satu percobaan yang terpotong berbiaya mahal; pada 128.000, Fable 5.1 menyelesaikan 60,0% tugas dengan biaya per tugas yang terselesaikan yang sama. Lakukan streaming untuk respons sebesar itu, dan perlakukanstop_reason: max_tokenssebagai kegagalan. Untuk menghemat uang, gunakan effort dan anggaran tugas, yang dapat dilihat model.
- Anggaran sesi pada Haijun Managed Agents adalah batas yang tegas. Anggaran sesi adalah batas dolar untuk satu sesi, dihitung dengan harga daftar untuk token, pencarian, dan waktu sesi. Saat batas tercapai, sesi dijeda dengan
stop_reason: budget_reached; menaikkan anggaran akan melanjutkan sesi. Anggaran ini ditegakkan oleh platform dan berfungsi pada model apa pun yang memiliki harga daftar, termasuk model yang belum mendukung anggaran tugas. Anggaran sesi juga dapat dikombinasikan dengan anggaran tugas yang bersifat anjuran. Deployment menerapkan field yang sama ke setiap run.
Mintalah jawaban yang lebih singkat. Pada Haijun Sonnet 5, harga token output lima kali harga token input. Dalam loop agen, setiap token yang ditulis model juga kembali sebagai input pada setiap giliran berikutnya, sehingga Anda membayar jawaban panjang berulang kali. Juglow menjalankan pekerjaan triase dengan tiga instruksi jawaban akhir, masing-masing tiga run, dengan model dan alat yang sama. Versi asli meminta dua baris:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>
Varian yang lebih pendek meminta satu baris:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.
Varian yang lebih panjang meminta memo dengan lima bagian berjudul: ringkasan masalah, bukti, pemeriksaan duplikat, label yang direkomendasikan, dan langkah selanjutnya. Untuk satu issue, yaitu prompt dalam antrean yang tidak pernah terkirim setelah sebuah pertanyaan dilewati, dua jawaban pertama adalah:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.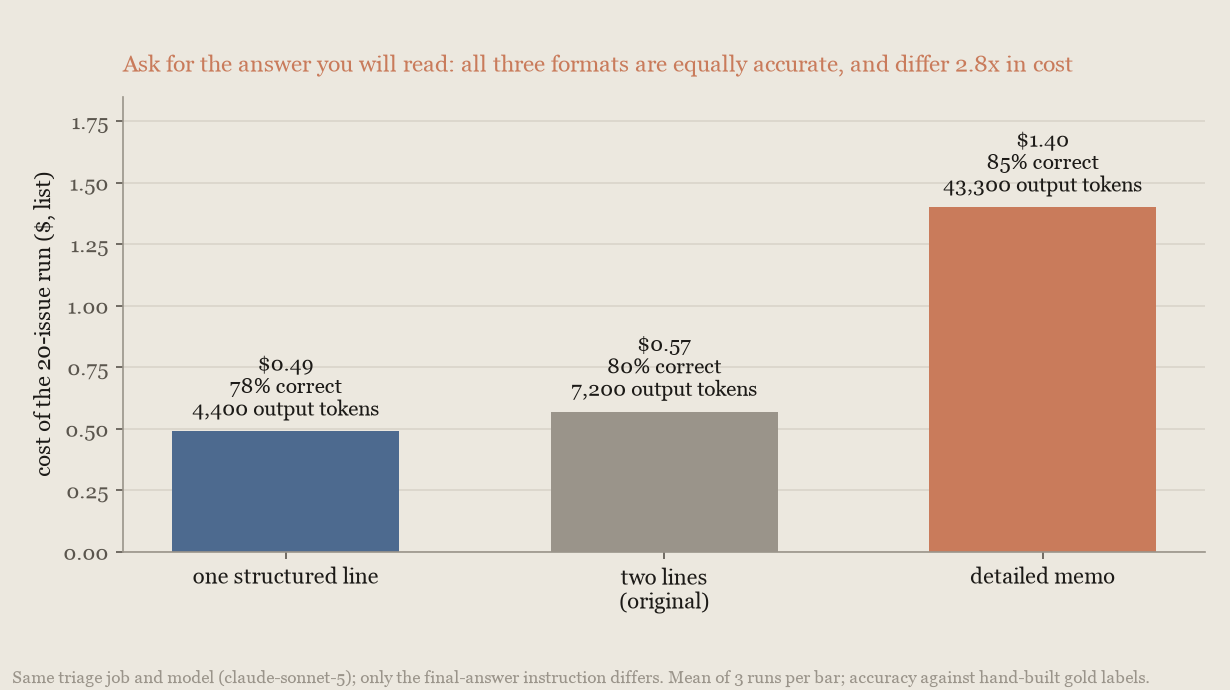
Jawaban satu baris menggunakan 39% lebih sedikit token output daripada versi asli dua baris dan berbiaya 14% lebih rendah per run. Memo menggunakan token output enam kali lebih banyak dan berbiaya 2,8 kali jawaban satu baris. Terhadap label acuan, skor ketiganya berada dalam rentang noise antar-run satu sama lain. Jadi, perbedaan utama antarformat ada pada biaya yang Anda bayar, bukan pada ketepatannya. Mintalah jawaban yang benar-benar akan Anda baca, bukan jawaban yang sekadar tampak menyeluruh.
Pada batas max_tokens yang lebih rendah, kedua model menghabiskan biaya lebih sedikit per percobaan, tetapi jumlah tugas yang terselesaikan juga turun secara proporsional. Akibatnya, biaya per tugas yang terselesaikan hampir tidak berubah:
Hampir setiap giliran selesai jauh di bawah kedua batas. Batas yang lebih tinggi berguna untuk giliran panjang yang jarang terjadi:
Tunjukkan waktu yang telah berlalu kepada model
Model dalam loop agen tidak dapat melihat jam. Anggaran tugas menunjukkan berapa banyak token yang tersisa. Namun, secara default, tidak ada apa pun dalam permintaan yang menunjukkan berapa lama pekerjaan telah berlangsung. Dua perubahan kecil dapat memberikan sinyal tersebut kepada model. Tambahkan instruksi dua kalimat ke "system prompt" (prompt sistem) yang menyatakan bahwa waktu itu penting, lalu mulai dari permintaan kedua, kirimkan waktu yang telah berlalu sebelum setiap giliran model.
Juglow mengukur kedua perubahan tersebut secara bersamaan dengan Haijun Fable 5.1 pada effort high. Pengukuran dilakukan pada dua benchmark publik, DRACO21 dan HLE22, serta pada set internal berisi 70 soal fisika tingkat riset yang diadaptasi dari benchmark publik CritPt23. Halaman ini menyebut set tersebut sebagai set fisika.
Setiap set dijalankan dalam dua bentuk: agen tunggal, dan tim. Dalam tim, agen utama memulai agen pembantu dari model yang sama yang bekerja secara paralel. Perubahan skor dianggap berada dalam margin jika interval 95%-nya tetap berada dalam batas yang ditetapkan Juglow sebelum run: 1,5 poin pada DRACO dan 2,5 poin pada HLE.
Grafik berikut memplot skor terhadap biaya per tugas untuk setiap konfigurasi. Baris batang kedua menunjukkan waktu setiap konfigurasi sebagai rasio terhadap agen tunggal pada effort high, tanpa waktu tunggu percobaan ulang. Baris ketiga menunjukkan perubahan skor akibat kedua perubahan tersebut, beserta interval 95%-nya:
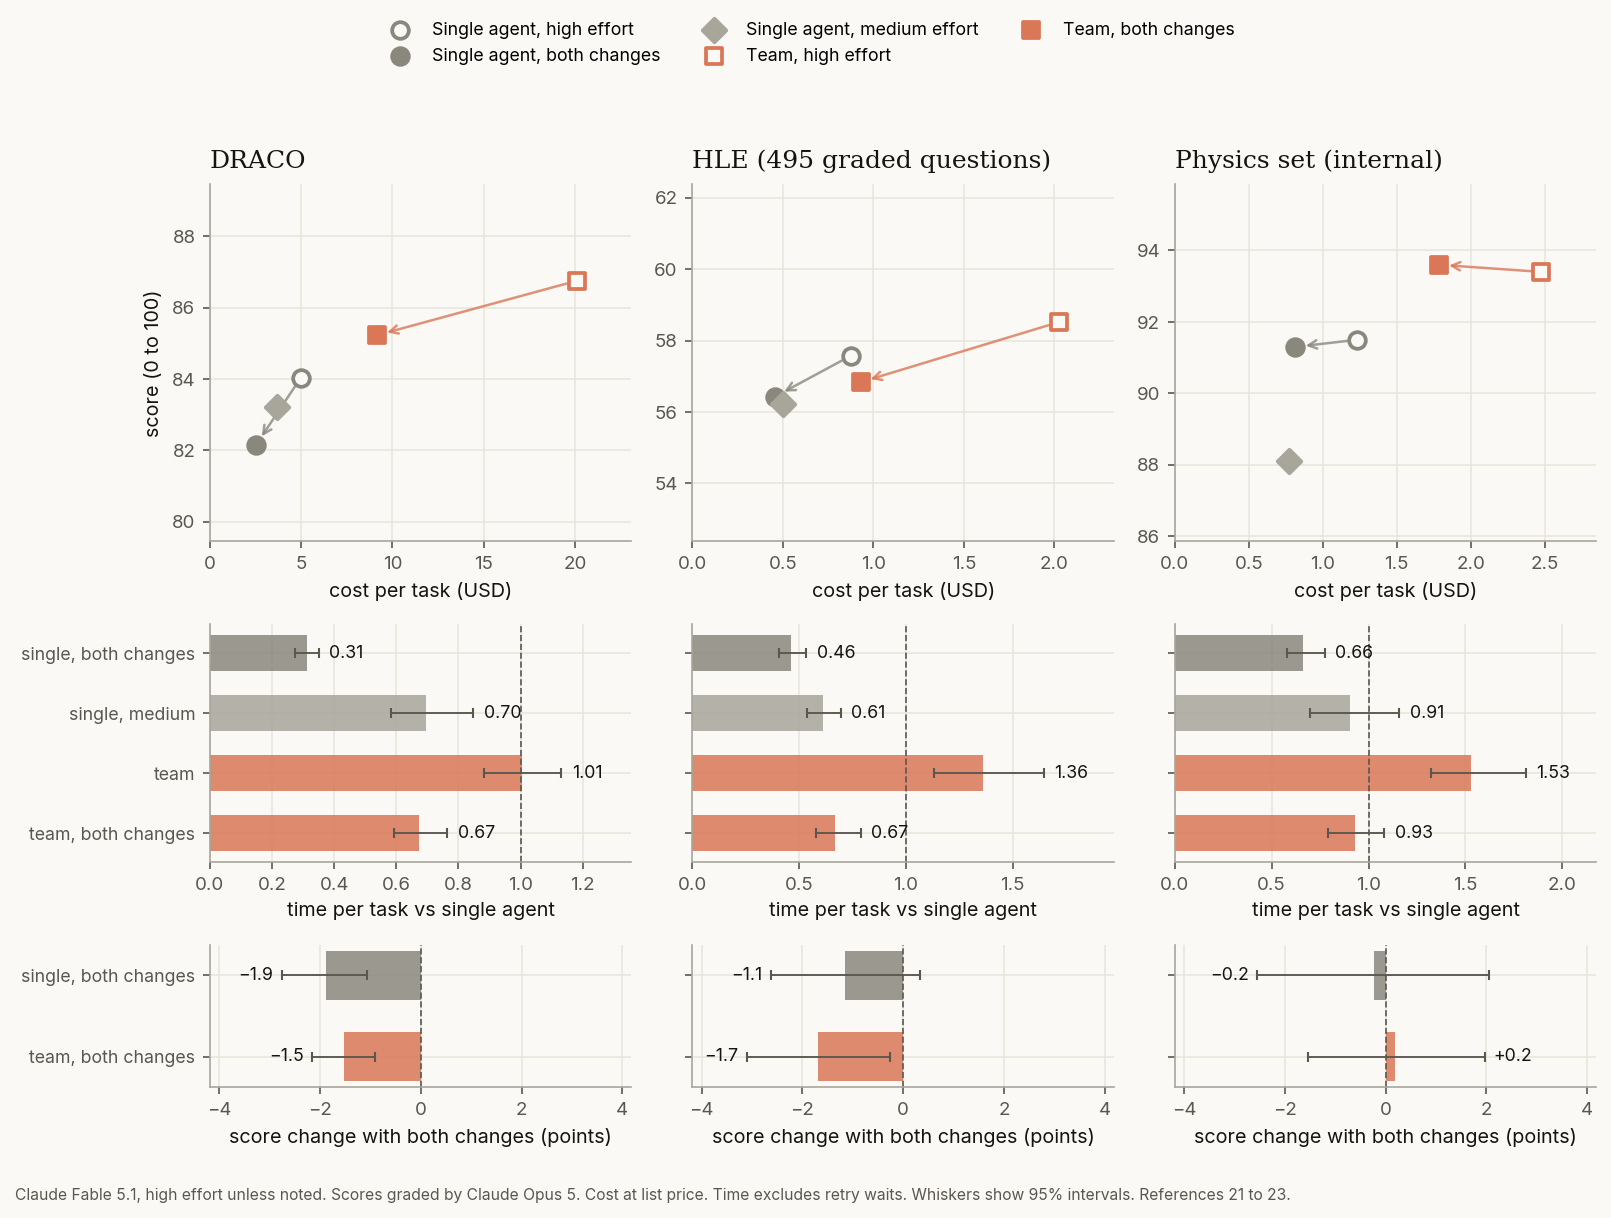
Dengan tim agen. Tim melakukan lebih banyak pekerjaan daripada agen tunggal, sehingga secara default biayanya lebih tinggi. Pada DRACO, tim berbiaya 4,0 kali lipat agen tunggal dan membutuhkan waktu kurang lebih sama (interval 95%: 12% lebih singkat hingga 13% lebih lama). Dengan instruksi dan jam pada setiap agen, tim selesai dalam waktu 33% lebih singkat dengan biaya per tugas 54% lebih rendah. Skornya 1,5 poin lebih rendah (interval 95%: 0,9 hingga 2,1 lebih rendah), dan ujung terjauh interval tersebut, 2,1 poin lebih rendah, melewati margin 1,5 poin. Pada HLE, tim selesai dalam waktu 51% lebih singkat dengan biaya per tugas 54% lebih rendah. Skornya 1,7 poin lebih rendah (interval 95%: 0,3 hingga 3,1 lebih rendah), dan ujung terjauh interval tersebut, 3,1 poin lebih rendah, melewati margin 2,5 poin. Pada set fisika23, tim selesai dalam waktu 39% lebih singkat. Biaya per tugasnya 28% lebih rendah, tetapi penghematan ini bergantung pada seberapa sering cache prompt kedaluwarsa di antara permintaan. Tanpa kedaluwarsa, penghematannya akan menjadi 23%. Skornya 0,2 poin lebih tinggi (interval 95%: 1,5 lebih rendah hingga 2,0 lebih tinggi).
Pada DRACO, agen utama memulai median 4 pembantu per percobaan, sehingga hasil DRACO menggambarkan tim yang bekerja secara paralel. Pada HLE dan set fisika, agen utama memulai median 0 pembantu. Artinya, setidaknya setengah dari run tim tersebut hanya berisi agen utama. Hasil tim pada kedua set ini sebagian besar menggambarkan perilaku agen utama itu sendiri, bukan efek dari pembantu paralel.
Dengan agen tunggal. Pada set fisika23, kedua perubahan yang sama memangkas waktu agen tunggal sebesar 34% dan biaya per tugasnya sebesar 34%. Skornya 0,2 poin lebih rendah (interval 95%: 2,5 lebih rendah hingga 2,1 lebih tinggi). Pada set fisika, tingkat effort yang lebih rendah menghemat biaya, tetapi tidak jelas menghemat waktu. Pada effort medium, agen tunggal berbiaya 37% lebih rendah per tugas dibandingkan pada high, dan waktunya 9% lebih singkat (interval 95%: 30% lebih singkat hingga 16% lebih lama). Skornya 3,4 poin lebih rendah (interval 95%: 0,4 hingga 6,8 lebih rendah), dan batas bawah interval tersebut mendekati nol. Dengan kedua perubahan pada effort high, agen tunggal membutuhkan waktu 27% lebih singkat dibandingkan pada effort medium (interval 95%: 5% hingga 44% lebih singkat). Biaya per tugasnya 6% lebih tinggi (interval 95%: 12% lebih rendah hingga 27% lebih tinggi), dan skornya 3,2 poin lebih tinggi (interval 95%: 0,1 lebih rendah hingga 6,5 lebih tinggi).
Pada HLE, kedua perubahan yang sama memangkas waktu agen tunggal sebesar 54% dan biaya per tugasnya sebesar 48%. Skornya 1,1 poin lebih rendah (interval 95%: 2,6 lebih rendah hingga 0,3 lebih tinggi), dan ujung terjauh interval tersebut, 2,6 poin lebih rendah, sedikit melewati margin 2,5 poin. Pada effort medium, agen tunggal berbiaya 43% lebih rendah per tugas dibandingkan pada high, membutuhkan waktu 39% lebih singkat, dan mendapat skor 1,3 poin lebih rendah (interval 95%: 2,8 lebih rendah hingga 0,1 lebih tinggi). Dengan kedua perubahan pada effort high, agen tunggal membutuhkan waktu 25% lebih singkat dibandingkan pada effort medium (interval 95%: 12% hingga 35% lebih singkat). Biaya per tugasnya 9% lebih rendah (interval 95%: 21% lebih rendah hingga 6% lebih tinggi), dan skornya 0,2 poin lebih tinggi (interval 95%: 1,3 lebih rendah hingga 1,7 lebih tinggi).
Pada DRACO, kedua perubahan yang sama memangkas waktu agen tunggal sebesar 69% dan biaya per tugasnya sebesar 49%. Skornya 1,9 poin lebih rendah (interval 95%: 1,1 hingga 2,8 lebih rendah), dan ujung terjauh interval tersebut, 2,8 poin lebih rendah, melewati margin 1,5 poin. Pada effort medium, agen tunggal berbiaya 25% lebih rendah per tugas dibandingkan pada high, membutuhkan waktu 30% lebih singkat, dan mendapat skor 0,7 poin lebih rendah (interval 95%: 0,1 hingga 1,3 lebih rendah). Dengan kedua perubahan pada effort high, agen tunggal membutuhkan waktu 53% lebih singkat dibandingkan pada effort medium (interval 95%: 42% hingga 63% lebih singkat), dan biaya per tugasnya 31% lebih rendah (interval 95%: 28% hingga 35% lebih rendah). Skornya 1,2 poin lebih rendah (interval 95%: 0,5 hingga 1,9 lebih rendah), dan ujung terjauh interval tersebut, 1,9 poin lebih rendah, melewati margin 1,5 poin.
Pada ketiga set, kedua perubahan pada effort high menghemat lebih banyak waktu daripada effort medium. Dari sisi biaya, tidak ada perbedaan yang jelas pada HLE dan set fisika, sedangkan pada DRACO biayanya lebih rendah. Dari sisi skor, hasilnya kurang lebih sama pada HLE. Pada set fisika, skornya 3,2 poin lebih tinggi, tetapi intervalnya mencakup nol, sehingga perbedaannya tidak jelas. Jadi, untuk agen tunggal, jam menghemat lebih banyak waktu daripada menurunkan tingkat effort. Namun, pada DRACO, agen tunggal dengan kedua perubahan mendapat skor 1,2 poin lebih rendah dibandingkan pada effort medium (interval 95%: 0,5 hingga 1,9 lebih rendah).
Kapan menggunakannya.
- Gunakan kedua perubahan jika waktu agen penting dan perubahan skor yang kecil masih dapat diterima. Pada setiap konfigurasi yang diukur, kedua perubahan memangkas waktu dan biaya per tugas, baik untuk tim maupun agen tunggal.
- Periksa skor pada tugas Anda sendiri sebelum menerapkannya. Pada DRACO, skornya 1,5 poin lebih rendah untuk tim dan 1,9 poin lebih rendah untuk agen tunggal. Pada HLE, skornya 1,7 poin lebih rendah untuk tim dan 1,1 poin lebih rendah untuk agen tunggal. Pada set fisika, tidak ada perubahan skor yang jelas berbeda dari nol.
- Jika Anda sedang mempertimbangkan tingkat effort yang lebih rendah untuk menghemat waktu, bandingkan dulu dengan jam. Agen tunggal dengan kedua perubahan pada effort
highmembutuhkan waktu lebih singkat daripada pada effortmedium: 53% lebih singkat pada DRACO, 25% lebih singkat pada HLE, dan 27% lebih singkat pada set fisika. Biaya per tugasnya 31% lebih rendah pada DRACO, tanpa perbedaan yang jelas pada HLE dan set fisika.
Cara menambahkannya. Letakkan instruksi ini di awal prompt sistem setiap agen:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.Kalimat kedua memberi tahu model bahwa pesan jam tersebut ada. Permintaan pertama tidak membawa jam, dan run yang diukur menggunakan kata-kata persis seperti ini.
Kemudian, sebelum setiap permintaan setelah permintaan pertama agen, tambahkan pesan sistem di tengah percakapan yang berisi waktu yang telah berlalu dalam detik bulat, misalnya Elapsed time: 412 seconds. Hitung dari awal tugas, bukan dari awal agen. Dalam tim, setiap agen membaca jam yang sama. Jadi, jam pertama yang dilihat pembantu sudah mencakup waktu yang dihabiskan tim sebelum pembantu tersebut dimulai. Dalam loop alat, letakkan pesan tepat setelah pesan user yang membawa hasil alat, seperti yang ditunjukkan di Penempatan setelah hasil alat. Jika Anda mengirimkan pesan user baru kepada agen, letakkan jam setelah pesan tersebut.
Biarkan pesan jam sebelumnya tetap di tempatnya. Setiap pesan menjadi bagian dari riwayat percakapan, sehingga prefiks yang di-cache tetap cocok pada permintaan berikutnya (lihat Menggabungkan dengan caching prompt). Juglow mengukur pesan sistem biasa ini, yang tetap terlihat oleh model. Pesan sistem berlingkup giliran hanya akan menunjukkan jam terbaru kepada model, dan Juglow tidak mengukur bentuk tersebut.
Contoh berikut menjalankan loop alat satu agen dengan kedua perubahan. Contoh ini menambahkan jam setelah hasil alat dan hanya menangani alat klien:
import time

import juglow

client = juglow.Juglow()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)

def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Detik wall-clock, agar helper di proses lain dapat memakai waktu mulai yang sama dengan lead.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Gunakan streaming karena batas 128.000 token terlalu besar untuk permintaan non-streaming.
        with client.messages.stream(
            model="haijun-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Pesan sistem harus mengikuti giliran pengguna, jadi jam ditempatkan setelah hasil alat.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
        )
Haijun Fable 5.1 mendukung pesan sistem di tengah percakapan. Untuk model lainnya, lihat daftar model yang didukung. Pada model yang tidak mendukungnya, seperti Haijun Sonnet 5, Anda dapat meletakkan baris yang sama dalam blok teks setelah blok tool_result terakhir pada giliran user. Juglow hanya mengukur bentuk pesan sistem.
Pada Haijun Managed Agents, Anda dapat mengirimkan event system.message bersama hasil alat atau pesan pengguna. Pesan tersebut berlaku untuk giliran itu dan setiap giliran berikutnya. Akibatnya, giliran yang mengikuti alat bawaan platform, seperti pencarian web, melihat jam terakhir yang Anda kirim, bukan waktu saat ini. Selain itu, system.message hanya mencapai thread utama sesi. Dalam sesi multiagen, thread utama adalah thread koordinator, sehingga agen worker tidak pernah melihat jam yang Anda kirim dengan cara ini. Untuk menunjukkan waktu saat ini sebelum setiap giliran dan kepada setiap agen dalam tim, jalankan sendiri loop agen pada Messages API.
Menggabungkan model
Arsitektur multi-model cocok untuk beban kerja yang kompleksitas tugasnya cukup bervariasi sehingga langkah-langkah berbeda paling baik dilayani oleh model berbeda. Ketika lalu lintas Anda mencampur pekerjaan rutin yang ditangani model lebih kecil dengan andal dengan langkah-langkah lebih sulit yang membutuhkan kemampuan frontier, membagi pekerjaan menjaga kecerdasan frontier di tempat yang penting sementara sebagian besar token ditagih dengan tarif model lebih kecil. Ketika beban kerja tidak memiliki campuran itu, karena kesulitannya seragam atau berupa satu rantai yang saling bergantung, satu model yang disetel dengan baik biasanya merupakan pilihan yang lebih baik. Setiap bagian strategi memberikan aturan untuk membedakan kedua kasus tersebut.
Dua strategi mencakup sebagian besar beban kerja, dan keduanya berbeda dalam model mana yang memegang loop utama:
| Strategi | Alur kontrol | Peran model frontier | Cocok untuk | Biaya frontier meningkat seiring |
|---|---|---|---|---|
| Advisor | Model lebih kecil menjalankan loop, mengeskalasi sesuai kebutuhan | Dikonsultasikan untuk rencana dan koreksi | Pekerjaan serial yang sulit di beberapa titik, seperti banyak giliran agen coding di antara beberapa keputusan nyata | Seberapa sering executor macet |
| Orchestrator | Model frontier menjalankan loop, mendelegasikan pekerjaan massal | Merencanakan, mengirim, dan mensintesis | Pekerjaan yang menyebar ke file, dokumen, atau kasus yang benar-benar independen, terutama yang lebih dari satu jendela konteks | Seberapa sulit bagian-bagiannya dikoordinasikan |
Strategi advisor: eskalasikan keputusan sulit
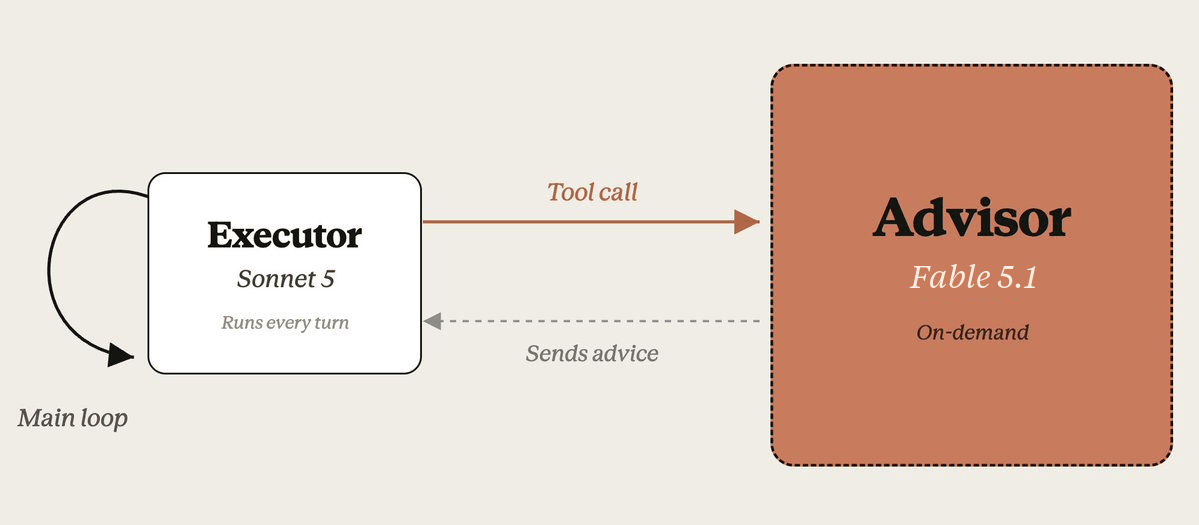
Dalam strategi advisor, model executor berbiaya lebih rendah menjalankan loop agen dan mengerjakan sebagian besar giliran. Saat menghadapi keputusan yang membutuhkan penilaian lebih mendalam, seperti memilih pendekatan atau pulih dari kegagalan, executor memanggil model advisor berkecerdasan lebih tinggi untuk mendapatkan panduan strategis, lalu melanjutkan pekerjaan. Sebagian besar token ditagih dengan tarif executor, dan hanya konsultasi sesekali yang ditagih dengan tarif advisor.
Untuk menggunakannya, tambahkan alat advisor ke permintaan Anda. Fitur beta ini menjalankan seluruh strategi di sisi server dalam satu permintaan /v1/messages. Executor mengeluarkan pemanggilan alat, Juglow menjalankan inferensi advisor, lalu executor melanjutkan dengan saran tersebut. Anda tidak perlu menulis kode orkestrasi. Pada Haijun Managed Agents, berikan sesi sebuah advisor dengan menambahkan entri advisor ke daftar multiagent milik agen; thread utama sesi akan berkonsultasi dengannya dengan cara yang sama. Haijun Code juga mendukung strategi ini; lihat mengeskalasi keputusan sulit dengan alat advisor.
Apa yang menentukan hasilnya. Advisor hanya melihat tugas melalui panggilan dari executor. Karena itu, ada dua hal yang menentukan seberapa besar bantuannya.
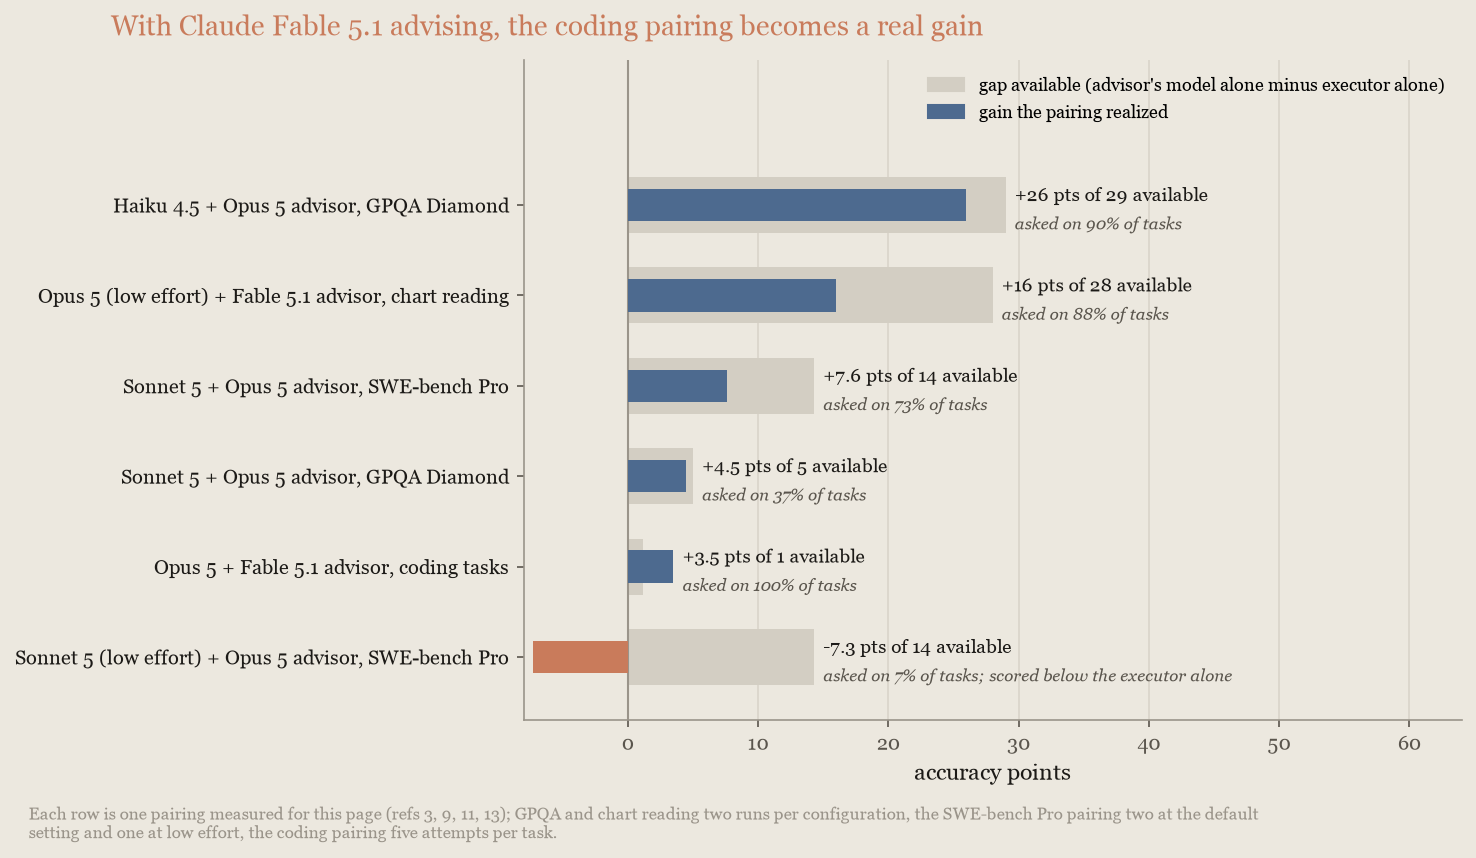
Yang pertama adalah kesenjangan kemampuan antara kedua model. Advisor hanya dapat memberikan kemampuan yang tidak dimiliki executor. Pada GPQA Diamond9, executor Haijun Haiku 4.5 memperoleh peningkatan besar dari advisor Haijun Opus 5. Executor Haijun Sonnet 5 memperoleh beberapa poin, sedangkan executor frontier hampir tidak memperoleh apa pun.
Yang kedua, dan yang paling rapuh, adalah apakah executor benar-benar bertanya (tingkat konsultasi). Executor pada effort rendah dapat berhenti menyadari bahwa ia mengalami kebuntuan. Pasangan yang berkonsultasi pada sebagian besar tugas pada effort default dapat hampir tidak pernah berkonsultasi ketika effort diturunkan, lalu mendapat skor di bawah executor yang bekerja sendiri. Tingkat konsultasi juga bervariasi menurut tugas. Pada DeepSWE10, executor Sonnet 5 dengan effort rendah terus bertanya dan memperoleh 23 poin. Pada SWE-bench Pro3, executor yang sama berhenti bertanya.
Jika executor benar-benar bertanya, ia dapat menutup sebagian besar kesenjangan. Pada pasangan dalam grafik berikut yang executor-nya terus bertanya, advisor menutup setidaknya setengah kesenjangan terhadap model yang lebih kuat. Pasangan coding bahkan mengungguli model yang lebih kuat secara langsung. Anda hanya membayar model yang lebih kuat saat konsultasi, dan inilah yang memungkinkan penghematan biaya:
Tingkat konsultasi dapat dipengaruhi oleh prompting. Jika hanya mengandalkan deskripsi bawaan alat, executor cenderung jarang memanggil advisor, terutama pada pekerjaan coding. Karena itu, dokumentasi alat advisor menyediakan prompt sistem yang meminta satu panggilan sebelum pekerjaan substantif dan satu panggilan sebelum selesai, atau sekitar dua hingga tiga panggilan per tugas. Pasangan coding yang diukur di bagian berikutnya mengikuti ritme itu dengan Haijun Opus 5 sebagai executor, yaitu sekitar dua konsultasi pada setiap tugas. Dengan Haijun Opus 5.5 sebagai executor, saran diminta sekitar 1,4 kali per percobaan, dan 4% percobaan tidak menerima saran sama sekali. Halaman tersebut juga membahas cara mendorong executor yang jarang memanggil advisor dan cara membatasi jumlah panggilan di sisi klien untuk mengendalikan biaya. Jadi, pantau tingkat konsultasi: dorong melalui prompt, ukur hasilnya, dan kembalikan effort executor jika tingkat konsultasi anjlok.
Kapan menguntungkan dari sisi biaya. Advisor menghemat uang jika beberapa konsultasi singkat, yang ditagih dengan tarif advisor, dapat menggantikan penggunaan model advisor untuk seluruh tugas. Strategi ini paling efektif jika harga model advisor jauh di atas harga executor. Karena itu, konfigurasi paling hemat biaya adalah advisor frontier yang mendampingi executor kelas menengah.
Pasangan di puncak rentang harga dapat menutup sebagian biaya saran, karena saran juga menghemat token executor: executor yang diberi tahu pendekatan yang tepat akan lebih jarang menemui jalan buntu. Dalam pasangan coding di bawah dengan executor Haijun Opus 5, penghematan tersebut menutup sekitar setengah biaya saran. Executor menghabiskan $1,26 lebih sedikit per percobaan dibandingkan Opus 5 yang bekerja sendiri pada default-nya, sementara konsultasinya berbiaya $2,47. Dengan executor Haijun Opus 5.5, saran hampir tidak menghemat biaya executor: $1,36 per percobaan dibandingkan $1,38 untuk Opus 5.5 yang bekerja sendiri pada high, sementara konsultasinya berbiaya $1,55.
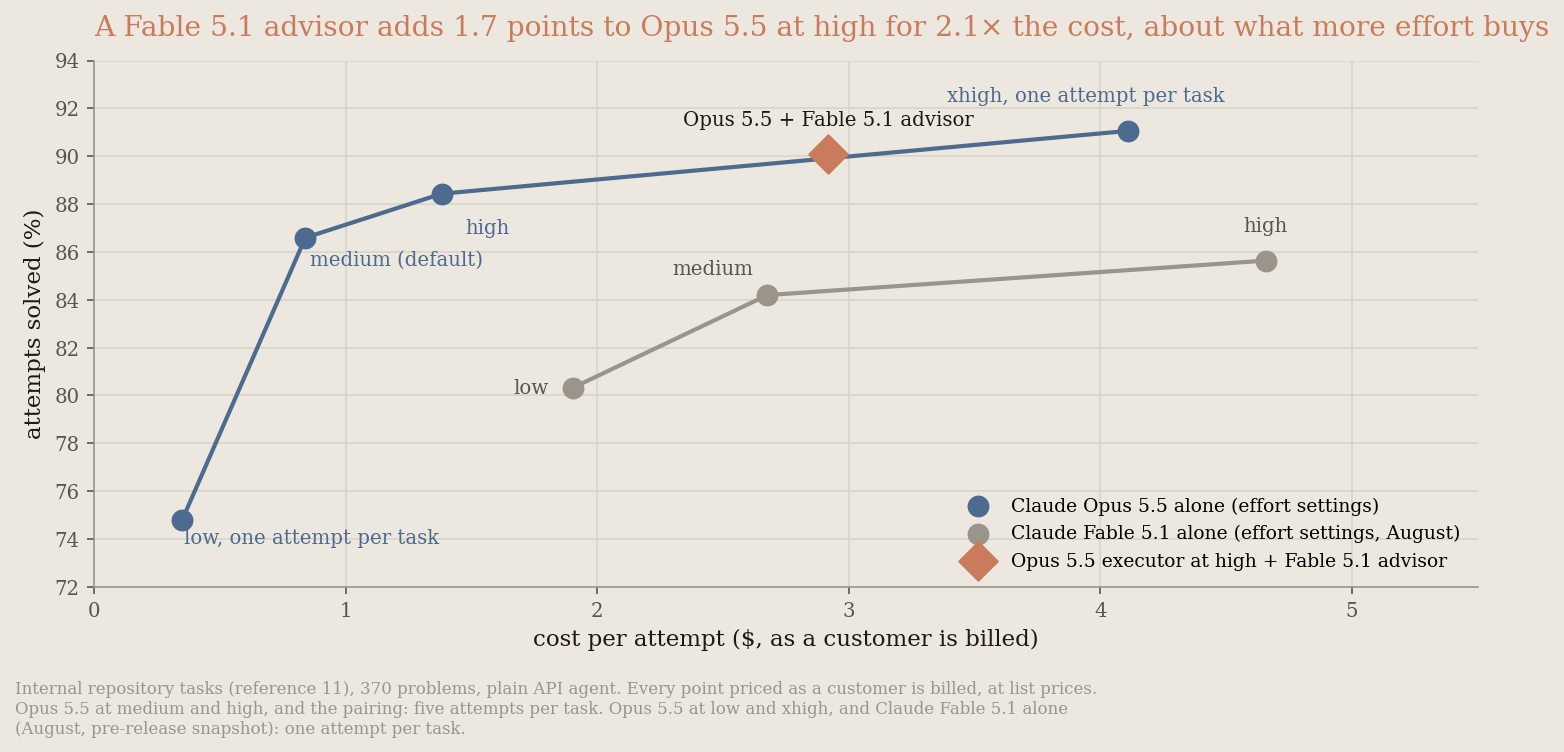
Pada benchmark coding agentik internal11 yang dijalankan dengan agen API biasa, executor Haijun Opus 5.5 pada high dengan advisor Haijun Fable 5.1 mendapat skor 90,1% dengan biaya $2,92 per percobaan. Dibandingkan dengan Opus 5.5 yang bekerja sendiri pada high, pengaturan yang sama dengan executor, skornya 1,7 poin lebih tinggi dengan biaya sekitar 2,1 kali lipat. Selisih ini berada di batas noise antar-run dengan lima percobaan per tugas. Dibandingkan dengan Opus 5.5 pada default-nya, medium, skornya 3,5 poin lebih tinggi dengan biaya sekitar 3,5 kali lipat. Hasil ini kurang lebih berada pada kurva effort Opus 5.5 sendiri. Artinya, advisor memberikan peningkatan yang kurang lebih sama dengan menaikkan effort: Opus 5.5 yang bekerja sendiri pada xhigh mendapat skor 91,1% dengan biaya $4,11 per percobaan (satu percobaan per tugas). Pada bulan Agustus, advisor Haijun Fable 5.1 yang mendampingi executor Haijun Opus 5 adalah konfigurasi paling akurat yang diukur, dengan biaya $6,21 per percobaan, atau sedikit lebih dari dua kali biaya pasangan Opus 5.5. Grafik ini memplot pasangan Opus 5.5 terhadap kurva effort Opus 5.5 sendiri dan kurva Haijun Fable 5.1 dari bulan Agustus:
Pengukuran sebelumnya melalui mode advisor Haijun Code juga menempatkan pasangan advisor-nya di atas masing-masing modelnya yang bekerja sendiri. Anggap hasil Haijun Opus 5.5 sebagai pola yang perlu diuji pada beban kerja Anda: advisor menambah beberapa poin dengan biaya sekitar dua kali lipat biaya executor yang bekerja sendiri. Kesenjangan kemampuan yang lebih lebar tidak menjamin hasil yang lebih menguntungkan. Biaya latensinya berasal dari konsultasi itu sendiri: sekitar satu atau dua panggilan model frontier tambahan per tugas pada benchmark ini, dan setiap panggilan berada di jalur kritis tugas.
Kapan model yang lebih kuat saja merupakan pilihan yang lebih baik. Jika akurasi beban kerja Anda dipengaruhi oleh effort, bandingkan pasangan advisor dengan model advisor yang bekerja sendiri pada pengaturan yang lebih rendah sebelum membangunnya. Advisor hanya dibayar pada tugas yang membutuhkannya. Namun, jika konsultasi terjadi pada sebagian besar tugas, biayanya lebih tinggi daripada menjalankan model yang lebih kuat itu sendiri.
Pada Chartography13, executor Haijun Opus 5.5 pada low yang didampingi advisor Haijun Fable 5.1 hanya berkonsultasi pada 1 dari 300 tugas. Skornya 61,7, atau 7 poin di bawah Opus 5.5 yang bekerja sendiri, melampaui noise antar-run, dengan biaya kurang lebih sama. Pada bulan Agustus, executor Haijun Opus 5 berkonsultasi pada hampir setiap tugas. Pasangan tersebut menyamai Fable 5.1 yang bekerja sendiri pada medium dalam rentang noise antar-run (65,0 dibandingkan 67,5), tetapi dengan biaya sekitar 1,8 kali per tugas.
Ukur tingkat konsultasi Anda sendiri terlebih dahulu. Jika executor bertanya pada sebagian besar tugasnya, Anda membayar tarif advisor di seluruh beban kerja. Dalam kasus ini, menjalankan model advisor itu sendiri adalah cara yang lebih murah untuk mencapai skor yang sama.
Apa pun pasangannya, hitung terlebih dahulu biaya model advisor yang bekerja sendiri pada effort rendah; itulah baseline yang harus dikalahkan. Periksa ulang setiap kali ada rilis model baru, karena rilis dapat mengubah kesenjangan kemampuan maupun rasio harga.
Kapan strategi ini cocok. Strategi advisor cocok untuk beban kerja yang sebagian besar gilirannya bersifat mekanis, tetapi membutuhkan rencana yang sangat baik: agen coding, computer use, dan pipeline riset multilangkah. Strategi ini kurang cocok jika setiap giliran benar-benar membutuhkan kemampuan frontier, jika tidak ada yang perlu direncanakan (tanya jawab satu giliran), atau jika kemampuan executor Anda sudah mendekati kemampuan advisor.
Strategi orchestrator: delegasikan pekerjaan massal
Dalam strategi orchestrator, model frontier memegang loop. Model ini menguraikan tugas, mengirimkan subtugas ke model "worker" (pekerja) berbiaya lebih rendah, lalu menggabungkan hasilnya. Transkrip milik orchestrator sendiri tetap pendek karena worker menanggung eksplorasi yang boros token. Dengan begitu, sebagian besar token ditagih dengan tarif worker, sementara rencana dan sintesis tetap berasal dari model frontier.
Untuk membangunnya, gunakan orkestrasi multiagen di Haijun Managed Agents: konfigurasikan agen koordinator (orchestrator) dan sekumpulan agen worker, masing-masing dengan modelnya sendiri. Untuk contoh lengkap yang siap dijalankan dengan koordinator frontier dan worker Haijun Sonnet 5, lihat resep Haijun Cookbook Coordinator pattern: big models for planning, small models for execution.
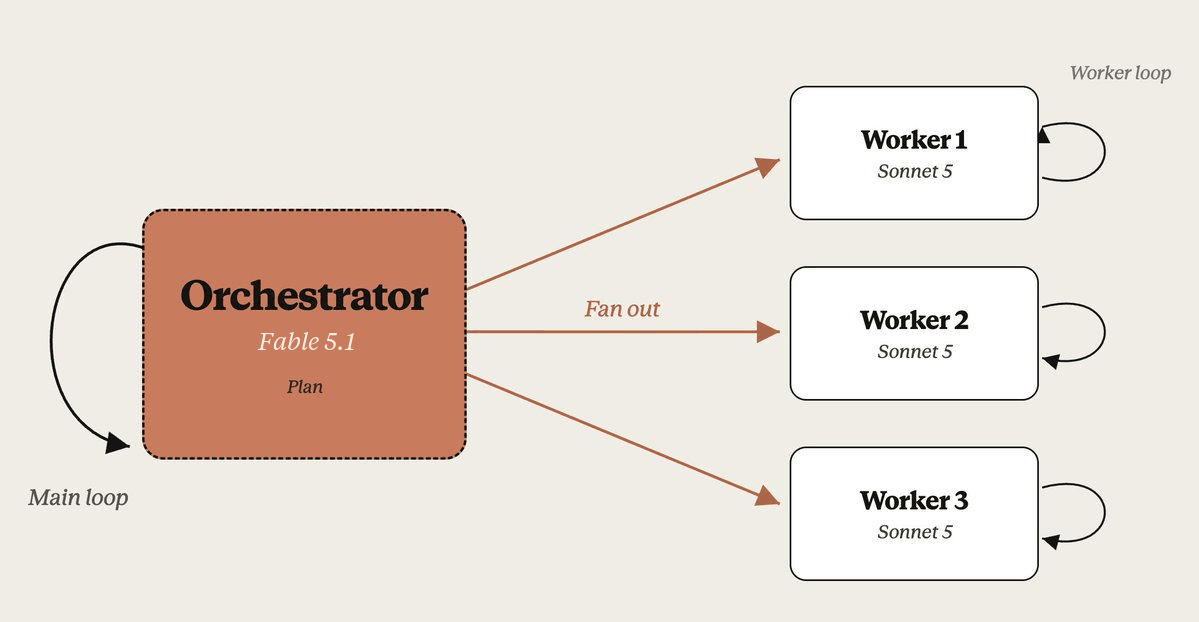
Pola ini menghemat "wall-clock time" (waktu nyata) ketika worker dapat berjalan secara paralel. Pada benchmark korpus8, satu episode memakan waktu sekitar 2,3 jam ketika koordinator menjalankan 25 worker secara bersamaan, sesuai batas yang didokumentasikan platform, dibandingkan dengan 15 hingga 20 jam jika dijalankan sendiri. Namun, pola ini hanya menghemat biaya dalam dua situasi yang diukur. Pada pekerjaan yang dapat ditangani oleh satu model saja, model yang sama dengan effort lebih rendah selalu lebih murah.
Ketika worker berjalan secara paralel, instruksi waktu dan jam penunjuk waktu yang telah berlalu dapat mempersingkat proses. Pada DRACO21, tim agen bermodel sama yang diberi instruksi dan jam tersebut selesai dalam waktu 33% lebih singkat dengan biaya per tugas 54% lebih rendah, tetapi skornya 1,5 poin lebih rendah. Setiap agen dalam tim itu memiliki instruksi dan jam tersebut. Juglow tidak mengukur efek jam tersebut pada worker berbiaya lebih rendah. Di Haijun Managed Agents, jam hanya diterima oleh koordinator, sehingga worker tidak pernah melihatnya. Juglow juga tidak mengukur tim yang jamnya hanya dimiliki koordinator. Selain itu, jam koordinator hanya mutakhir pada giliran yang mengikuti hasil alat atau pesan Anda sendiri. Bagian Tunjukkan waktu yang telah berlalu kepada model berisi resep untuk loop agen yang Anda jalankan di Messages API.
Kasus 1: asuransi terhadap "cost tail" (ekor biaya) pada pekerjaan rutin. Model frontier yang berjalan sendiri sesekali berputar-putar tanpa arah pada masalah rutin yang biasanya dapat diselesaikannya. Karena Anda tidak dapat mengetahui sebelumnya proses mana yang akan mengalami hal ini, segelintir proses semacam itu mendominasi tagihan. Koordinator yang menyerahkan pekerjaan rutin ke worker berbiaya lebih rendah membatasi ekor tersebut, karena putaran tanpa arah apa pun kini terjadi dengan tarif worker.
Juglow mengukur hal ini pada irisan BrowseComp4 yang sengaja dibuat mudah (10 masalah yang secara andal diselesaikan oleh model solo; 50 proses terdelegasi dan 70 proses solo). Koordinator Haijun Fable 5 dengan satu worker Haijun Sonnet 5 rata-rata berbiaya sekitar setengah dari Haijun Fable 5 yang berjalan sendiri, dan sekitar sepertiganya pada persentil ke-90 ($12 dibandingkan $33). Selain itu, proses termahal model solo, senilai $84, juga memberikan jawaban yang salah:
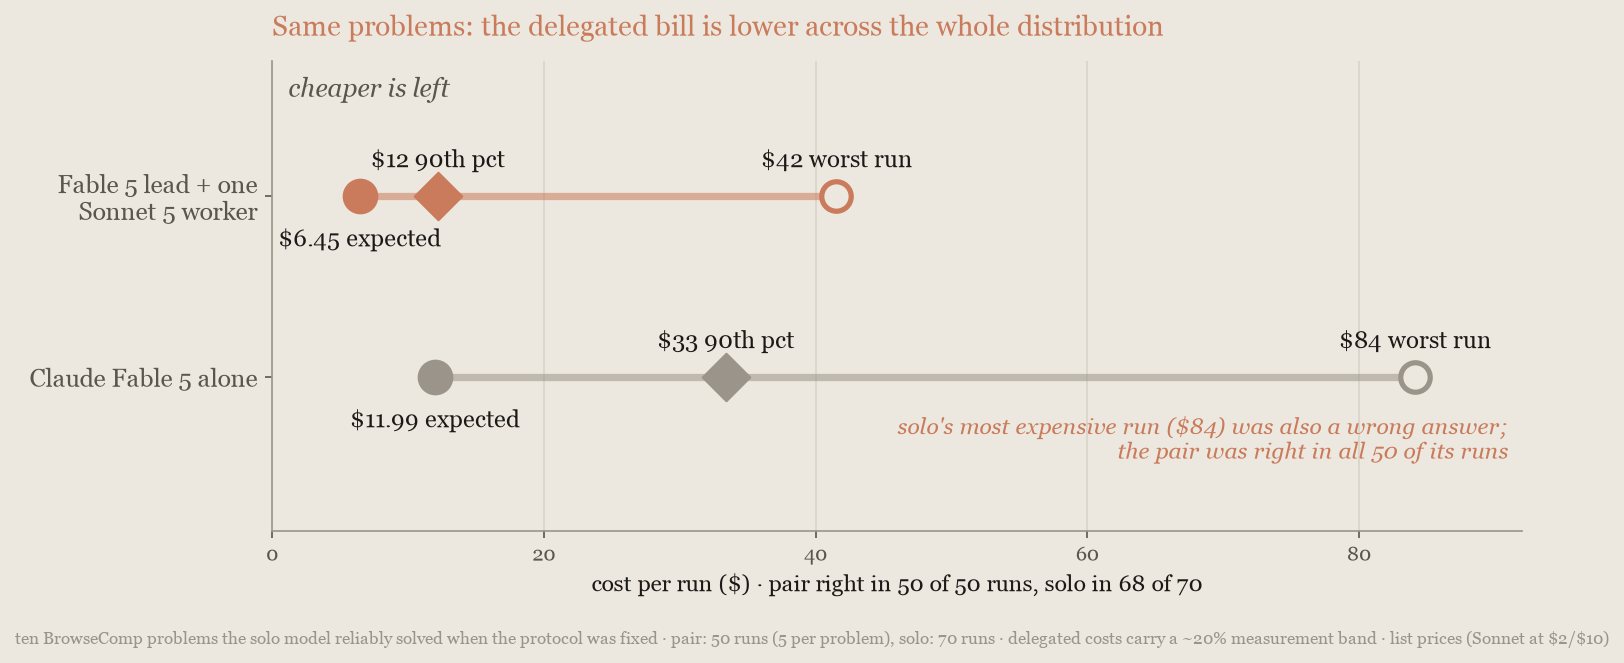
Delegasi justru menguntungkan pada bagian pekerjaan yang rutin dan biasanya dapat diselesaikan, berlawanan dengan intuisi bahwa worker ditujukan untuk masalah sulit. Pada set BrowseComp lengkap yang lebih sulit, perhitungan ekonominya berbalik. Jika lalu lintas Anda memiliki ekor biaya panjang pada tugas rutin, inilah kasus orchestrator yang perlu Anda ukur terlebih dahulu.
Kasus 2: pekerjaan yang lebih besar dari satu "context window" (jendela konteks). Model solo harus memproses input sebesar itu secara serial, satu jendela konteks demi satu jendela konteks, dan membayar untuk membaca ulang statusnya sendiri pada setiap putaran. Sebaliknya, setiap worker membaca partisinya sendiri secara paralel dengan tarif worker. Pekerjaan yang banyak membaca tetapi masih muat dalam satu jendela konteks adalah masalah pemilihan model, bukan masalah delegasi: dari sisi biaya membaca saja, orchestrator hanya unggul ketika pekerjaan tersebut tidak muat dalam satu konteks mana pun.
Juglow membangun benchmark untuk kasus ini8: korpus berisi 21,6 juta token dari 14 paket Python publik dengan 130 cacat yang sengaja ditanam, terlalu besar untuk jendela konteks mana pun. Menurunkan effort tidak membantu, karena tagihannya berasal dari pembacaan korpus itu sendiri: Haijun Fable 5.1 solo berbiaya $468 hingga $552 per episode di ketiga pengaturan effort, dan hanya akurasinya yang berubah. Konfigurasi koordinator, yaitu Haijun Fable 5.1 sebagai pemimpin bagi 25 worker Haijun Sonnet 5, berbiaya sekitar setengah dari pengaturan tersebut (47% hingga 55% lebih rendah) dengan skor 10 hingga 12 poin di bawahnya. Konfigurasi ini membutuhkan sekitar 2,3 jam per episode dibandingkan 15 hingga 20 jam, dan sepenuhnya mengungguli baseline Haijun Sonnet 5 solo:
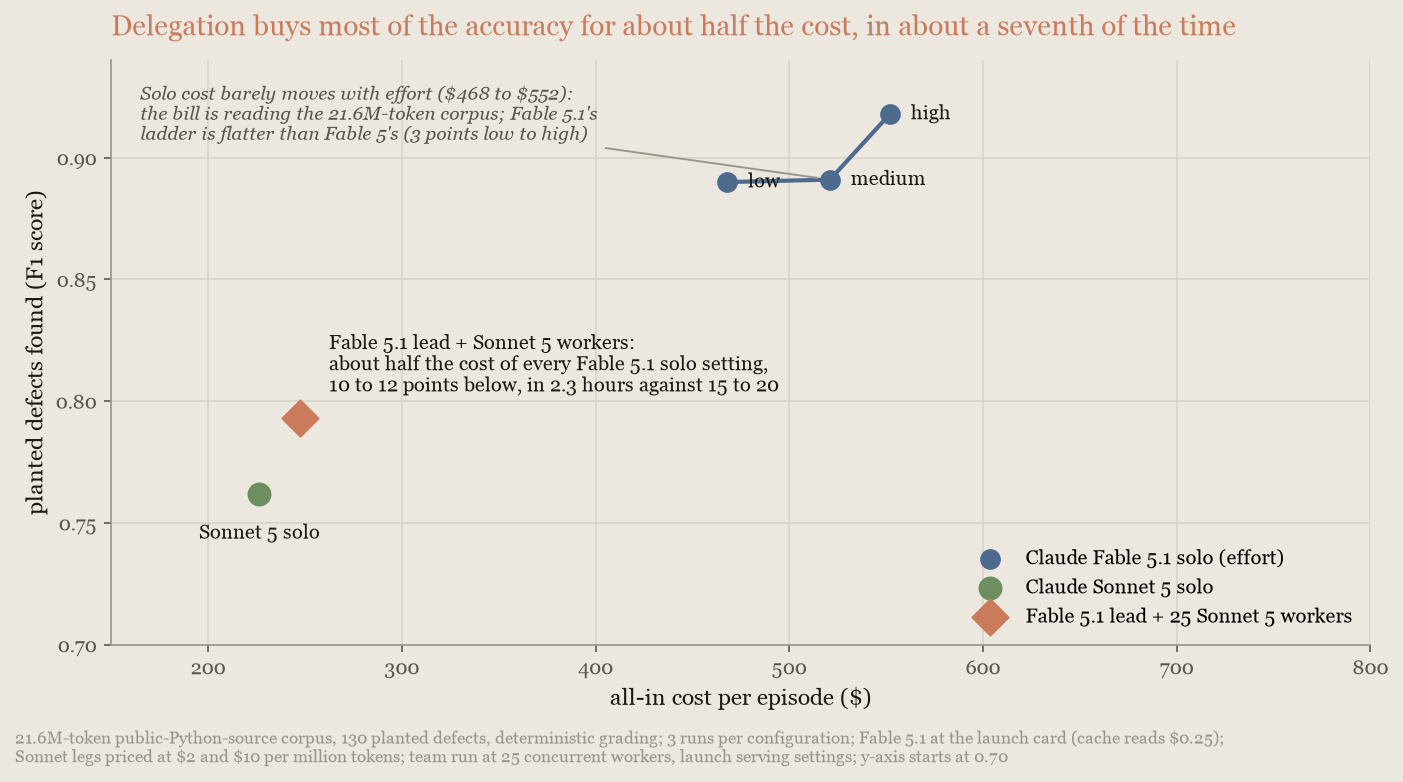
Perhitungan token menunjukkan skala pembacaannya. Konfigurasi koordinator membaca sekitar 560 juta token cache per episode, sekitar satu setengah kali lipat dari sekitar 365 juta token milik model solo. Hampir semua token tersebut dikenai tarif baca cache Haijun Sonnet 5, sehingga biaya keseluruhannya tetap sekitar setengahnya. Fable 5.1 pada effort high tetap memegang akurasi tertinggi, dengan biaya sekitar 2,2 kali lipat biaya konfigurasi koordinator. Jadi, delegasi di sini memberikan sebagian besar akurasi, tetapi tidak seluruhnya.
Kapan delegasi tidak menguntungkan. Orchestrator hanya memberikan manfaat ketika ada pekerjaan massal yang dapat diserahkan: banyak bagian independen, idealnya terlalu banyak untuk satu jendela konteks. Ketika pekerjaan berupa satu rantai langkah yang saling bergantung, atau muat dalam satu konteks, orchestrator harus membayar untuk perencanaan, serah terima, dan penggabungan yang didapatkan secara gratis oleh satu model. Dalam setiap kasus semacam itu yang diukur, model koordinator yang berjalan sendiri dengan effort lebih rendah selalu lebih unggul.
Batasnya ditentukan oleh tingkat kesulitan tugas, bukan oleh benchmark-nya: pada set BrowseComp4 lengkap yang lebih sulit, Haijun Fable 5 yang berjalan sendiri mencapai akurasi konfigurasi koordinator dengan biaya 22% hingga 30% lebih rendah. Penelitian eksternal yang independen melaporkan pola yang sama5. Jika pekerjaan Anda berupa satu rantai, muat dalam satu konteks tanpa ekor biaya panjang, atau sudah dapat memenuhi standar Anda dengan satu model ber-effort lebih rendah, jangan membangun orchestrator.
Memilih di antara strategi
Sebagian besar kasus bermuara pada satu pertanyaan: apakah pekerjaan terbagi menjadi bagian-bagian independen, atau berupa satu jawaban yang dicapai melalui rantai langkah yang saling bergantung? Tabel strategi memetakan kedua jawaban ke kedua strategi.
Jika Anda tidak yakin, jangan membangun apa pun dulu:
- Sapu effort pada model Anda saat ini terlebih dahulu. Ini adalah eksperimen termurah di halaman ini, dan sebagian besar beban kerja berakhir di sana.
- Jika sapuan menunjukkan kesenjangan, hitung harga model yang lebih kuat sendirian pada effort rendah. Itulah angka yang harus dikalahkan oleh pasangan advisor, dan pasangan di halaman ini yang mengalahkannya adalah yang executor-nya benar-benar berkonsultasi.
Hasil multi-model di halaman ini dinilai terhadap model yang sama pada effort lebih rendah dan terhadap model satu tingkat di bawahnya yang berjalan sendirian. Itulah perbandingan yang harus dijalankan pada beban kerja Anda sendiri, dan alasan mengapa langkah pertama adalah sapuan effort.
Ketika Anda menambahkan advisor, itu berupa definisi alat, bukan perancangan ulang arsitektur.
Ukur pada beban kerja Anda sendiri
Angka-angka di halaman ini mencerminkan harga daftar pada saat pengukuran dan akan bergeser seiring perubahan model dan harga. Tingkat eskalasi Anda, seberapa rapi tugas dapat dipecah, dan panjang transkrip juga memengaruhinya. Namun, metodenya tetap sama:
- Ambil beberapa tugas dari log produksi dengan bobot yang mencerminkan lalu lintas nyata, lalu tulis pemeriksaan hasil untuk masing-masing tugas, misalnya tes lulus, tiket ditutup, atau jumlah baris benar. Catat biaya per tugas di samping skornya. Untuk menghitung biaya, kalikan kelima jumlah token berbayar dalam
usagesetiap respons dengan tarifnya masing-masing: input tanpa cache, penulisan cache 5 menit dan 1 jam (masing-masing 1,25x dan 2x harga input), pembacaan cache, dan output. Jumlahkan hasilnya di seluruh permintaan dalam tugas tersebut (Usage and Cost API melaporkan totalnya).
- Buat baseline untuk setiap tingkatan model di berbagai level effort, bukan hanya pada level default, lalu plot skor terhadap pengeluaran. Konfigurasi multi-model harus mengalahkan seluruh kurva model tunggal.
- Jika kurva menunjukkan kesenjangan yang tidak dapat ditutup dengan effort, tambahkan strategi multi-model yang sesuai dan jalankan ulang rangkaian pengujian.
- Jalankan konfigurasi pemenang dalam mode shadow pada sebagian lalu lintas sebelum beralih sepenuhnya, lalu biarkan rangkaian pengujian tetap berjalan.
Contoh berikut menghitung biaya langkah 1 untuk satu permintaan dengan harga daftar Haijun Opus 5.5:
  # Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
  INPUT_PER_MTOK=4.00 # Haijun Opus 5.5
  CACHE_READ_PER_MTOK=0.20 # 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
  OUTPUT_PER_MTOK=20.00

  response=$(curl --fail-with-body -sS https://haijun.my.id/v1/messages \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{
      "model": "haijun-opus-5-5",
      "max_tokens": 1024,
      "messages": [{"role": "user", "content": "Hello, Haijun"}]
    }')

  cost=$(jq -r --argjson in_price "$INPUT_PER_MTOK" --argjson read_price "$CACHE_READ_PER_MTOK" --argjson out_price "$OUTPUT_PER_MTOK" '
    .usage
    | (.input_tokens * $in_price
       + (.cache_creation.ephemeral_1h_input_tokens // 0) * $in_price * 2.00  # 1-hour cache write
       + (.cache_creation.ephemeral_5m_input_tokens // 0) * $in_price * 1.25  # 5-minute cache write
       + (.cache_read_input_tokens // 0) * $read_price                   # cache read
       + .output_tokens * $out_price) / 1e6
  ' <<<"$response")
printf 'Request cost: $%.6f\n' "$cost" # Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
INPUT_PER_MTOK=4.00 # Haijun Opus 5.5
CACHE_READ_PER_MTOK=0.20 # 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
OUTPUT_PER_MTOK=20.00
USAGE=$(ant messages create \
--model haijun-opus-5-5 \
--max-tokens 1024 \
--message '{role: user, content: "Hello, Haijun"}' \
--transform usage)
COST=$(jq -r --argjson in_price "$INPUT_PER_MTOK" --argjson read_price "$CACHE_READ_PER_MTOK" --argjson out_price "$OUTPUT_PER_MTOK" '
(.input_tokens * $in_price
+ (.cache_creation.ephemeral_1h_input_tokens // 0) * $in_price * 2.00 # 1-hour cache write
+ (.cache_creation.ephemeral_5m_input_tokens // 0) * $in_price * 1.25 # 5-minute cache write
+ (.cache_read_input_tokens // 0) * $read_price # cache read
+ .output_tokens * $out_price) / 1e6
' <<<"$USAGE")
printf 'Request cost: $%.6f\n' "$COST" # Harga per sejuta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
INPUT_PER_MTOK = 4.00 # Haijun Opus 5.5
# 0,05x harga input pada Haijun Opus 5.5; pengalinya berbeda per model
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00
client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-5-5",
max_tokens=1024,
messages=[{"role": "user", "content": "Hello, Haijun"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
usage.input_tokens * INPUT_PER_MTOK
# Penulisan cache 1 jam ditagih 2x harga input, 5 menit 1,25x; pembacaan dengan harga baca cache.
+ writes_1h * INPUT_PER_MTOK * 2.0
+ writes_5m * INPUT_PER_MTOK * 1.25
+ (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
+ usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}") // Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
const INPUT_PER_MTOK = 4.0; // Haijun Opus 5.5
const CACHE_READ_PER_MTOK = 0.2; // 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
const OUTPUT_PER_MTOK = 20.0;
const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-5-5",
max_tokens: 1024,
messages: [{ role: "user", content: "Hello, Haijun" }]
});
const usage = response.usage;
const cost =
(usage.input_tokens * INPUT_PER_MTOK +
(usage.cache_creation?.ephemeral_1h_input_tokens ?? 0) * INPUT_PER_MTOK * 2 + // 1-hour cache write
(usage.cache_creation?.ephemeral_5m_input_tokens ?? 0) * INPUT_PER_MTOK * 1.25 + // 5-minute cache write
(usage.cache_read_input_tokens ?? 0) * CACHE_READ_PER_MTOK + // cache read
usage.output_tokens * OUTPUT_PER_MTOK) /
1_000_000;
console.log(`Request cost: $${cost.toFixed(6)}`); // Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
const double InputPerMtok = 4.00; // Haijun Opus 5.5
const double CacheReadPerMtok = 0.20; // 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
const double OutputPerMtok = 20.00;
JuglowClient client = new();
var response = await client.Messages.Create(
new MessageCreateParams
{
Model = Model.HaijunOpus5_5,
MaxTokens = 1024,
Messages = [new() { Role = Role.User, Content = "Hello, Haijun" }],
}
);
var usage = response.Usage;
double cost =
(
usage.InputTokens * InputPerMtok
+ (usage.CacheCreation?.Ephemeral1hInputTokens ?? 0) * InputPerMtok * 2.00 // 1-hour cache write
+ (usage.CacheCreation?.Ephemeral5mInputTokens ?? 0) * InputPerMtok * 1.25 // 5-minute cache write
+ (usage.CacheReadInputTokens ?? 0) * CacheReadPerMtok // cache read
+ usage.OutputTokens * OutputPerMtok
) / 1_000_000;
Console.WriteLine($"Request cost: ${cost:F6}"); // Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
const (
inputPerMTok = 4.00 // Haijun Opus 5.5
cacheReadPerMTok = 0.20 // 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
outputPerMTok = 20.00
)
// ...
client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus5_5,
MaxTokens: 1024,
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("Hello, Haijun")),
},
})
if err != nil {
log.Fatal(err)
}
usage := response.Usage
cost := (float64(usage.InputTokens)*inputPerMTok +
float64(usage.CacheCreation.Ephemeral1hInputTokens)*inputPerMTok*2.00 + // 1-hour cache write
float64(usage.CacheCreation.Ephemeral5mInputTokens)*inputPerMTok*1.25 + // 5-minute cache write
float64(usage.CacheReadInputTokens)*cacheReadPerMTok + // cache read
float64(usage.OutputTokens)*outputPerMTok) / 1_000_000
fmt.Printf("Request cost: $%.6f\n", cost) // Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
static final double INPUT_PER_MTOK = 4.00; // Haijun Opus 5.5
static final double CACHE_READ_PER_MTOK = 0.20; // 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
static final double OUTPUT_PER_MTOK = 20.00;
void main() {
JuglowClient client = JuglowOkHttpClient.fromEnv();
Message response = client.messages().create(MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_5_5)
.maxTokens(1024)
.addUserMessage("Hello, Haijun")
.build());
Usage usage = response.usage();
long writes1h = usage.cacheCreation().map(CacheCreation::ephemeral1hInputTokens).orElse(0L);
long writes5m = usage.cacheCreation().map(CacheCreation::ephemeral5mInputTokens).orElse(0L);
double cost = (usage.inputTokens() * INPUT_PER_MTOK
+ writes1h * INPUT_PER_MTOK * 2.00 // 1-hour cache write
+ writes5m * INPUT_PER_MTOK * 1.25 // 5-minute cache write
+ usage.cacheReadInputTokens().orElse(0L) * CACHE_READ_PER_MTOK // cache read
+ usage.outputTokens() * OUTPUT_PER_MTOK) / 1_000_000;
IO.println("Request cost: $%.6f".formatted(cost));
} // Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
const INPUT_PER_MTOK = 4.00; // Haijun Opus 5.5
const CACHE_READ_PER_MTOK = 0.20; // 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
const OUTPUT_PER_MTOK = 20.00;
$client = new Client();
$response = $client->messages->create(
model: 'haijun-opus-5-5',
maxTokens: 1024,
messages: [['role' => 'user', 'content' => 'Hello, Haijun']],
);
$usage = $response->usage;
$cost = (
$usage->inputTokens * INPUT_PER_MTOK
+ ($usage->cacheCreation?->ephemeral1hInputTokens ?? 0) * INPUT_PER_MTOK * 2.00 // 1-hour cache write
+ ($usage->cacheCreation?->ephemeral5mInputTokens ?? 0) * INPUT_PER_MTOK * 1.25 // 5-minute cache write
+ ($usage->cacheReadInputTokens ?? 0) * CACHE_READ_PER_MTOK // cache read
+ $usage->outputTokens * OUTPUT_PER_MTOK
) / 1_000_000;
printf("Request cost: \$%.6f\n", $cost); # Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
INPUT_PER_MTOK = 4.00 # Haijun Opus 5.5
CACHE_READ_PER_MTOK = 0.20 # 0.05x the input price on Haijun Opus 5.5; the multiplier differs by model
OUTPUT_PER_MTOK = 20.00
client = Juglow::Client.new
response = client.messages.create(
model: "haijun-opus-5-5",
max_tokens: 1024,
messages: [{ role: "user", content: "Hello, Haijun" }]
)
usage = response.usage
cost = (
usage.input_tokens * INPUT_PER_MTOK +
usage.cache_creation&.ephemeral_1h_input_tokens.to_i * INPUT_PER_MTOK * 2.00 + # 1-hour cache write
usage.cache_creation&.ephemeral_5m_input_tokens.to_i * INPUT_PER_MTOK * 1.25 + # 5-minute cache write
usage.cache_read_input_tokens.to_i * CACHE_READ_PER_MTOK + # cache read
usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
puts format("Request cost: $%.6f", cost)Dalam loop agen, sebagian besar token input seharusnya berupa pembacaan cache. Jika cache_read_input_tokens kecil dibandingkan input_tokens ditambah cache_creation_input_tokens, pastikan caching aktif dan prefiks tetap sama di antara permintaan. Ketika alat advisor atau "compaction" (pemadatan) diaktifkan, sebagian token hanya dilaporkan dalam usage.iterations dan tidak tercakup dalam total tingkat atas. Dalam kasus ini, jumlahkan token dari usage.iterations, dan hitung biaya entri advisor_message dengan tarif model advisor.
Tabel berikut mencantumkan tuas-tuas penghematan sesuai urutan yang disarankan untuk dicoba:
| Tuas | Penghematan dalam run ini | Dampak pada kualitas | Latensi | Lokasi |
|---|---|---|---|---|
| Caching prompt | Biaya turun 2,7 hingga 5,3 kali lipat pada loop agen; 83% pada run triase | Tidak ada | Lebih cepat | Cache konteks berulang |
| Durasi cache 1 jam | Lebih murah daripada default 5 menit jika sekitar 1 dari 20 giliran mengikuti jeda antara 5 menit dan satu jam, dan hanya sedikit jeda yang melebihi satu jam. Pengecualiannya adalah Haijun Fable 5.1, yang lebih murah jika cache 5 menit dijaga tetap hangat selama jeda hanya beberapa menit, sedangkan durasi 1 jam lebih unggul jika jeda mendekati satu jam; serta Haijun Opus 5.5, yang lebih murah jika cache 5 menit dijaga tetap hangat ketika hanya satu atau dua dari 20 giliran yang mengikuti jeda hingga sekitar setengah jam. Tanpa jeda, default berbiaya 15% lebih rendah pada Haijun Sonnet 5 dan sekitar 15% hingga 18% lebih rendah pada Haijun Opus 5.5 | Tidak ada | Tetap hangat setelah jeda | Pilih durasi cache |
| Pemangkasan input | Tambahan 5 poin persentase pada run triase | Tidak ada | Netral | Pangkas token input dan konteks |
| Pangkas hasil alat yang usang di batas tugas | 39% pada run triase panjang (compaction 32%); tidak ada pada loop pendek | Tidak ada yang terukur | Netral | Pangkas token input dan konteks |
| Tool search | 45% dengan 500 definisi alat terpasang; 20% dengan server MCP GitHub | Tidak ada | Netral | Pangkas token input dan konteks |
| File data melalui eksekusi kode | 92% pada tugas data berisi 25 pertanyaan | Meningkat, 25 dari 25 alih-alih 6 dari 25 | Lebih cepat | Pangkas token input dan konteks |
| Batch API | 50% | Tidak ada | Hasil dalam 24 jam | Batch pekerjaan yang bisa menunggu |
| Audit prompt terhadap model saat ini | 14% pada kedua migrasi yang diukur | Tidak ada; meningkat pada salah satunya | Lebih cepat (lebih sedikit putaran alat) | Audit prompt terhadap model saat ini |
| Upgrade model | Opus 4.8 ke Opus 5: skor naik 12 poin dengan biaya 21% lebih tinggi per tugas yang terselesaikan (Opus 5 pada low mengalahkan Opus 4.8 dengan sekitar 30% biayanya); Sonnet 4.6 ke Sonnet 5: biaya 15% lebih rendah per tugas yang terselesaikan, skor naik 5 poin; Fable 5 ke Fable 5.1: biaya 43% lebih rendah per tugas yang terselesaikan dengan skor yang hampir sama | Meningkat | Netral | Upgrade model |
| Turunkan effort | Pekerjaan pengetahuan: medium 13% hingga 31%, low sepertiga hingga setengah; coding panjang: medium sekitar 30% dan low sekitar dua pertiga, keduanya dibandingkan dengan high | Turun 1 hingga 3 poin pada pekerjaan pengetahuan, 2 hingga 8 poin pada coding panjang | Lebih cepat | Setel effort |
| Jalankan ulang tugas yang gagal | Sekitar 40% dibandingkan menjalankan semuanya pada high, dengan tingkat kelulusan yang sama atau sedikit lebih baik | Tidak ada | Dua run pada tugas yang gagal | Jalankan ulang kegagalan pada effort yang lebih tinggi |
| Anggaran tugas | 44% hingga 58% | Turun 3 hingga 6 poin | Lebih cepat | Tetapkan anggaran dan batas output |
| Minta jawaban yang lebih singkat | 39% token output, 14% biaya pada run triase | Tidak ada | Lebih cepat | Tetapkan anggaran dan batas output |
Menaikkan max_tokens | Tidak ada per tugas yang terselesaikan, tetapi lebih banyak tugas yang terselesaikan | Naik hingga 22 poin pada set internal; tidak ada pada pasangan publik | Netral | Tetapkan anggaran dan batas output |
| Advisor | Bergantung pada kesenjangan kemampuan dan tingkat konsultasi. Pasangan coding mencetak skor 1,7 poin di atas Haijun Opus 5.5 yang berjalan sendiri pada high dengan biaya sekitar 2,1 kali lipat, kira-kira setara dengan hasil dari menaikkan effort. Dengan Haijun Opus 5.5, pasangan pembacaan grafik hampir tidak pernah berkonsultasi dengan advisor dan skornya 7 poin di bawah Opus 5.5 yang berjalan sendiri | Meningkat pada coding, menurun pada pembacaan grafik | Sekitar satu atau dua panggilan tambahan per tugas | Strategi advisor |
| Orchestrator | Sekitar setengah dibandingkan model frontier, baik untuk pekerjaan yang melebihi satu jendela konteks maupun pada ekor biaya tugas rutin (yang terakhir diukur pada Haijun Fable 5) | 10 hingga 12 poin di bawah model frontier | Jauh lebih cepat pada input besar | Strategi orchestrator |
Benchmark yang dirujuk
Kecuali jika suatu referensi menyatakan lain, pengukuran merupakan eksekusi internal Juglow atas benchmark-benchmark ini. Kecuali dinyatakan lain, biaya dinyatakan dalam USD pada harga daftar yang berlaku saat setiap benchmark dijalankan; angka Haijun Sonnet 5 menggunakan $2 dan $10 per juta token input dan output. Grafik berlabel "notional USD" (USD nosional) menghitung harga jumlah token setiap permintaan pada tarif tersebut, bukan melaporkan tagihan.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Tugas riset web yang luas, dinilai berdasarkan kelengkapan dan akurasi tabel dengan banyak baris; 200 soal, 3 eksekusi per konfigurasi, dijalankan 1 hingga 2 Agustus 2026. Grafik konsentrasi biaya berasal dari eksekusi terpisah atas 20 soal, 3 eksekusi per soal, dijalankan 3 hingga 4 Agustus 2026, dengan biaya dihitung dari catatan penagihan per permintaan.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Hasil kerja pengetahuan dinilai terhadap rubrik tugas; eksekusi 210 tugas dari gold set yang dirilis, satu percobaan per tugas, dijalankan 2 Agustus 2026. Penilaiannya dilakukan oleh model Haijun, sehingga skor absolut dapat berbeda dari hasil yang dipublikasikan.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Subset 482 soal yang dipilih karena kompatibel dengan harness evaluasi Juglow; skornya tidak dapat dibandingkan dengan leaderboard publik. Skor ini juga tidak dapat dibandingkan dengan hasil SWE-bench Pro dalam system card Haijun Opus 5.5, yang berasal dari eksekusi pada effort
maxdengan kumpulan soal yang berbeda. Angka Haijun Opus 5.5 merupakan rata-rata dua eksekusi padalow,medium(default-nya), danhigh, serta menggunakan satu eksekusi padaxhigh, semuanya dijalankan 19 hingga 20 September 2026, dengan batas 16.384 token per giliran yang sama seperti eksekusi Haijun Opus 5 bulan Agustus; batas tersebut memotong 2 percobaanxhighdan tidak memotong satu pun pada pengaturan lain. Eksekusi Opus 5.5 menggunakan versi benchmark yang container penilaiannya hanya dapat menjangkau mirror paket internal. Versi tersebut menghilangkan satu soal yang pengujiannya memerlukan situs web aktif, dan pada tiga soal lainnya solusi referensi gagal di lingkungan tersebut, sehingga perbandingan Opus 5.5, beserta angka Haijun Fable 5.1 yang disandingkan dengannya, menggunakan 478 soal yang tersisa. Angka SWE-bench Pro Haijun Opus 5 di Upgrade model dan grafik pasangan advisor merupakan rata-rata dua eksekusi pada effort default-nya dan menggunakan satu eksekusi padalow, semuanya dijalankan 4 Agustus 2026. Angka eskalasi diperoleh tugas demi tugas dari eksekusi Opus 5.5:lowterlebih dahulu, laluhighpada kegagalannya, menyelesaikan 96,4% hingga 97,5% di seluruh pasangan eksekusi dengan biaya sekitar $0,17;mediumterlebih dahulu, 96,0% hingga 97,1% dengan biaya sekitar $0,24;highdijalankan ulang pada kegagalannya sendiri, 96,9% dengan biaya $0,31; semuanya padahigh, 94,8% hingga 95,8% dengan biaya $0,29. Biaya pada subset ini dihitung sebagaimana organisasi pelanggan diukur: prompt sebelumnya dari setiap permintaan sebagai "cache read" (pembacaan cache) dan token barunya sebagai "cache write" (penulisan cache) 5 menit, berdasarkan catatan penggunaan eksekusi itu sendiri, diperiksa terhadap buku besar pelanggan; pengukuran milik organisasi evaluasi sendiri, yang hingga 10 September 2026 menagih pembacaan cache dalam blok 8.192 token untuk Haijun Opus 5, Haijun Fable 5, Haijun Opus 4.7, dan Haijun Opus 4.8, menghasilkan angka 1,4 hingga 1,8 kali lebih tinggi untuk eksekusi model-model tersebut; untuk Haijun Fable 5.1, Haijun Sonnet 5, dan Haijun Sonnet 4.6 keduanya berbeda paling banyak sekitar 9%, dan untuk angka Haijun Opus 5.5 keduanya sesuai dalam rentang 3% pada setiap pengaturan effort. Pasangan executor Haijun Sonnet 5 pada grafik advisor berasal dari seri pengukuran yang sama pada subset ini: pasangan Sonnet-plus-Opus 5 dijalankan dua kali (7 Agustus dan 8 Agustus 2026, satu eksekusi dan replikasi persisnya), pasangan effort rendah sekali (8 Agustus 2026), dan Haijun Sonnet 5 sendiri dua kali (77,4%, baseline untuk kedua baris Pro). Titik Haijun Fable 5 di Upgrade model adalah rata-rata tiga eksekusi pada effort default, dijalankan 26 Agustus 2026, dengan harga dihitung dengan cara yang sama. Angka anggaran tugas Haijun Fable 5.1 adalah satu eksekusi per anggaran (dua pada 35.000 token) pada subset yang sama dengan effort default, dijalankan 26 Agustus 2026, dengan eksekusi tanpa anggaran pada hari yang sama (92,1%, $1,10 per tugas) sebagai baseline; set sebelumnya pada effortlow, dijalankan 21 Agustus 2026, mencetak skor 88,6% tanpa anggaran dengan biaya $0,48 per tugas. Perbandingan di Bandingkan model memasangkan eksekusi tunggal tersebut dengan dua eksekusi Haijun Sonnet 5 gabungan dari subset yang sama; pada effort default Fable 5.1, pasangan tersebut menunjukkan hasil sebaliknya, yaitu 41% lebih mahal per tugas yang terselesaikan dibandingkan Sonnet 5. Tangga peningkatan adalah satu eksekusi per model pada default bawaannya (masing-masing dua untuk Opus 5 dan Sonnet 5, dan titik Fable 5 seperti dijelaskan di atas), dengan eksekusi Opus dan Sonnet dilakukan pada minggu yang sama dalam satu harness dan organisasi.
- BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Angka effort menggunakan potongan 500 soal, satu hingga tiga eksekusi per pengaturan, dijalankan 3 Agustus 2026, dengan titik default menggabungkan dua eksekusi dari 26 hingga 27 Juli 2026. Grafik asuransi biaya menggunakan 10 soal yang terselesaikan secara andal dari irisan 26 soal, 50 eksekusi terdelegasi (1 hingga 2 Agustus 2026) dan 70 eksekusi solo (50 dari 2 hingga 3 Agustus 2026; 20 diarsipkan dari 12 hingga 13 Juli dan 1 Agustus 2026), $6,45 dibandingkan $11,99 per eksekusi secara ekspektasi; angka terdelegasi memiliki rentang pengukuran sekitar 20%.
- Penskalaan arsitektur agen: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Studi eksternal independen, dikutip hanya untuk arah temuan tentang kapan delegasi tidak menguntungkan, bukan untuk angka apa pun.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. Ke-220 pertanyaannya mencakup 15 domain, masing-masing menggabungkan pengumpulan banyak baris dengan pengambilan multi-hop; diukur pada kumpulan baris tetap milik benchmark, 3 eksekusi per konfigurasi, dijalankan 2 Agustus 2026 (titik tim dengan satu worker dijalankan 26 hingga 27 Juli 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Ke-132 tugas risetnya di 22 domain dinilai terhadap rubrik biner yang diturunkan dari pakar; diukur pada subset 50 tugas yang distratifikasi di semua tema, satu percobaan per tugas, 3 eksekusi per pengaturan, di Haijun Managed Agents dengan alat web search dan fetch milik platform sendiri (26 hingga 27 Agustus 2026); dinilai pada 33 tugas yang tidak ditolak oleh konfigurasi mana pun, dengan percobaan yang dihentikan lebih awal oleh classifier keamanan produksi dihapus; biaya adalah yang ditagihkan kepada pelanggan, yaitu permintaan platform ditambah biaya web search. Skor adalah rata-rata setiap model pada basis 33 tugas dengan tugas miliknya yang didahului (pre-empted) dihapus; pada 21 tugas yang bersih di setiap kelompok uji, Haijun Fable 5.1 unggul 2 hingga 3 poin atas Haijun Fable 5 pada setiap tingkat effort dan kedua model datar di seluruh tingkat effort. Grafik caching menghitung ulang harga permintaan yang sama dengan setiap token input pada tarif tanpa cache. Haijun Opus 4.6 menilai berdasarkan protokol rubrik benchmark; versi aslinya menggunakan juri yang berbeda, dan juri Juglow mungkin lebih menyukai gaya internal. Haijun Opus 5 pada effort default-nya dijalankan pada permukaan dan subset yang sama, tiga eksekusi, pada 28 Agustus 2026: 68,8% pada 50 tugas mentah, 70,8% pada basis 33 tugas, dan 71,1% pada set 21 tugas, dengan biaya $6,71 per tugas ($23,72 tanpa caching); tidak ada percobaannya yang dihentikan lebih awal oleh classifier keamanan, di bawah deployment safeguards yang lebih baru daripada yang digunakan model-model lain.
- Penyisiran cacat korpus: Internal Juglow, untuk pekerjaan yang lebih besar dari satu "context window" (jendela konteks): korpus 21,6 juta token dari 14 sumber paket Python publik dengan 130 cacat yang ditanam dan penilaian deterministik; protokol ditetapkan sebelum eksekusi dan ditinjau secara internal; tiga eksekusi per konfigurasi. Setiap konfigurasi dijalankan di Haijun Managed Agents. Konfigurasi tim yang ditampilkan di grafik adalah eksekusi di mana koordinator Haijun Fable 5.1 menjalankan seluruh penyisiran di dalam platform pada batas terdokumentasinya, yaitu 25 worker Haijun Sonnet 5 secara bersamaan, dijalankan 30 Agustus 2026; ketiga episodenya mencetak F1 0,764, 0,825, dan 0,791 setelah audit temuan tambahan (mentah 0,751, 0,821, dan 0,781) dengan biaya $225, $234, dan $283. Konfigurasi solo Haijun Sonnet 5 dijalankan 3 hingga 4 Agustus 2026; konfigurasi solo Haijun Fable 5.1 dijalankan 24 hingga 25 Agustus 2026, di bawah pengaturan serving peluncuran platform, tiga seed per pengaturan effort, pada build korpus yang sama. Image sandbox memuat salinan terinstal dari sebagian korpus, dan langkah perakitan akhir Haijun Fable 5.1 membandingkan hasilnya dengan salinan tersebut pada 7 dari 9 episode; penilaian ulang tanpa tambahan tersebut menggeser seed yang terdampak hingga 3 poin. F1 absolut bersifat spesifik untuk build korpus ini dan tidak dapat dibandingkan antar-benchmark; perbandingan konfigurasi bersifat setara.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q\&A Benchmark," 2023. Subset Diamond berisi 198 pertanyaan, dua eksekusi per konfigurasi, dijalankan 7 Agustus 2026 (Haijun Opus 5.5: 19 September 2026), dinilai oleh model terhadap jawaban referensi, dengan token advisor diukur per permintaan. Pemeriksaan keamanan platform menolak dua pertanyaan biologi pada executor Haijun Sonnet 5, dan salah satunya juga pada Haijun Opus 5; mengecualikan keduanya tidak mengubah perbandingan apa pun lebih dari satu poin. Skor 92% Haijun Opus 5.5 berasal dari dua eksekusi yang menetapkan
fallbacks: "default"untuk ikut serta dalam fallback sisi server, dengan setiap percobaan yang tetap berakhir dengan penolakan dihitung salah. Dalam setiap eksekusi, pemeriksaan keamanan menandai enam pertanyaan biologi, Haijun Opus 5 menjawab lima di antaranya melalui fallback, dan pertanyaan keenam tetap berakhir dengan penolakan. Biaya per pertanyaan Opus 5.5 mencakup jawaban fallback tersebut. Tanpa menghitung penolakan sebagai salah, eksekusi ini mencetak skor 93%, karena penilai tetap menetapkan opsi jawaban untuk percobaan yang ditolak, biasanya opsi yang benar. Dengan penolakan dihitung salah, eksekusi Haijun Opus 5 mencetak skor 91% (satu penolakan per eksekusi), begitu pula dua eksekusi Haijun Opus 5.5 dengan fallback dinonaktifkan, di mana Opus 5.5 menolak lima atau enam pertanyaan biologi per eksekusi.
- DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. Set ini memiliki 113 tugas orisinal dalam lima bahasa dengan verifier berbasis program. Setiap pasangan dijalankan dua kali, pada 7 Agustus 2026, dengan token advisor diukur per permintaan, dan menggunakan loop advisor sisi klien alih-alih alat advisor, dengan perhitungan yang identik. Sweep effort model tunggal adalah eksekusi tunggal yang harganya dihitung dari jumlah token, sebuah aproksimasi yang memperhitungkan cache. Biaya per tugas adalah total eksekusi dibagi 113.
- Benchmark coding agentik internal: Internal Juglow: 370 tugas repositori yang dinilai oleh pengujian milik repositori itu sendiri. Angka API diukur dengan batas output 128.000 token, satu eksekusi per konfigurasi: Opus 5 sendiri pada effort default 9 hingga 10 Agustus 2026, serta pada
lowdanmedium10 Agustus 2026; Haijun Fable 5.1 sendiri pada lima nilai effort yang ditetapkan secara eksplisit 20 Agustus 2026 (grafik menampilkan tiga di antaranya); dan pasangan 24 hingga 25 Agustus 2026. Haijun Opus 5.5 sendiri dijalankan pada seluruh 370 tugas, 19 hingga 20 September 2026: pada effort default-nya (medium) dan padahighdengan lima percobaan per tugas, serta padalowdanxhighdengan satu percobaan (369 dari 370 dinilai pada masing-masing, setelah satu kegagalan pemeriksaan setup). Executor Haijun Opus 5.5 padahighdengan Haijun Fable 5.1 versi rilis sebagai advisor (eksekusi Agustus menggunakan snapshot pra-rilis) menjalankan lima percobaan per tugas pada tanggal yang sama; satu tugas gagal dalam pemeriksaan setup-nya, sehingga 1.845 percobaan dinilai. Ke-279 percobaan di mana advisor ditolak karena beban dijalankan ulang, dan percobaan yang konsultasinya mengalami timeout tetap dipertahankan, seperti pada Agustus. Eksekusi Agustus memiliki lima percobaan per tugas untuk pasangan dan kontrol Haijun Opus 5 serta satu percobaan untuk titik lainnya. Pasangan Agustus rata-rata melakukan sekitar dua konsultasi advisor per percobaan; pasangan Haijun Opus 5.5 meminta 1,39 dan menerima 1,35. Biaya dihitung per percobaan. Biaya dihitung sebagaimana organisasi pelanggan diukur: prompt sebelumnya dari setiap permintaan loop agen sebagai pembacaan cache dan token barunya sebagai penulisan cache 5 menit, berdasarkan catatan penggunaan eksekusi itu sendiri, dan setiap panggilan advisor, yang tidak menggunakan cache, berdasarkan token yang tercatat, semuanya pada harga daftar. Angka Haijun Code berasal dari eksekusi tugas yang sama pada 8 hingga 23 Juli 2026, satu eksekusi per konfigurasi, dengan biaya berupa perkiraan.
- Benchmark tugas repositori internal (pengukuran batas): Set internal Juglow terpisah berisi sekitar 130 tugas repositori, dijalankan 20 Agustus 2026 (Haijun Fable 5.1) dan 19 September 2026 (Haijun Opus 5.5, pada effort default-nya,
medium), dengan loop agen API biasa, satu percobaan per tugas. Eksekusi Haijun Fable 5.1 mencakup 135 tugas per batas pada effort default yang ditetapkan secara eksplisit: angka 16.384 token merupakan rata-rata dua eksekusi (36,3% pada keduanya); angka 64.000 dan 128.000 adalah eksekusi tunggal (58,5% dan 60,0%). Enam soal memicu penolakan keamanan di setiap eksekusi dan dihitung sebagai kegagalan. Angka 16.384 token Haijun Opus 5.5 merupakan rata-rata dua eksekusi (134 dan 135 tugas dinilai), dan angka 64.000 dan 128.000-nya adalah eksekusi tunggal (masing-masing 135 tugas); dua percobaan di setiap eksekusi 16.384 token berakhir dengan penolakan keamanan dan dihitung sebagai kegagalan. Angka batas SWE-bench Pro adalah satu eksekusi Haijun Fable 5.1 per batas pada effort default, dijalankan 26 Agustus 2026, pada subset 100 soal yang distratifikasi dari set 482 soal pada referensi 3, dan tidak dapat dibandingkan dengan skornya; kedua batas mencetak skor yang sama pada default. Distribusi per giliran pada grafik berasal dari eksekusi Haijun Opus 5.5 dan Haijun Fable 5.1 pada 128.000: tidak ada giliran Opus 5.5 yang mencapai batas (yang terpanjang sekitar 61.000 token, dan 0,56% gilirannya melebihi 16.384), dan satu giliran Fable 5.1 mencapai 128.000 (0,46% gilirannya melebihi 16.384).
- Chartography: Surge AI, "Chartography," 2026. Set lengkap 100 pertanyaan yang dirilis, diukur 6 dan 9 Agustus 2026 (Haijun Opus 5 sendiri) dan 20 September 2026 (Haijun Opus 5.5), dengan implementasi Juglow di Haijun Managed Agents (sandbox cloud standar; konfigurasi advisor menggunakan advisor Managed Agents). Haijun Sonnet 4.6 menilai sebagai pengganti juri referensi dan benchmark dijalankan dengan alat, sehingga skor dapat dibandingkan antar-konfigurasi di sini tetapi tidak dengan leaderboard yang dipublikasikan. Skor ini juga tidak dapat dibandingkan dengan hasil Chartography dalam system card Haijun Opus 5.5, yang menggunakan penilai berbeda dan dijalankan pada effort
max. Dua eksekusi per konfigurasi (tiga untuk Haijun Opus 5.5), digabungkan; sebaran antar-eksekusi mencapai 10 poin. Biaya adalah yang ditagihkan kepada pelanggan yang menjalankan agen secara rutin: permintaan pertama setiap grafik membaca "system prompt" (prompt sistem) dan alat bersama milik agen dari cache, seperti yang terjadi ketika sesi lain dari agen yang sama berjalan dalam 5 menit sebelumnya. Grafik yang dijalankan tersendiri berbiaya sekitar $0,03 lebih mahal dengan Haijun Opus 5 atau Haijun Opus 5.5 dan sekitar $0,12 lebih mahal dengan Haijun Fable 5.1. Angka Agustus dihitung ulang harganya dengan cara ini dari catatan penggunaan eksekusi; pengukuran milik organisasi evaluasi sendiri, yang hingga 10 September 2026 menagih pembacaan cache Haijun Opus 5 dalam blok 8.192 token, melebih-lebihkan biaya Haijun Opus 5. Biaya tidak mencakup waktu sandbox, yang menambahkan kurang dari 1% pada eksekusi Agustus. Eksekusi solo Haijun Fable 5.1 berasal dari 24 Agustus 2026, di bawah pengaturan serving peluncuran platform, dua eksekusi per pengaturan; enam percobaan mencapai batas sesi 15 menit dan mendapat skor 0, dan dua grafik per eksekusi dijawab oleh Haijun Opus 5 setelah penolakan keamanan. Executor Haijun Opus 5 dengan effort rendah dan advisor Haijun Fable 5.1 dijalankan dua kali pada 30 Agustus 2026, di bawah pengaturan yang sama (63,0 dan 67,0, rata-rata 65,0, dengan biaya $0,47 per grafik; advisor dikonsultasikan pada 88% tugas di setiap eksekusi, dan 4 dari 219 balasannya justru berasal dari Haijun Opus 5, masing-masing setelah filter keamanan produksi menghentikan balasan advisor itu sendiri). Haijun Opus 5.5 dijalankan padalow, dengan fallback sisi server dinonaktifkan dan classifier keamanan menilai setiap panggilan alat: tiga eksekusi sendiri (70, 68, dan 68) dan tiga dengan advisor Haijun Fable 5.1 yang dikonfigurasi (59, 63, dan 63), di mana model tersebut berkonsultasi dengan advisor pada 1 dari 300 tugas. Perbandingan tingkat konsultasi untuk pasangan sebelumnya berasal dari menjalankan ulang konfigurasi yang sama di Messages API dengan set alat container, 10 hingga 11 Agustus 2026.
- Evaluasi audit prompt support desk: Set berisi 44 tiket dukungan yang disusun Juglow dengan penilaian deterministik, dijalankan pada awal Agustus 2026 dan dilaporkan pada 8 Agustus 2026, di bawah enam prompt sistem, masing-masing menambahkan ke prompt bersih yang sama satu pola yang umum dalam prompt yang ditulis untuk Haijun Opus 4.8 dan Haijun Sonnet 4.6. Setiap titik grafik adalah salah satu dari tiga kasus (model lama, model baru pada prompt yang sama, model baru setelah audit) yang dirata-ratakan atas enam prompt dan 44 tiket. Peningkatan akurasi Opus 5 memiliki interval kepercayaan 95% sebesar 3 hingga 8 poin; perbedaan akurasi Sonnet berada dalam batas noise.
- Set pertanyaan file data: Set berisi 25 pertanyaan agregat yang disusun Juglow atas irisan 1.862 baris dari CSV penjualan minuman keras publik, dengan ground truth yang dihitung oleh pandas dan penilaian exact-match, dijalankan pada Haijun Sonnet 5 dan Haijun Opus 5 dengan thinking dinonaktifkan (kelompok uji in-context tidak dapat selesai pada default), batas output 4.000 token, dan tanpa "prompt caching" (caching prompt), tiga eksekusi per konfigurasi, dijalankan 19 Agustus 2026. Kelompok uji file mengunggah CSV melalui Files API dan menggunakan alat
code_execution_20260120.
- Pengukuran durasi cache: Pekerjaan triase 20 issue dari Pangkas token input dan konteks, dijalankan pada Haijun Sonnet 5 pada 23 Agustus 2026, dan pada Haijun Opus 5.5 pada 19 dan 20 September 2026, pada effort default-nya (
medium) dan padahigh, di Messages API dengan harness yang sama (untuk Haijun Opus 5.5, port dari harness tersebut yang mengirim body permintaan yang sama), dengan sel Haijun Opus 5.5 menggunakanmax_tokensyang dinaikkan menjadi 4.096, dan dengan jeda yang disisipkan sebelum sebagian giliran yang dipilih secara acak (tanpa jeda, 5%, 10%, dan jeda 6 menit sebelum setiap giliran pada seluruh 20 issue di kedua model, ditambah jeda 2 menit sebelum setiap giliran pada Haijun Sonnet 5; jeda 20 menit dan 45 menit pada subset 5 issue di kedua model). Angka keep-alive Haijun Opus 5 di bawah berasal dari pekerjaan yang sama pada 23 Agustus 2026, denganmax_tokensdinaikkan menjadi 4.096, pada jadwal yang sama kecuali jeda 2 menit dan 45 menit. Tiga eksekusi per sel, biaya dihitung dari fieldusagesetiap respons pada harga daftar (untuk Haijun Opus 5.5, $4 input, $5 penulisan 5 menit, $8 penulisan 1 jam, $0,20 pembacaan cache, dan $20 output per juta token; Haijun Sonnet 5 dijalankan pada organisasi internal Juglow yang penggunaannya diukur dengan cara yang sama seperti organisasi pelanggan), dengan akurasi diukur terhadap label gold yang sama. Angka Haijun Opus 5.5 di halaman ini mencakup kedua tingkat effort. Titik persilangan berada di sekitar 3,3% giliran pada Haijun Sonnet 5 dan 3,1% hingga 3,2% pada Haijun Opus 5.5: median dari porsi titik impas setiap sesi, dihitung oleh model biaya dari ukuran konteks giliran demi giliran sesi tersebut, atas seluruh 45 sesi dua puluh issue Haijun Sonnet 5 dan 36 sesi dua puluh issue Haijun Opus 5.5 pada setiap tingkat effort (setiap jadwal jeda dijalankan pada pekerjaan penuh, di bawah ketiga pengaturan cache, masing-masing tiga eksekusi; sel 5 issue tidak termasuk). Pada sel 5%, pengaturan 5 menit dan 1 jam seri pada Haijun Sonnet 5, karena jeda pada undian tersebut jatuh pada prefiks kecil; pada Haijun Opus 5.5 keduanya hampir seri. Aturan 1-dari-20 di halaman ini berada di atas titik persilangan yang diukur. Waktu hingga token pertama Haijun Opus 5.5 setelah jeda tidak diukur. Juglow mengukur permintaan keep-alive yang menyegarkan cache 5 menit pada Haijun Sonnet 5 dan Haijun Opus 5 pada 23 Agustus 2026, dan pada Haijun Opus 5.5 dalam eksekusi di atas, yang selalu dikirim denganmax_tokens: 1. Pada Haijun Sonnet 5, biayanya 7,7% lebih rendah daripada pengaturan 1 jam dengan 5% giliran dijeda dan kurang lebih sama dengan 10%; pada Haijun Opus 5 tidak ada perbedaan yang dapat diukur pada kedua porsi tersebut; pada keduanya biayanya lebih tinggi dengan jeda 6 menit atau lebih sebelum setiap giliran. Pada Haijun Opus 5.5, biayanya 8% hingga 18% lebih rendah daripada pengaturan 1 jam dengan 5% dan 10% giliran dijeda (sekitar 10% hingga 15% setelah noise antar-sesi dihilangkan dengan menagih ulang token milik setiap sesi keep-alive pada harga cache 1 jam), dan lebih tinggi dengan jeda sebelum setiap giliran: 4% hingga 6% lebih tinggi pada 6 menit, 9% hingga 10% pada 20 menit, dan 56% hingga 58% pada 45 menit. Keep-alive menghemat lebih banyak pada Haijun Opus 5.5 karena setiap permintaan keep-alive membaca ulang prefiks pada harga pembacaan cache: 0,05x harga input, dibandingkan 0,1x pada Haijun Sonnet 5 dan Haijun Opus 5; sesi Haijun Opus 5, yang ditagih ulang pada harga Haijun Opus 5.5, menunjukkan penghematan yang hampir sama dengan Haijun Opus 5.5. Pengujian API pra-peluncuran Juglow pada Haijun Opus 5.5 menunjukkan bahwa permintaanmax_tokens: 0menulis cache dan permintaan berikutnya membacanya; apakah permintaan semacam itu menyegarkan entri yang sudah ada tidak diukur pada Opus 5.5. Pada Haijun Fable 5.1, dengan 0,025x, keep-alive lebih murah bahkan dengan jeda sebelum setiap giliran, kecuali pada jeda 45 menit (referensi 19).
- Porsi pembacaan cache di produksi: Penggunaan Haijun API pihak pertama teragregasi selama 14 hari yang berakhir 23 Agustus 2026, hanya produk API langsung, organisasi internal Juglow dikecualikan, tanpa mengidentifikasi organisasi mana pun. Sebuah hari-organisasi dihitung sebagai loop agen ketika permintaannya membawa definisi alat dan hasil alat, prompt-nya memuat rata-rata 9 atau lebih panggilan alat sebelumnya, caching digunakan, dan organisasi tersebut membuat setidaknya 10 permintaan semacam itu (API tidak memiliki pengidentifikasi percakapan, sehingga ini menjadi pengganti panjang percakapan): 303.003 hari-organisasi di 106.487 organisasi, median porsi pembacaan cache 84,2% dari seluruh token input, kuartil atas 91,7%. Label kasus penggunaan (kasus penggunaan yang dinyatakan organisasi, atau jika tidak ada, kasus penggunaan hasil klasifikasi) mencakup 74% dari hari-organisasi tersebut dan 99% tokennya; organisasi coding menyumbang 87% token input agentik dan membaca median 88,5% (90,9% pada 25 atau lebih panggilan alat sebelumnya), kuartil atas 93,4%, dengan sekitar 72% hari-organisasi coding berada pada 80% atau lebih; agen dukungan, riset, dan data membaca 84% hingga 85%. Desil teratas hari-organisasi membaca 95,9% atau lebih untuk coding dan 94,2% hingga 94,8% untuk agen dukungan, riset, data, dan lainnya. Pembagian tingkat permintaan pada 25 atau lebih panggilan alat sebelumnya berasal dari sampel enam jam: coding 92% pembacaan, 7% penulisan, kurang dari 1% tanpa cache. Organisasi tanpa label, sebagian besar berukuran kecil, membaca median 11%. Hari-organisasi tanpa definisi alat membaca median 34,6%. Kueri independen atas jendela waktu yang sama yang merekonstruksi percakapan berisi 10 atau lebih permintaan, alih-alih menilai hari-organisasi, menempatkan median pada 90,2%; perbedaannya terletak pada cakupan, bukan data.
- Pengukuran waktu compaction: Varian panjang agen triase dari Pangkas token input dan konteks, dijalankan 24 Agustus 2026, pada Haijun Sonnet 5 dengan cache 5 menit, biaya dari field usage pada harga daftar, lima sesi per kelompok uji: kelompok uji tanpa perubahan pada effort default sepanjang sesi ($0,81 per sesi), dan dua kelompok uji yang dimulai pada effort rendah dan membuat dua perubahan pemecah cache yang sama, yaitu peralihan ke effort default dan satu alat tambahan, baik di tengah sesi pada permintaan 12 dan 17 ($0,95) maupun bersamaan pada permintaan pertama setelah "compaction" (pemadatan) pertama ($0,75). Kelompok uji keempat berisi enam sesi, dijalankan 25 Agustus 2026, membuat dua perubahan yang sama pada permintaan yang memicu compaction pertama ($0,92 per sesi): proses peringkasan pada permintaan tersebut menulis konteks 81.000 token ke cache alih-alih membacanya, sehingga proses tersebut berbiaya $0,21 dibandingkan $0,04 untuk proses yang sama pada kelompok uji batas. Sesi pertama kali melakukan compaction pada permintaan 21 hingga 25 (16 dari 21 sesi pada permintaan 22), setelah prompt melewati pemicu compaction 80.000 token, dan dua sesi tanpa perubahan melakukan compaction untuk kedua kalinya menjelang akhir. Total kelompok uji batas yang lebih rendah daripada kelompok uji tanpa perubahan mencerminkan permintaan effort rendahnya sebelum perubahan dan compaction kedua tersebut, bukan caching: biaya penulisan ulang kedua kelompok uji berbeda kurang dari satu sen. Kelompok uji tengah sesi membayar $0,23 per sesi untuk penulisan ulang cache; selisih antara kelompok uji tengah sesi dan kelompok uji batas adalah $0,20 dengan interval kepercayaan 95% sebesar $0,11 hingga $0,29. Satu sesi pada kelompok uji tengah sesi berbiaya murah ($0,82) setelah modelnya salah memanggil alat pencarian setelah compaction dan mendapatkan hasil kosong; sesi ini disertakan, dan tanpanya kelompok uji tersebut rata-rata $0,98. Akurasi rata-rata 14,2 dari 20 label di setiap kelompok uji 24 Agustus dan 14,7 di kelompok uji 25 Agustus; pembacaan cache mencakup 91% token prompt tanpa perubahan, 85% pada perubahan di tengah sesi, 91% pada batas, dan 86% dengan perubahan pada permintaan pemicu.
- Pengukuran durasi cache pada Haijun Fable 5.1: Pekerjaan triase 20 issue dan harness yang sama seperti referensi 16, dijalankan 23 Agustus dan 26 Agustus 2026, pada snapshot peluncuran Haijun Fable 5.1 dengan harga peluncurannya ($10 input, $12,50 penulisan 5 menit, $20 penulisan 1 jam, $0,25 pembacaan cache, $50 output per juta token), tiga pengaturan per jadwal: cache 5 menit, cache 1 jam, dan cache 5 menit yang dijaga tetap hangat oleh permintaan
max_tokens: 0pada prefiks yang tidak berubah setiap 4 menit, dihitung dari awal permintaan sebelumnya (eksekusi 23 Agustus mengirim permintaan keep-alive denganmax_tokens: 1; pada sel 26 Agustus yang dilaporkan di sini, setiap permintaan keep-alive menyegarkan cache dan tidak menagih output). Jadwal: tanpa jeda, 10% giliran, dan jeda 6 menit sebelum setiap giliran pada seluruh 20 issue, serta jeda 45 menit pada subset 5 issue; tiga eksekusi per sel (enam untuk sel keep-alive 26 Agustus dengan jeda 45 menit), biaya dihitung dari fieldusagesetiap respons pada harga daftar, dengan akurasi diukur terhadap label gold yang sama (12 hingga 17 label tepat dari 20). Rata-rata per sesi pada 26 Agustus untuk pengaturan 5 menit, 1 jam, dan keep-alive: tanpa jeda $2,42, $3,09, $2,29; 10% dijeda $4,50, $2,96, $2,36; setiap giliran $22,89, $3,01, $2,62; sel 23 Agustus sesuai dalam rentang 6%. Angka 45 menit ($1,68, $0,59, dan $0,71 per sesi 5 issue) berasal dari eksekusi ulang yang bersih pada 26 Agustus setelah insiden penagihan cache merusak sel-sel pertama hari itu; eksekusi 23 Agustus menghasilkan $1,67, $0,58, dan $0,70. Titik persilangan antara pengaturan 5 menit dan 1 jam adalah 3,1% giliran, dengan ukuran yang sama seperti referensi 16.
- Terminal-Bench 3: 74 tugas dari benchmark agen terminal publik, dijalankan di Haijun Managed Agents dengan dua alat kustom, yaitu shell dan editor file yang dijalankan harness evaluasi di container milik setiap tugas, sebagai pengganti alat bawaan platform, dan selebihnya pada pengaturan default platform untuk akun eksternal, dua eksekusi per model pada effort
high, 27 hingga 28 Agustus 2026. Eksekusi ini menggunakan Terminal-Bench versi 3.0, dan skornya tidak dapat dibandingkan dengan leaderboard Terminal-Bench publik maupun dengan hasil Terminal-Bench 4.0 dalam system card Haijun Opus 5.5, yang berasal dari eksekusi di Haijun Code pada effortmax. Batas waktu setiap tugas adalah 2,5 kali batas milik benchmark, yang memberi agen antara 75 menit dan 20 jam per tugas (5 jam untuk tugas median), dan setiap tugas mendapat tiga kali memori yang ditentukannya, dari 6 GiB hingga 96 GiB, dengan memori tambahan untuk 12 tugas yang menjalankan layanan pembantu. Agen tidak memiliki akses internet umum: container-nya dapat menjangkau mirror paket internal, daftar pendek situs unduhan termasuk GitHub dan Python Package Index, serta beberapa situs khusus untuk sebagian tugas, dan delapan tugas tidak memiliki akses jaringan sama sekali. Skor adalah tingkat kelulusan mentah atas 148 percobaan per model; eksekusi tunggal berfluktuasi 5 hingga 11 poin. Biaya adalah yang akan ditagihkan kepada pelanggan pada harga daftar, dihitung ulang permintaan demi permintaan dari catatan penggunaan eksekusi dengan masa berlaku cache 5 menit. Haijun Opus 4.7 mengakhiri 11 dari 148 percobaannya pada batas output-nya.
- DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. Ke-100 tugas risetnya di 10 domain dinilai terhadap rubrik yang ditulis pakar, dan skornya adalah skor ternormalisasi milik benchmark. Setiap konfigurasi dijalankan di Haijun API dengan Haijun Fable 5.1, adaptive thinking default, classifier keamanan produksi aktif, dan
max_tokenspada 128.000: agen tunggal pada efforthighdanmedium, agen tunggal padahighdengan instruksi dan jam, serta tim padahighdengan dan tanpa keduanya. Tim tersebut adalah agen utama yang memulai agen pembantu dari model yang sama melalui sebuah alat, tanpa batas jumlah. Pada DRACO, agen utama memulai median 4 pembantu per percobaan. Setiap konfigurasi melakukan tiga percobaan pada setiap tugas, dijalankan 8 hingga 10 September 2026. Percobaan yang mencapai batas empat jam dijalankan ulang, dan percobaan baru itulah yang dihitung. Satu-satunya percobaan yang dikecualikan adalah ketiga percobaan pada satu tugas untuk agen tunggal pada effortmedium, sehingga konfigurasi tersebut mencakup 99 tugas. Tugas tersebut mengalami timeout pada setiap percobaan, baik pada eksekusi asli maupun eksekusi ulang. Menilai 3 percobaan tersebut sebagai 0, seperti yang dilakukan penilaian milik benchmark, hanya memengaruhi dua perbandingan dengan effortmedium. Perubahan skor pada effortmediumdibandingkanhighbergeser dari 0,7 menjadi 1,7 poin lebih rendah, dan perubahan skor dengan kedua perubahan dibandingkan effortmediumbergeser dari 1,2 menjadi 0,2 poin lebih rendah. Agen menggunakan alat pencarian dan alat fetch yang di-host oleh harness evaluasi atas indeks web yang dipatok. Alat-alat tersebut menentukan sebagian waktu, dan alat Anda akan berjalan dengan kecepatan berbeda, sehingga halaman ini menyajikan waktu sebagai rasio antar-konfigurasi, bukan dalam menit. Waktu adalah waktu wall-clock per tugas, dari permintaan pertama hingga permintaan terakhir pada agen mana pun, dikurangi perkiraan waktu yang dihabiskan untuk menunggu sebelum mencoba ulang permintaan setelah error "rate limit" (batas laju) atau overload. Error tersebut berasal dari batas bersama akun pengujian. Semua konfigurasi dalam satu set dimulai bersamaan. Konfigurasi yang lebih lambat selesai berjam-jam kemudian, sehingga sebagian waktunya berjalan di bawah beban yang berbeda. Biaya setiap tugas adalah permintaannya yang dihitung pada harga daftar publik, dengan caching prompt ditagih seperti untuk pelanggan yang menetapkan cache breakpoint di akhir setiap permintaan dan menggunakan masa berlaku cache 5 menit, hanya untuk token model. Alat harness tidak menambahkan biaya. Perubahan skor adalah selisih berpasangan atas tugas, dengan interval bootstrap 95%. Suatu perubahan dianggap berada di dalam margin ketika intervalnya tetap dalam rentang 1,5 poin pada DRACO dan 2,5 poin pada HLE. Juglow menetapkan margin tersebut sebelum eksekusi. Haijun Opus 5 menilai jawaban. Dibandingkan dengan penilai milik setiap set, Opus 5 memberi skor 1,9 hingga 2,4 poin lebih tinggi pada DRACO, 2,2 hingga 2,9 poin lebih rendah pada HLE (Opus 5 menilai 495 dari 500 pertanyaan, dan penilai benchmark menilai seluruh 500), dan 1,3 hingga 2,0 poin lebih rendah pada set fisika, yang penilainya sendiri juga menggunakan solusi referensi pakar, di setiap konfigurasi. Kedua penilai sepakat tentang arah setiap perubahan.
- HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. Pertanyaan yang ditulis pakar dengan jawaban pasti, dinilai terhadap jawaban referensi. Diukur pada 500 pertanyaan pertama, dengan sumber milik benchmark diblokir dari pencarian, dan penyiapan yang sama seperti referensi 21. Setiap konfigurasi melakukan tiga percobaan pada setiap pertanyaan, dijalankan 8 hingga 10 September 2026. Haijun Opus 5 membandingkan setiap jawaban dengan jawaban referensi, dengan adaptive thinking aktif, sebagaimana default-nya. Juri menilai 495 dari 500 pertanyaan di setiap konfigurasi, dan skor mencakup 495 pertanyaan tersebut. Untuk 5 pertanyaan lainnya, permintaan penilaian melebihi batas 1M token milik juri. Percobaan yang mencapai batas empat jam dijalankan ulang, dan percobaan baru itulah yang dihitung, sehingga setiap konfigurasi memiliki seluruh 1.500 percobaan. Menilai 5 pertanyaan yang tidak dinilai sebagai 0, seperti yang dilakukan penilaian milik benchmark, tidak mengubah temuan apa pun.
- Set fisika: Set internal berisi 70 soal fisika tingkat riset, diadaptasi dari benchmark publik CritPt: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. Peninjau pakar mengoreksi pernyataan soal. Haijun Opus 5 menilai setiap jawaban terhadap solusi referensi pakar yang tidak dipublikasikan, sehingga skornya tidak dapat dibandingkan dengan hasil yang dipublikasikan. Skor adalah rata-rata nilai atas percobaan suatu soal, yang dirata-ratakan atas seluruh soal. Diukur pada seluruh 70 soal, empat percobaan per soal, dijalankan 8 hingga 9 September 2026. Setiap agen memiliki alat Python, shell, dan editor file dalam container sandbox tanpa akses jaringan, serta tanpa alat pencarian atau fetch. Selebihnya, penyiapannya sama dengan referensi 21. Tidak ada margin skor yang ditetapkan untuk set fisika sebelum eksekusi, sehingga halaman ini menyajikan perubahan skornya beserta interval 95%-nya dan tidak menggambarkannya sebagai berada di dalam margin.
Langkah selanjutnya
Keuntungan gratis terbesar di halaman ini: penyiapan, masa hidup, dan diagnostik.
Tukar kecerdasan dengan latensi dan biaya dalam satu model.
Evaluasi kemampuan, kecepatan, dan biaya di seluruh keluarga model Haijun.
Berikan loop agen hitung mundur token yang mereka atur sendiri.
Tetapkan batas dolar yang tegas pada sesi Managed Agents.
Lihat harga per token terkini untuk setiap model Haijun.
Terapkan tuas-tuas ini satu per satu pada agen yang berfungsi dalam notebook yang dapat dijalankan, dengan biaya per tugas setelah setiap langkah.
Tonton panduan langkah demi langkah tentang pola advisor dan orchestrator.