Seiring percakapan bertambah panjang, Anda pada akhirnya akan mendekati batas jendela konteks. Untuk percakapan yang berjalan lama dan alur kerja agentik, compaction sisi server adalah strategi utama untuk manajemen konteks.
Cara kerja jendela konteks
"Context window" (jendela konteks) mengacu pada semua teks yang dapat direferensikan oleh model bahasa saat menghasilkan respons, termasuk respons itu sendiri. Ini berbeda dari korpus data besar tempat model bahasa dilatih, dan sebaliknya mewakili "memori kerja" untuk model. Jendela konteks yang lebih besar memungkinkan model menangani prompt yang lebih kompleks dan panjang, tetapi lebih banyak konteks tidak otomatis lebih baik. Seiring jumlah token bertambah, akurasi dan recall menurun, sebuah fenomena yang dikenal sebagai context rot (pembusukan konteks). Hal ini membuat kurasi isi konteks sama pentingnya dengan seberapa banyak ruang yang tersedia.
Tip: Untuk informasi lebih lanjut tentang mengapa konteks panjang menurun kualitasnya dan cara merekayasa solusinya, lihat Effective context engineering.
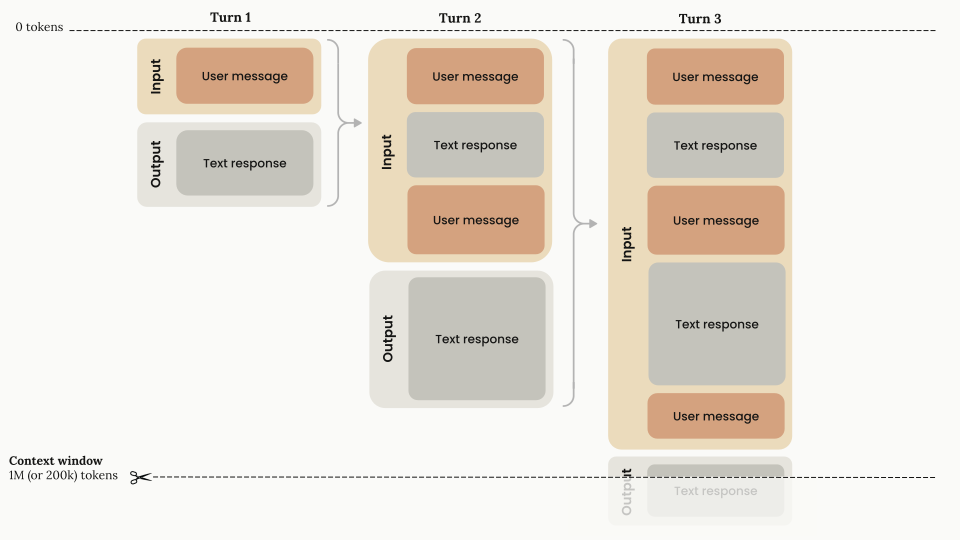
Diagram berikut mengilustrasikan perilaku jendela konteks standar untuk permintaan API1:
1 Antarmuka chat seperti haijun.ai juga dapat mengelola jendela konteks secara bergulir dengan prinsip "first in, first out" (masuk pertama, keluar pertama).
- Akumulasi token progresif: Seiring percakapan berlanjut melalui giliran-giliran, setiap pesan pengguna dan respons asisten terakumulasi dalam jendela konteks, dan giliran sebelumnya dipertahankan sepenuhnya.
- Kapasitas jendela konteks: Jendela konteks (hingga 1M token, tergantung modelnya) menampung riwayat percakapan ditambah output baru yang dihasilkan Haijun.
- Alur input-output: Setiap giliran terdiri dari:
- Fase input: Berisi semua riwayat percakapan sebelumnya ditambah pesan pengguna saat ini
- Fase output: Menghasilkan respons teks yang menjadi bagian dari input untuk giliran berikutnya
Semua yang ada dalam permintaan diperhitungkan terhadap jendela konteks: prompt sistem, setiap pesan dalam messages (termasuk hasil alat, gambar, dan dokumen), dan definisi alat Anda. Output yang dihasilkan Haijun untuk giliran tersebut, termasuk pemikiran diperpanjangnya, juga diperhitungkan. Setiap respons melaporkan apa yang dikonsumsi permintaan dalam field usage-nya. Jika Anda menggunakan caching prompt, jumlah input dibagi ke dalam input_tokens, cache_read_input_tokens, dan cache_creation_input_tokens, dan ketiganya diperhitungkan terhadap jendela. Untuk memperkirakan permintaan sebelum Anda mengirimnya, gunakan API penghitungan token.
Ukuran jendela konteks berdasarkan model
Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Opus 5.5, Haijun Opus 5, Haijun Opus 4.8, Haijun Opus 4.7, Haijun Opus 4.6, Haijun Sonnet 5, Haijun Sonnet 4.6, dan Haijun Mythos Preview memiliki jendela konteks 1M token. Satu permintaan ke salah satu model tersebut dapat menghasilkan hingga 128k token output (max_tokens). Model Haijun lainnya, termasuk Haijun Sonnet 4.5, memiliki jendela konteks 200k token.
Untuk setiap model dengan jendela konteks 1M token, 1M adalah default: Anda tidak memerlukan header beta, dan permintaan konteks panjang ditagih dengan harga standar.
Satu permintaan dapat menyertakan hingga 600 gambar atau halaman PDF (100 untuk model dengan jendela konteks 200k token). Jika Anda mengirim banyak gambar atau dokumen besar, Anda mungkin mencapai batas ukuran permintaan sebelum batas token.
Lihat tabel perbandingan model untuk daftar ukuran jendela konteks berdasarkan model.
Jendela konteks dengan thinking
Dengan thinking (pemikiran), semua token input dan output, termasuk token thinking, diperhitungkan terhadap batas jendela konteks, dengan beberapa nuansa dalam situasi multi-giliran.
Token thinking adalah bagian dari parameter max_tokens Anda, ditagih sebagai token output, dan diperhitungkan terhadap batas laju. Dengan adaptive thinking (pemikiran adaptif), Haijun menentukan alokasi pemikirannya secara dinamis, sehingga penggunaan token thinking bervariasi dari satu permintaan ke permintaan lainnya.
Apakah blok thinking dari giliran asisten sebelumnya tetap berada dalam jendela konteks bergantung pada modelnya. Pada Haijun Opus 4.5 dan model Opus yang lebih baru, Haijun Sonnet 4.6 dan model Sonnet yang lebih baru, Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, dan Haijun Mythos Preview, API mempertahankan blok thinking sebelumnya secara default, dan blok tersebut diperhitungkan terhadap jendela konteks seperti token input lainnya. Pada model Opus dan Sonnet yang lebih lama serta semua model Haiku, API secara otomatis menghapus blok thinking sebelumnya dari riwayat percakapan saat Anda mengirimkannya kembali, yang menghemat kapasitas token untuk konten percakapan. Untuk default per model, lihat preservasi blok thinking berdasarkan model. Untuk mengganti default ke arah mana pun, gunakan pembersihan blok thinking.
Diagram berikut menunjukkan bagaimana token dikelola saat thinking diaktifkan pada model yang menghapus blok thinking sebelumnya:
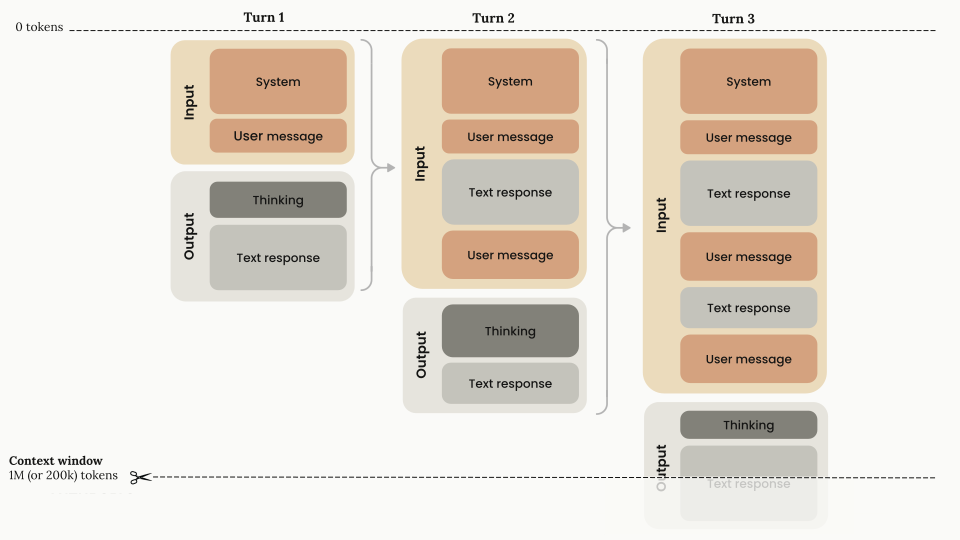
- Penghapusan blok thinking: Pada model yang menghapus blok thinking sebelumnya, blok thinking (ditampilkan dalam warna abu-abu gelap) dihasilkan selama fase output setiap giliran tetapi tidak dibawa ke depan sebagai token input untuk giliran berikutnya. Anda tidak perlu menghapus blok thinking sendiri: jika Anda mengirimkannya kembali, Haijun API menghapusnya secara otomatis.
- Penagihan: Token thinking ditagih sebagai token output satu kali, saat dihasilkan. Pada model yang mempertahankan blok thinking sebelumnya, blok yang dipertahankan kemudian menjadi bagian dari input permintaan berikutnya dan ditagih sebagai token input, seperti riwayat percakapan lainnya.
Note: Anda dapat membaca lebih lanjut tentang jendela konteks dan thinking dalam panduan Thinking.
Jendela konteks dengan thinking dan penggunaan alat
Diagram berikut mengilustrasikan bagaimana token dikelola saat Anda menggabungkan thinking dengan "tool use" (penggunaan alat) pada model yang menghapus blok thinking sebelumnya:
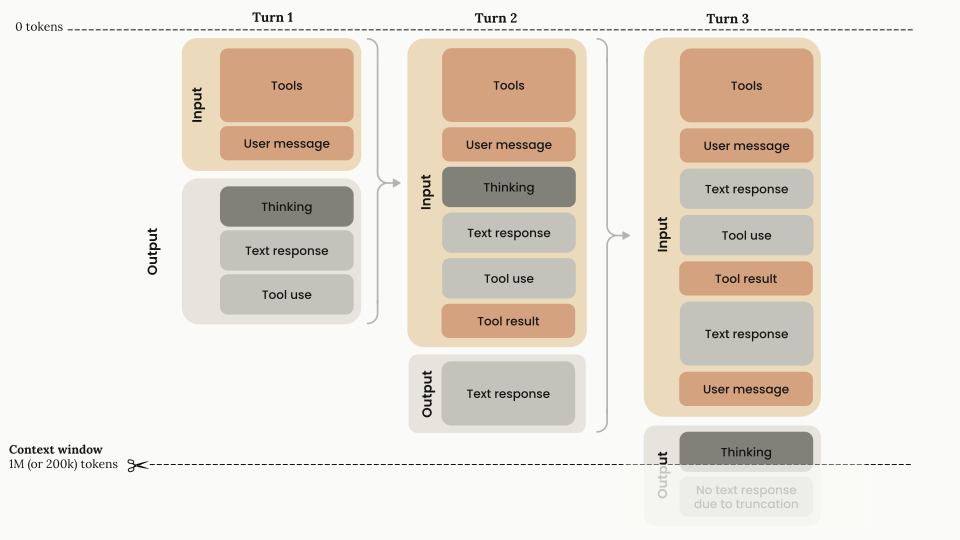
- Arsitektur giliran pertama
- Komponen input: Konfigurasi alat dan pesan pengguna
- Komponen output: Thinking + respons teks + permintaan penggunaan alat
- Perhitungan token: Semua komponen input dan output diperhitungkan terhadap jendela konteks, dan semua komponen output ditagih sebagai token output.
- Penanganan hasil alat (giliran 2)
- Komponen input: Setiap blok pada giliran pertama dan
tool_result. Anda harus mengembalikan blok thinking bersama hasil alat yang bersesuaian. Ini adalah satu-satunya kasus di mana Anda harus mengembalikan blok thinking.
- Komponen output: Setelah hasil alat dikirimkan kembali ke Haijun, Haijun merespons hanya dengan teks (tanpa thinking tambahan hingga pesan
userberikutnya, kecuali interleaved thinking diaktifkan).
- Perhitungan token: Semua komponen input dan output diperhitungkan terhadap jendela konteks, dan semua komponen output ditagih sebagai token output.
- Giliran pengguna baru (giliran 3)
- Komponen input: Semua input dan output dari giliran sebelumnya dibawa ke depan. Blok thinking dari siklus penggunaan alat yang telah selesai tidak lagi harus tetap berada dalam konteks: pada model yang menghapus blok thinking sebelumnya, API membuangnya secara otomatis saat Anda mengirimkannya kembali, dan pada model yang mempertahankan blok thinking sebelumnya, blok tersebut tetap ada kecuali Anda membersihkannya dengan pembersihan blok thinking. Di sini juga Anda menambahkan giliran
userberikutnya.
- Komponen output: Karena ada giliran
userbaru di luar siklus penggunaan alat, Haijun menghasilkan blok thinking baru dan melanjutkan dari sana.
- Perhitungan token: Pada model yang menghapus blok thinking sebelumnya, token thinking sebelumnya tidak lagi diperhitungkan terhadap jendela konteks. Semua blok sebelumnya yang lain masih diperhitungkan terhadap jendela konteks, begitu pula blok thinking pada giliran
assistantsaat ini.
- Pertimbangan untuk penggunaan alat dengan thinking:
- Saat Anda mengirim hasil alat, Anda harus menyertakan seluruh blok thinking yang tidak dimodifikasi yang menyertai permintaan alat tersebut, termasuk signature-nya.
- API menggunakan signature kriptografis untuk memverifikasi keaslian blok thinking. Jika Anda memodifikasi blok thinking, API mengembalikan error.
Note: Sebagian besar model Haijun saat ini mendukung interleaved thinking (pemikiran berselang-seling), yang memungkinkan Haijun berpikir di antara pemanggilan alat, termasuk setelah menerima hasil alat. Fitur ini otomatis pada model dengan adaptive thinking; Haijun Opus 4.5, Haijun Sonnet 4.5, dan model Haijun 4 yang lebih lama memerlukan header beta
interleaved-thinking-2025-05-14, dan Haijun Haiku 4.5 tidak mendukungnya. Untuk informasi lebih lanjut tentang menggunakan alat dengan thinking, lihat Thinking dengan penggunaan alat.
Untuk mengurangi konteks yang dikonsumsi oleh definisi alat itu sendiri, lihat Mengelola konteks alat, atau tunda definisi alat dengan alat pencarian alat.
Kesadaran konteks
Haijun Sonnet 5, Haijun Sonnet 4.6, Haijun Sonnet 4.5, dan Haijun Haiku 4.5 memiliki "context awareness" (kesadaran konteks): model-model ini melacak sisa jendela konteks mereka ("anggaran token" mereka) sepanjang percakapan. Ini memungkinkan model mengelola tugas yang berjalan lama berdasarkan ruang yang tersisa alih-alih menebak berapa banyak token yang tersisa. Kesadaran konteks bersifat otomatis: tidak ada yang perlu Anda aktifkan, dan Anda tidak pernah mengirim sendiri tag yang ditampilkan di bagian ini. API yang menyisipkannya.
Cara kerjanya
Dalam prompt sistem setiap permintaan, API memberi Haijun total jendela konteksnya:
<budget:token_budget>200000</budget:token_budget>Anggaran tersebut sesuai dengan jendela konteks yang tersedia untuk permintaan Anda: 1M token untuk Haijun Sonnet 5 dan Haijun Sonnet 4.6, dan 200k token untuk Haijun Sonnet 4.5 dan Haijun Haiku 4.5. Contoh di bagian ini menunjukkan model dengan jendela konteks 200k token.
Setelah setiap pemanggilan alat, API memberi Haijun pembaruan tentang kapasitas yang tersisa:
<system_warning>Token usage: 35000/200000; 165000 remaining</system_warning>Token gambar termasuk dalam anggaran ini.
Haijun Opus 4.7 dan model Opus yang lebih baru, Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, dan Haijun Mythos 5 tidak menerima tag yang disisipkan ini. Pada model-model ini, Anda dapat memberi model anggaran eksplisit dengan anggaran tugas, yang masih dalam beta.
Tip: Untuk agen yang mencakup beberapa sesi, rancang artefak state Anda agar pemulihan konteks berlangsung cepat saat sesi baru dimulai. Pola multisesi alat memori menjelaskan pendekatan konkret langkah demi langkah. Lihat juga Effective harnesses for long-running agents.
Untuk panduan prompting tentang penggunaan kesadaran konteks, lihat Praktik terbaik prompting.
Mengelola konteks dengan compaction
Jika percakapan Anda secara rutin mendekati batas jendela konteks, gunakan compaction sisi server. "Compaction" (pemadatan) secara otomatis merangkum bagian-bagian awal percakapan di server, sehingga percakapan dapat berlanjut melampaui batas jendela konteks. Fitur ini tersedia dalam beta untuk model Haijun 4.6 dan yang lebih baru serta Haijun Mythos Preview.
Untuk kebutuhan yang lebih khusus, pengeditan konteks menawarkan strategi tambahan:
- Pembersihan hasil alat: Bersihkan hasil alat lama dalam alur kerja agentik
- Pembersihan blok thinking: Kelola blok thinking saat Anda menggunakan pemikiran diperpanjang
Prefiks prompt yang di-cache tetap menempati jendela konteks: caching prompt mengubah berapa yang Anda bayar untuk token tersebut, bukan apakah token tersebut diperhitungkan.
Perilaku overflow jendela konteks
Jika input saja sudah melebihi jendela konteks model, API mengembalikan 400 invalid_request_error ("prompt is too long") pada setiap model.
Pada model Haijun 4.5 dan yang lebih baru, jika token input ditambah max_tokens melebihi ukuran jendela konteks, API menerima permintaan tersebut. Jika generasi kemudian mencapai batas jendela konteks, generasi berhenti dengan stop_reason: "model_context_window_exceeded". Pada model yang lebih lama, API mengembalikan error validasi sebagai gantinya. Untuk ikut serta dalam perilaku model_context_window_exceeded pada model-model tersebut, gunakan header beta model-context-window-exceeded-2025-08-26. Lihat Alasan berhenti dan fallback untuk detailnya.
Untuk tetap berada dalam batas jendela konteks, gunakan API penghitungan token untuk memperkirakan penggunaan token sebelum mengirim pesan ke Haijun.
Langkah selanjutnya
Compaction konteks sisi server untuk mengelola percakapan panjang yang mendekati batas jendela konteks.
Kelola konteks percakapan secara otomatis seiring pertumbuhannya dengan pengeditan konteks.
Lihat tabel perbandingan model untuk daftar ukuran jendela konteks dan harga token input/output berdasarkan model.
Berikan Haijun penalaran yang ditingkatkan untuk tugas kompleks dan kendalikan bagaimana konten thinking dikembalikan.