Note: Untuk mempelajari bagaimana "zero data retention" (retensi data nol), atau ZDR, berlaku untuk fitur ini, lihat API dan retensi data.
Model yang menjawab dalam satu kali proses harus melakukan semuanya dengan benar pada percobaan pertama: tanpa coretan kerja, tanpa pemeriksaan, dan tanpa mengubah arah di tengah jalan. Untuk sebuah pembuktian, bug yang rumit, atau tugas agentik yang panjang, pendekatan pertama sering kali bukan yang terbaik.
"Thinking" (pemikiran) menghilangkan batasan tersebut. Saat pemikiran aktif, Haijun mengerjakan masalah dengan kata-katanya sendiri sebelum menjawab. Haijun menyatakan ulang apa yang diminta, mencoba berbagai pendekatan, memeriksa hasil perantara, dan meninggalkan jalur yang tidak bertahan. Penalaran tersebut hadir dalam blok konten thinking sebelum respons, dan Haijun memanfaatkannya untuk menghasilkan jawaban akhir. Karena itulah pemikiran meningkatkan kinerja pada tugas kompleks seperti matematika, coding, analisis, dan pekerjaan agentik yang berjalan lama. Pada tugas-tugas ini, kualitas jawaban bergantung pada pekerjaan perantara yang tanpa pemikiran akan dipadatkan ke dalam respons itu sendiri atau dilewati.
Pemikiran memiliki biaya. Token yang dihabiskan Haijun untuk bernalar ditagih sebagai token output, bahkan ketika teks pemikiran tidak dikembalikan kepada Anda, dan token tersebut dihitung terhadap max_tokens bersama teks respons. Halaman ini membahas perilaku pemikiran di seluruh permukaan API: cara mengaktifkannya, membaca outputnya, dan mengelola interaksinya dengan alat, "streaming" (pengaliran), caching, dan "context window" (jendela konteks).
Cara kerja pemikiran
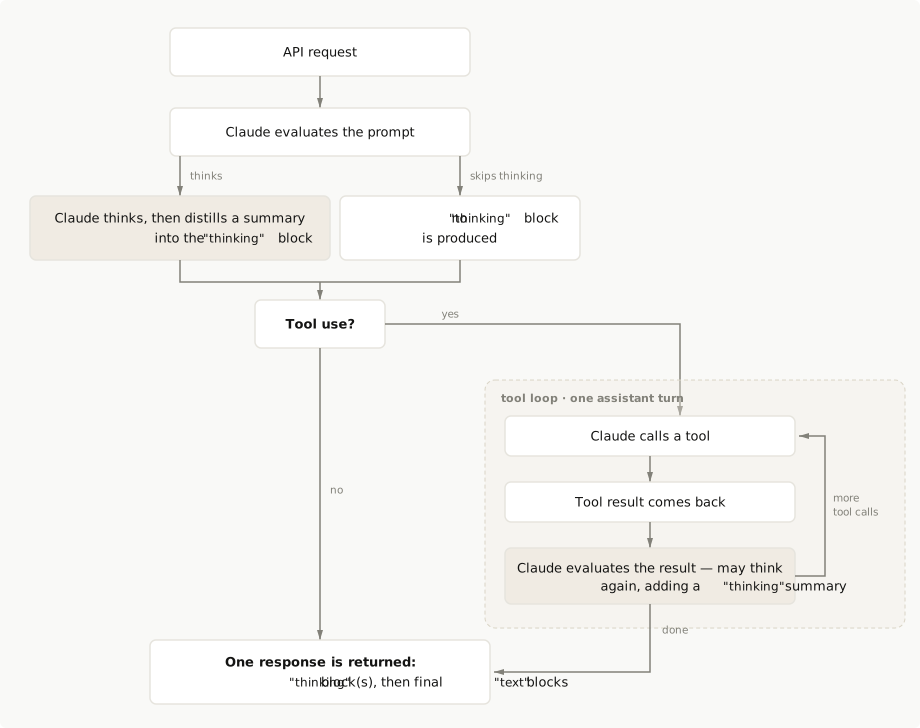
Apakah Haijun berpikir pada permintaan tertentu, dan seberapa dalam, bergantung pada konfigurasi pemikiran Anda dan kompleksitas permintaan.
Berikut tampilan pemikiran dalam sebuah respons: satu atau lebih blok konten thinking hadir sebelum blok text. Blok pemikiran tetap merupakan konten yang dihasilkan, sama seperti blok text yang mengikutinya, tetapi dipisahkan dari respons kanonis. Setiap blok pemikiran juga membawa field signature, yaitu salinan terenkripsi dari penalaran lengkap. Anda mengirimkan field ini kembali tanpa perubahan dalam percakapan multi-giliran dan percakapan dengan "tool use" (penggunaan alat) (lihat Enkripsi pemikiran):
{
  "content": [
    {
      "type": "thinking",
      "thinking": "Let me break this down. The question has two parts, so I'll start with the simpler one and use its result to constrain the second...",
      "signature": "WaUjzkypQ2mUEVM36O2Txu...."
    },
    {
      "type": "text",
      "text": "Based on my analysis..."
    }
  ]
}
Anda tidak selalu melihat teks ini, dan yang Anda lihat tidak pernah berupa rantai pemikiran mentah: teks dalam blok pemikiran adalah ringkasan penalaran Haijun. Field display pada konfigurasi pemikiran mengontrol apakah ringkasan tersebut dikembalikan atau tidak. "summarized" mengembalikannya, sedangkan "omitted", yang merupakan default pada banyak model, mengembalikan blok pemikiran dengan field thinking kosong. Dalam kedua kasus, blok tersebut ditagih dengan cara yang sama dan dikirimkan kembali dengan cara yang sama dalam percakapan multi-giliran. Lihat Mengontrol tampilan pemikiran untuk default per model dan detailnya.
Jika Haijun menggunakan alat, pemikiran juga dapat muncul di antara pemanggilan alat. Lihat Pemikiran dengan penggunaan alat. Untuk format respons lengkap, lihat referensi Messages API.
Mengonfigurasi pemikiran
Pada sebagian besar model, pemikiran sudah aktif secara default atau dapat diaktifkan dengan satu parameter. Konfigurasi yang diterima setiap model, beserta default-nya, tercantum dalam tabel konfigurasi per model di halaman Pemecahan Masalah.
Pada Haijun Opus 5.5, Haijun Opus 5, Haijun Sonnet 5, Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, dan Haijun Mythos Preview, pemikiran sudah aktif dan tidak memerlukan konfigurasi. display secara default bernilai "omitted" pada model-model ini, sehingga teks pemikiran disembunyikan sampai Anda memilih untuk menampilkannya. Untuk menampilkannya, gunakan thinking: {"type": "adaptive", "display": "summarized"}. Konfigurasi ini sama persis dengan permintaan berikut, hanya dengan string model yang diganti.
Pada Haijun Opus 4.8, Haijun Opus 4.7, Haijun Opus 4.6, dan Haijun Sonnet 4.6, pemikiran nonaktif hingga Anda menetapkan thinking: {type: "adaptive"}. Pengaturan ini memungkinkan Haijun memutuskan kapan dan seberapa dalam berpikir berdasarkan permintaan. Contoh berikut menerapkan pengaturan tersebut, menetapkan display: "summarized" agar teks pemikiran terlihat, dan menggunakan max_tokens yang lapang:
  curl https://haijun.my.id/v1/messages \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{
      "model": "haijun-opus-4-8",
      "max_tokens": 16000,
      "thinking": {
        "type": "adaptive",
        "display": "summarized"
      },
      "messages": [
        {
          "role": "user",
          "content": "What is the greatest common divisor of 1071 and 462?"
        }
      ]
}' ant messages create \
--model haijun-opus-4-8 \
--max-tokens 16000 \
--thinking '{type: adaptive, display: summarized}' \
--message '{role: user, content: "What is the greatest common divisor of 1071 and 462?"}' \
--transform content \
--format yaml client = juglow.Juglow()
response = client.messages.create(
model="haijun-opus-4-8",
max_tokens=16000,
thinking={"type": "adaptive", "display": "summarized"},
messages=[
{
"role": "user",
"content": "What is the greatest common divisor of 1071 and 462?",
}
],
)
for block in response.content:
match block.type:
case "thinking":
print(f"\nThinking: {block.thinking}")
case "text":
print(f"\nResponse: {block.text}") const client = new Juglow();
const response = await client.messages.create({
model: "haijun-opus-4-8",
max_tokens: 16000,
thinking: {
type: "adaptive",
display: "summarized"
},
messages: [
{
role: "user",
content: "What is the greatest common divisor of 1071 and 462?"
}
]
});
for (const block of response.content) {
switch (block.type) {
case "thinking":
console.log(`\nThinking: ${block.thinking}`);
break;
case "text":
console.log(`\nResponse: ${block.text}`);
break;
}
} JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus4_8,
MaxTokens = 16000,
Thinking = new ThinkingConfigAdaptive { Display = Display.Summarized },
Messages = [
new() {
Role = Role.User,
Content = "What is the greatest common divisor of 1071 and 462?"
}
]
};
var message = await client.Messages.Create(parameters);
foreach (var block in message.Content)
{
if (block.TryPickThinking(out ThinkingBlock? thinking))
{
Console.WriteLine($"\nThinking: {thinking.Thinking}");
}
else if (block.TryPickText(out TextBlock? text))
{
Console.WriteLine($"\nResponse: {text.Text}");
}
} client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus4_8,
MaxTokens: 16000,
Thinking: juglow.ThinkingConfigParamUnion{
OfAdaptive: &juglow.ThinkingConfigAdaptiveParam{
Display: juglow.ThinkingConfigAdaptiveDisplaySummarized,
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("What is the greatest common divisor of 1071 and 462?")),
},
})
if err != nil {
log.Fatal(err)
}
for _, block := range response.Content {
switch v := block.AsAny().(type) {
case juglow.ThinkingBlock:
fmt.Printf("\nThinking: %s", v.Thinking)
case juglow.TextBlock:
fmt.Printf("\nResponse: %s", v.Text)
}
} import com.juglow.models.messages.ThinkingConfigAdaptive;
void main() {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_4_8)
.maxTokens(16000L)
.thinking(ThinkingConfigAdaptive.builder()
.display(ThinkingConfigAdaptive.Display.SUMMARIZED)
.build())
.addUserMessage("What is the greatest common divisor of 1071 and 462?")
.build();
Message response = client.messages().create(params);
response.content().forEach(block -> {
block.thinking().ifPresent(thinkingBlock ->
IO.println("\nThinking: " + thinkingBlock.thinking())
);
block.text().ifPresent(textBlock ->
IO.println("\nResponse: " + textBlock.text())
);
});
} use Juglow\Messages\TextBlock;
use Juglow\Messages\ThinkingBlock;
$client = new Client();
$message = $client->messages->create(
maxTokens: 16000,
messages: [
[
'role' => 'user',
'content' => 'What is the greatest common divisor of 1071 and 462?'
]
],
model: 'haijun-opus-4-8',
thinking: ['type' => 'adaptive', 'display' => 'summarized'],
);
foreach ($message->content as $block) {
switch (true) {
case $block instanceof ThinkingBlock:
echo "\nThinking: " . $block->thinking;
break;
case $block instanceof TextBlock:
echo "\nResponse: " . $block->text;
break;
}
} client = Juglow::Client.new
message = client.messages.create(
model: "haijun-opus-4-8",
max_tokens: 16000,
thinking: {
type: "adaptive",
display: "summarized"
},
messages: [
{
role: "user",
content: "What is the greatest common divisor of 1071 and 462?"
}
]
)
message.content.each do |block|
case block
when Juglow::Models::ThinkingBlock
puts "\nThinking: #{block.thinking}"
when Juglow::Models::TextBlock
puts "\nResponse: #{block.text}"
end
endMenjalankan contoh ini akan mencetak pemikiran yang diringkas, lalu jawabannya:
Thinking: Use Euclidean algorithm.
1071 = 2*462 + 147
462 = 3*147 + 21
147 = 7*21 + 0
GCD = 21

Response: ## Finding GCD of 1071 and 462

I'll use the **Euclidean algorithm**, repeatedly dividing and taking remainders...
Token pemikiran dihitung terhadap max_tokens, jadi tetapkan nilainya cukup tinggi agar tersedia ruang untuk pemikiran dan teks respons. Lihat Kontrol biaya di halaman pengarahan dan Pemikiran dan jendela konteks.
Menonaktifkan pemikiran
Pada Haijun Sonnet 5, yang pemikirannya aktif secara default, Anda dapat menonaktifkannya:
  curl https://haijun.my.id/v1/messages \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{
      "model": "haijun-sonnet-5",
      "max_tokens": 4096,
      "thinking": {"type": "disabled"},
      "messages": [
        {
          "role": "user",
          "content": "Summarize this article in one sentence."
        }
      ]
}' ant messages create \
--model haijun-sonnet-5 \
--max-tokens 4096 \
--thinking '{type: disabled}' \
--message '{role: user, content: "Summarize this article in one sentence."}' client = juglow.Juglow()
response = client.messages.create(
model="haijun-sonnet-5",
max_tokens=4096,
thinking={"type": "disabled"},
messages=[{"role": "user", "content": "Summarize this article in one sentence."}],
) const client = new Juglow();
const response = await client.messages.create({
model: "haijun-sonnet-5",
max_tokens: 4096,
thinking: { type: "disabled" },
messages: [{ role: "user", content: "Summarize this article in one sentence." }]
}); JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunSonnet5,
MaxTokens = 4096,
Thinking = new ThinkingConfigDisabled(),
Messages = [
new() {
Role = Role.User,
Content = "Summarize this article in one sentence."
}
]
};
var message = await client.Messages.Create(parameters); client := juglow.NewClient()
response, err := client.Messages.New(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunSonnet5,
MaxTokens: 4096,
Thinking: juglow.ThinkingConfigParamUnion{
OfDisabled: &juglow.ThinkingConfigDisabledParam{},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("Summarize this article in one sentence.")),
},
})
if err != nil {
log.Fatal(err)
} import com.juglow.models.messages.ThinkingConfigDisabled;
void main() {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_SONNET_5)
.maxTokens(4096L)
.thinking(ThinkingConfigDisabled.builder().build())
.addUserMessage("Summarize this article in one sentence.")
.build();
Message response = client.messages().create(params);
} $client = new Client();
$message = $client->messages->create(
maxTokens: 4096,
messages: [
[
'role' => 'user',
'content' => 'Summarize this article in one sentence.'
]
],
model: 'haijun-sonnet-5',
thinking: ['type' => 'disabled'],
); client = Juglow::Client.new
message = client.messages.create(
model: "haijun-sonnet-5",
max_tokens: 4096,
thinking: { type: "disabled" },
messages: [
{
role: "user",
content: "Summarize this article in one sentence."
}
]
)Haijun Opus 5 juga memiliki pemikiran yang aktif secara default dan menerima thinking: {type: "disabled"} pada effort (upaya) high atau lebih rendah. Pada effort xhigh atau max, pemikiran tidak dapat dinonaktifkan. Permintaan yang menggabungkan thinking: {type: "disabled"} dengan tingkat effort tersebut akan mengembalikan error 400. Pembatasan ini diberlakukan pada setiap permintaan. Dengan pemikiran dinonaktifkan, Haijun Opus 5 sesekali dapat mengeluarkan pemanggilan alat sebagai teks biasa atau menyertakan tag XML internal dalam output yang terlihat. Lihat Menjalankan dengan pemikiran dinonaktifkan untuk mitigasi melalui prompt.
Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Opus 5.5, dan Haijun Mythos Preview menolak thinking: {type: "disabled"}. Pemikiran tidak dapat dinonaktifkan pada model-model ini.
Jika model Anda hanya mendukung "extended thinking" (pemikiran diperpanjang) (lihat tabel konfigurasi per model), konfigurasikan dengan type: "enabled" dan nilai budget_tokens. Halaman Pemikiran diperpanjang membahas konfigurasi tersebut. Jika konfigurasi pemikiran apa pun menghasilkan error 400, halaman Pemecahan masalah pemikiran mencocokkan setiap pesan error dengan perbaikannya.
Membaca output pemikiran
Mengontrol tampilan pemikiran
Field display pada konfigurasi pemikiran mengontrol cara konten pemikiran dikembalikan dalam respons API. display berfungsi di kedua mode, jadi Anda dapat menetapkannya bersama type: "adaptive" atau type: "enabled". Field ini menerima nilai-nilai berikut:
"summarized": blok pemikiran berisi teks pemikiran yang diringkas, yaitu ringkasan penalaran Haijun yang mudah dibaca. Ini adalah default pada Haijun Opus 4.6, Haijun Sonnet 4.6, dan model-model sebelumnya.
"omitted": blok pemikiran dikembalikan dengan fieldthinkingyang kosong. Fieldsignaturetetap membawa pemikiran lengkap yang terenkripsi untuk kesinambungan multi-giliran (lihat Enkripsi pemikiran). Ini adalah default pada Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Opus 5.5, Haijun Opus 5, Haijun Sonnet 5, Haijun Opus 4.8, Haijun Opus 4.7, dan Haijun Mythos Preview.
"updates"(beta): blok penalaran dikembalikan dengan fieldthinkingyang kosong, sama seperti"omitted". Namun, pembaruan progres singkat yang ditulis beberapa model di antara pemanggilan alat dikembalikan sebagai teks yang dapat dibaca. Nilai ini memerlukan header betathinking-display-updates-2026-08-18.
Tetapkan display: "omitted" jika aplikasi Anda tidak menampilkan konten pemikiran kepada pengguna. Manfaat utamanya adalah "time-to-first-text-token" (waktu hingga token teks pertama) yang lebih cepat saat streaming. Server sepenuhnya melewati streaming token pemikiran dan hanya mengirimkan signature, sehingga respons teks akhir mulai di-stream lebih cepat.
Dengan display: "omitted", respons berisi blok thinking dengan field thinking kosong:
{
  "content": [
    {
      "type": "thinking",
      "thinking": "",
      "signature": "EosnCkYICxIMMb3LzNrMu..."
    },
    {
      "type": "text",
      "text": "The answer is 12,231."
    }
  ]
}
Perhatikan hal-hal berikut saat bekerja dengan pemikiran yang dihilangkan:
- Anda tetap dikenakan biaya untuk seluruh token pemikiran. Menghilangkan pemikiran mengurangi "latency" (latensi), bukan biaya.
- Jika Anda mengirimkan kembali blok pemikiran dalam percakapan multi-giliran, kirimkan tanpa perubahan. Server mendekripsi
signatureuntuk merekonstruksi pemikiran asli saat menyusun prompt (lihat Mempertahankan blok pemikiran). Teks apa pun yang Anda tempatkan di fieldthinkingpada blok omitted yang dikirim kembali akan diabaikan.
displaytidak valid jika digunakan denganthinking.type: "disabled"(tidak ada yang perlu ditampilkan).
- Saat menggunakan
thinking.type: "adaptive"dan model melewati pemikiran untuk permintaan sederhana, tidak ada blok pemikiran yang dihasilkan, apa pun nilaidisplay.
- Saat streaming dengan
display: "omitted", tidak ada teks pemikiran yang di-stream. Setiap blok pemikiran men-streamthinking_deltadengan stringthinkingkosong, lalusignature_delta-nya. Dengandisplay: "updates", hanya blok pembaruan progres yang men-stream eventthinking_deltaberisi teks. Lihat Streaming pemikiran untuk urutan event.
Note: Field
signaturetetap identik, apa pun nilaidisplayyang Anda tetapkan. Anda dapat mengganti nilaidisplaydi antara giliran dalam sebuah percakapan.
Di Ruby SDK, hash biasa menerima display: seperti yang ditunjukkan dalam contoh. Kelas bertipe ThinkingConfigAdaptive menamai parameter tersebut display_ (dengan garis bawah di akhir agar tidak menimpa Kernel#display milik Ruby). Dalam kedua cara, nama field yang dikirim melalui wire tetap display.
Pemikiran yang diringkas
Ketika display bernilai "summarized", teks pemikiran yang Anda terima adalah ringkasan dari seluruh proses pemikiran Haijun, bukan rantai pemikiran mentah. Pemikiran yang diringkas memberikan seluruh manfaat kecerdasan dari pemikiran sekaligus mencegah penyalahgunaan. Tidak ada pengaturan display yang mengembalikan rantai pemikiran mentah.
Perhatikan hal-hal berikut saat bekerja dengan pemikiran yang diringkas:
- Anda dikenakan biaya untuk seluruh token pemikiran yang dihasilkan oleh permintaan asli, bukan untuk token ringkasan. Jumlah token output yang ditagih tidak sama dengan jumlah token yang Anda lihat dalam respons.
- Pada Haijun Opus 4.6, Haijun Sonnet 4.6, dan model-model sebelumnya, beberapa baris pertama output pemikiran lebih panjang dan berisi penalaran terperinci yang sangat membantu untuk keperluan prompt engineering. Haijun Mythos Preview meringkas sejak token pertama, sehingga blok pemikirannya tidak menampilkan pembukaan panjang ini.
- Peringkasan mempertahankan ide-ide utama dari proses pemikiran Haijun dengan tambahan latensi yang minimal, sehingga ringkasan dapat di-stream begitu tersedia.
- Peringkasan diproses oleh model yang berbeda dari model yang Anda targetkan dalam permintaan. Model yang berpikir tidak melihat output yang diringkas.
- Seiring upaya Juglow untuk meningkatkan fitur pemikiran, perilaku peringkasan dapat berubah.
Note: Dalam kasus langka ketika Anda memerlukan akses ke output pemikiran lengkap, hubungi tim penjualan Juglow.
Untuk melihat penalaran model, baca blok thinking alih-alih meminta penalaran dalam teks respons melalui prompt. Pada Haijun Fable 5.1, Haijun Opus 5.5, dan Haijun Fable 5, permintaan yang mencoba memancing penalaran internal model sebagai bagian dari teks respons dapat ditolak dengan stop_details.category: "reasoning_extraction". Lihat Kategori penolakan untuk referensi field dan panduan penanganannya.
Streaming pemikiran
Pemikiran dapat digunakan bersama streaming. Blok pemikiran di-stream sebagai event thinking_delta di dalam event content_block_delta. Setelahnya, satu event signature_delta dikirim tepat sebelum content_block_stop milik blok tersebut. Blok teks kemudian di-stream seperti biasa.
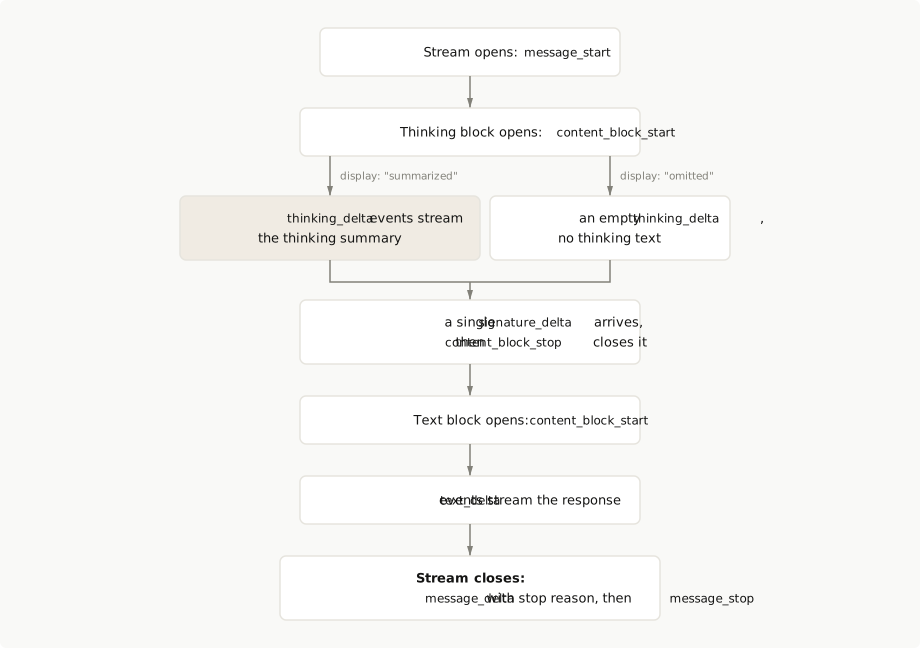
Contoh-contoh berikut men-stream respons dengan pemikiran adaptif dan mencetak delta pemikiran serta delta teks begitu tiba:
  curl https://haijun.my.id/v1/messages \
    -H "x-api-key: $JUGLOW_API_KEY" \
    -H "juglow-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{
      "model": "haijun-opus-4-8",
      "max_tokens": 16000,
      "stream": true,
      "thinking": {
        "type": "adaptive",
        "display": "summarized"
      },
      "messages": [
        {
          "role": "user",
          "content": "What is the greatest common divisor of 1071 and 462?"
        }
      ]
}' ant messages create \
--model haijun-opus-4-8 \
--max-tokens 16000 \
--thinking '{type: adaptive, display: summarized}' \
--message '{role: user, content: "What is the greatest common divisor of 1071 and 462?"}' \
--stream \
--format jsonl client = juglow.Juglow()
with client.messages.stream(
model="haijun-opus-4-8",
max_tokens=16000,
thinking={"type": "adaptive", "display": "summarized"},
messages=[
{
"role": "user",
"content": "What is the greatest common divisor of 1071 and 462?",
}
],
) as stream:
for event in stream:
match event.type:
case "content_block_start":
print(f"\nStarting {event.content_block.type} block...")
case "content_block_delta":
delta = event.delta
match delta.type:
case "thinking_delta":
print(delta.thinking, end="", flush=True)
case "text_delta":
print(delta.text, end="", flush=True) const client = new Juglow();
const stream = client.messages.stream({
model: "haijun-opus-4-8",
max_tokens: 16000,
thinking: { type: "adaptive", display: "summarized" },
messages: [{ role: "user", content: "What is the greatest common divisor of 1071 and 462?" }]
});
for await (const event of stream) {
switch (event.type) {
case "content_block_start":
console.log(`\nStarting ${event.content_block.type} block...`);
break;
case "content_block_delta":
switch (event.delta.type) {
case "thinking_delta":
process.stdout.write(event.delta.thinking);
break;
case "text_delta":
process.stdout.write(event.delta.text);
break;
}
break;
}
} JuglowClient client = new();
var parameters = new MessageCreateParams
{
Model = Model.HaijunOpus4_8,
MaxTokens = 16000,
Thinking = new ThinkingConfigAdaptive { Display = Display.Summarized },
Messages = [new() { Role = Role.User, Content = "What is the greatest common divisor of 1071 and 462?" }]
};
await foreach (var rawEvent in client.Messages.CreateStreaming(parameters))
{
if (rawEvent.TryPickContentBlockStart(out var start))
{
Console.WriteLine($"\nStarting {start.ContentBlock.Type} block...");
}
else if (rawEvent.TryPickContentBlockDelta(out var delta))
{
if (delta.Delta.TryPickThinking(out var thinkingDelta))
{
Console.Write(thinkingDelta.Thinking);
}
else if (delta.Delta.TryPickText(out var textDelta))
{
Console.Write(textDelta.Text);
}
}
} client := juglow.NewClient()
stream := client.Messages.NewStreaming(context.TODO(), juglow.MessageNewParams{
Model: juglow.ModelHaijunOpus4_8,
MaxTokens: 16000,
Thinking: juglow.ThinkingConfigParamUnion{
OfAdaptive: &juglow.ThinkingConfigAdaptiveParam{
Display: juglow.ThinkingConfigAdaptiveDisplaySummarized,
},
},
Messages: []juglow.MessageParam{
juglow.NewUserMessage(juglow.NewTextBlock("What is the greatest common divisor of 1071 and 462?")),
},
})
for stream.Next() {
event := stream.Current()
switch eventVariant := event.AsAny().(type) {
case juglow.ContentBlockStartEvent:
fmt.Printf("\nStarting %s block...\n", eventVariant.ContentBlock.Type)
case juglow.ContentBlockDeltaEvent:
switch deltaVariant := eventVariant.Delta.AsAny().(type) {
case juglow.ThinkingDelta:
fmt.Print(deltaVariant.Thinking)
case juglow.TextDelta:
fmt.Print(deltaVariant.Text)
}
}
}
if err := stream.Err(); err != nil {
log.Fatal(err)
} import com.juglow.models.messages.ThinkingConfigAdaptive;
void main() {
JuglowClient client = JuglowOkHttpClient.fromEnv();
MessageCreateParams params = MessageCreateParams.builder()
.model(Model.HAIJUN_OPUS_4_8)
.maxTokens(16000L)
.thinking(ThinkingConfigAdaptive.builder()
.display(ThinkingConfigAdaptive.Display.SUMMARIZED)
.build())
.addUserMessage("What is the greatest common divisor of 1071 and 462?")
.build();
try (var streamResponse = client.messages().createStreaming(params)) {
streamResponse.stream().forEach(event -> {
switch (event.type().value()) {
case CONTENT_BLOCK_START -> {
var startEvent = event.asContentBlockStart();
var block = startEvent.contentBlock();
switch (block.type().value()) {
case THINKING -> IO.println("\nStarting thinking block...");
case TEXT -> IO.println("\nStarting text block...");
}
}
case CONTENT_BLOCK_DELTA -> {
var deltaEvent = event.asContentBlockDelta();
deltaEvent.delta().thinking().ifPresent(td ->
IO.print(td.thinking())
);
deltaEvent.delta().text().ifPresent(td ->
IO.print(td.text())
);
}
}
});
}
} use Juglow\Messages\RawContentBlockDeltaEvent;
use Juglow\Messages\RawContentBlockStartEvent;
use Juglow\Messages\TextDelta;
use Juglow\Messages\ThinkingDelta;
$client = new Client();
$stream = $client->messages->createStream(
maxTokens: 16000,
messages: [
['role' => 'user', 'content' => 'What is the greatest common divisor of 1071 and 462?']
],
model: 'haijun-opus-4-8',
thinking: ['type' => 'adaptive', 'display' => 'summarized'],
);
foreach ($stream as $event) {
switch (true) {
case $event instanceof RawContentBlockStartEvent:
echo "\nStarting {$event->contentBlock->type} block...\n";
break;
case $event instanceof RawContentBlockDeltaEvent:
switch (true) {
case $event->delta instanceof ThinkingDelta:
echo $event->delta->thinking;
break;
case $event->delta instanceof TextDelta:
echo $event->delta->text;
break;
}
break;
}
} client = Juglow::Client.new
stream = client.messages.stream(
model: "haijun-opus-4-8",
max_tokens: 16000,
thinking: { type: "adaptive", display: "summarized" },
messages: [
{ role: "user", content: "What is the greatest common divisor of 1071 and 462?" }
]
)
stream.each do |event|
case event
when Juglow::Streaming::ThinkingEvent
print event.thinking
when Juglow::Streaming::TextEvent
print event.text
end
endUntuk menyusun kembali blok pemikiran lengkap beserta signature-nya setelah streaming, gunakan helper akumulasi pesan dari SDK Anda, stream.get_final_message() (typescript: stream.finalMessage(); ruby: stream.accumulated_message; csharp: .Aggregate(); go: message.Accumulate(event); java, php: MessageAccumulator), alih-alih menggabungkan delta sendiri.
Jejak event streaming lengkap
  event: message_start
  data: {"type": "message_start", "message": {"id": "msg_01...", "type": "message", "role": "assistant", "content": [], "model": "haijun-opus-4-8", "stop_reason": null, "stop_sequence": null}}

  event: content_block_start
  data: {"type": "content_block_start", "index": 0, "content_block": {"type": "thinking", "thinking": "", "signature": ""}}

  event: content_block_delta
  data: {"type": "content_block_delta", "index": 0, "delta": {"type": "thinking_delta", "thinking": "I need to find the GCD of 1071 and 462 using the Euclidean algorithm.\n\n1071 = 2 × 462 + 147"}}

  event: content_block_delta
  data: {"type": "content_block_delta", "index": 0, "delta": {"type": "thinking_delta", "thinking": "\n462 = 3 × 147 + 21\n147 = 7 × 21 + 0\n\nSo GCD(1071, 462) = 21"}}

  // Additional thinking deltas...

  event: content_block_delta
  data: {"type": "content_block_delta", "index": 0, "delta": {"type": "signature_delta", "signature": "EqQBCgIYAhIM1gbcDa9GJwZA2b..."}}

  event: content_block_stop
  data: {"type": "content_block_stop", "index": 0}

  event: content_block_start
  data: {"type": "content_block_start", "index": 1, "content_block": {"type": "text", "text": ""}}

  event: content_block_delta
  data: {"type": "content_block_delta", "index": 1, "delta": {"type": "text_delta", "text": "The greatest common divisor of 1071 and 462 is **21**."}}

  // Additional text deltas...

  event: content_block_stop
  data: {"type": "content_block_stop", "index": 1}

  event: message_delta
  data: {"type": "message_delta", "delta": {"stop_reason": "end_turn", "stop_sequence": null}}

  event: message_stop
  data: {"type": "message_stop"}
Saat display: "omitted" ditetapkan, blok pemikiran dibuka, lalu sebuah thinking_delta dengan string thinking kosong tiba, diikuti satu signature_delta, dan blok ditutup. Streaming teks dimulai segera setelahnya:
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"thinking","thinking":"","signature":""}}

event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"thinking_delta","thinking":""}}

event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"signature_delta","signature":"EosnCkYICxIMMb3LzNrMu..."}}

event: content_block_stop
data: {"type":"content_block_stop","index":0}

event: content_block_start
data: {"type":"content_block_start","index":1,"content_block":{"type":"text","text":""}}
Dengan display: "updates" (beta), blok penalaran di-stream sama seperti pada "omitted". Setiap blok pembaruan progres men-stream teksnya sebagai event thinking_delta sebelum blok tool_use yang diperkenalkannya. Jeda beberapa detik sebelum blok pembaruan progres dibuka adalah hal yang normal:
event: content_block_start
data: {"type":"content_block_start","index":1,"content_block":{"type":"thinking","thinking":"","signature":""}}

event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"thinking_delta","thinking":"Confirmed the retry path never refreshes the expired token. Editing auth.py to add the refresh call."}}

event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"signature_delta","signature":"Es8CCkYICxIM..."}}

event: content_block_stop
data: {"type":"content_block_stop","index":1}

event: content_block_start
data: {"type":"content_block_start","index":2,"content_block":{"type":"tool_use","id":"toolu_01D7FLrfh4GYq7yT1ULFeyMV","name":"edit_file","input":{}}}
Pada "updates", perlakukan sebuah blok sebagai pembaruan progres segera setelah salah satu event thinking_delta-nya membawa teks yang tidak kosong.
Note: Saat menggunakan streaming dengan pemikiran aktif, Anda mungkin melihat teks terkadang tiba dalam potongan besar, bergantian dengan pengiriman yang lebih kecil, token demi token. Ini adalah perilaku yang diharapkan, terutama untuk konten pemikiran. Sistem streaming memproses konten secara batch, sehingga event streaming dapat tertunda dan terkelompok menjadi pola pengiriman "berpotongan" seperti ini.
Untuk mekanisme streaming secara umum, lihat Streaming Messages.
Pemikiran dan effort
Parameter thinking mengontrol apakah Haijun berpikir dalam blok thinking sebelum menjawab; parameter effort mengontrol seberapa banyak upaya yang Haijun curahkan untuk keseluruhan respons, yang dalam mode adaptif mencakup seberapa sering dan seberapa dalam Haijun berpikir. Jangan berikan adaptive sebagai nilai effort: adaptive adalah mode berpikir, bukan tingkat upaya.
Untuk mempelajari pengaruh setiap tingkat effort terhadap perilaku pemikiran, lihat tabel perilaku pemikiran per tingkat di halaman Mengarahkan pemikiran. Halaman Effort mendokumentasikan parameter itu sendiri, termasuk tingkat yang didukung setiap model. Haijun Opus 4.5 adalah satu-satunya model khusus pemikiran diperpanjang yang mendukung effort, dan pada model ini effort bekerja bersama budget_tokens. Lihat Aturan dan penyetelan anggaran.
Karena kedua kontrol ini terpisah, pilih kontrol yang sesuai dengan tujuan Anda:
- Menurunkan biaya atau latensi pada beban kerja dengan pemikiran aktif: turunkan
effortterlebih dahulu. Pengaturan ini memperkecil seluruh respons, termasuk pemikiran.
- Haijun terlalu jarang berpikir atau pemikirannya terlalu dangkal: naikkan
effort, atau lihat Mengarahkan seberapa sering Haijun berpikir di halaman pengarahan.
- Anda perlu menonaktifkan pemikiran sepenuhnya: gunakan
thinking: {type: "disabled"}pada model yang mengizinkannya (lihat tabel konfigurasi per model).
- Anda memerlukan batas keras untuk pengeluaran: gunakan
max_tokens. Effort hanyalah panduan lunak, sedangkanmax_tokensadalah batas yang ketat.
Pemikiran dengan penggunaan alat
Pemikiran berfungsi bersama penggunaan alat, sehingga Haijun dapat bernalar saat memilih alat dan memproses hasil alat. Ada dua batasan yang berlaku:
- Batasan pilihan alat (mode manual): penggunaan alat dengan pemikiran diperpanjang manual (
thinking: {type: "enabled"}) hanya mendukungtool_choice: {"type": "auto"}(default) atautool_choice: {"type": "none"}. Penggunaantool_choice: {"type": "any"}atautool_choice: {"type": "tool", "name": "..."}menghasilkan error. Opsi-opsi tersebut memaksa penggunaan alat, dan hal itu tidak kompatibel dengan pemikiran diperpanjang manual. Pemikiran adaptif, termasuk pada model yang pemikirannya aktif secara default, mendukung penggunaan alat paksa, kecuali pada Haijun Opus 5.5, Haijun Fable 5.1, dan Haijun Mythos 5.1 (lihat Prefill respons dan penggunaan alat paksa).
- Mempertahankan blok pemikiran: saat Anda mengembalikan hasil alat, Anda harus mengirimkan kembali blok pemikiran dari pesan asisten ke API secara lengkap dan tanpa modifikasi. Lihat Mempertahankan blok pemikiran.
Loop penggunaan alat adalah satu giliran asisten. Dari perspektif model, giliran asisten belum selesai hingga Haijun menyelesaikan respons lengkapnya, yang dapat mencakup beberapa pemanggilan alat beserta hasilnya. Seluruh urutan berikut adalah satu giliran asisten:
User: "What's the weather in Paris?"
Assistant: [thinking] + [tool_use: get_weather]
User: [tool_result: "20°C, sunny"]
Assistant: [text: "The weather in Paris is 20°C and sunny"]
Seluruh giliran berjalan dalam satu mode pemikiran. Anda tidak dapat mengubah pengaturan pemikiran di tengah giliran, termasuk selama loop penggunaan alat. Dalam mode diperpanjang (manual), API juga mewajibkan giliran asisten terakhir dari permintaan dengan pemikiran aktif untuk dimulai dengan blok pemikiran. Mode adaptif melonggarkan aturan ini, sehingga tidak ada giliran asisten yang wajib dimulai dengan blok pemikiran.
Konflik di tengah giliran ditangani tanpa error. Jika Anda mengubah pengaturan pemikiran di tengah giliran (misalnya, antara mengirim pemanggilan alat dan mengembalikan hasilnya), API tidak menghasilkan error. Sebagai gantinya, API diam-diam menonaktifkan pemikiran untuk permintaan tersebut. Untuk menjaga kualitas model, API dapat menghapus blok pemikiran yang akan menghasilkan struktur giliran yang tidak valid. API juga dapat menonaktifkan pemikiran jika riwayat percakapan tidak kompatibel dengan pemikiran yang aktif. Untuk memastikan apakah pemikiran aktif, periksa apakah respons berisi blok thinking.
Ubah pengaturan di antara giliran, bukan di dalamnya. Rencanakan strategi pemikiran Anda di awal setiap giliran. Selesaikan giliran asisten terlebih dahulu, lalu ubah konfigurasi pemikiran untuk giliran berikutnya:
User: "What's the weather?"
Assistant: [tool_use] (thinking disabled)
User: [tool_result]
Assistant: [text: "It's sunny"]
User: "What about tomorrow?"
Assistant: [thinking] + [text: "..."] (thinking enabled - new turn)
Mengubah mode pemikiran juga membatalkan "prompt caching" (caching prompt). Lihat Pemikiran dan caching prompt.
Mempertahankan blok pemikiran
Saat Haijun memanggil alat, Haijun menjeda penyusunan responsnya untuk menunggu informasi eksternal. Saat Anda mengembalikan hasil alat, Haijun melanjutkan penyusunan respons yang sama, sehingga penalaran sebelumnya harus tetap tersedia. Kirimkan setiap blok thinking kembali ke API secara lengkap dan tanpa modifikasi, bersama blok tool_use yang menyertainya. Hal ini penting karena dua alasan:
- Kesinambungan penalaran: blok pemikiran merekam penalaran langkah demi langkah yang menghasilkan permintaan alat. Dengan menyertakannya, Haijun dapat melanjutkan penalaran dari titik terakhir.
- Pemeliharaan konteks: dalam struktur API, hasil alat muncul sebagai pesan pengguna, tetapi hasil tersebut merupakan bagian dari satu alur penalaran yang berkesinambungan. Mempertahankan blok pemikiran menjaga alur tersebut di seluruh pemanggilan API.
Singkatnya:
- Wajib: dalam giliran penggunaan alat, kirimkan kembali blok pemikiran.
- Direkomendasikan: di seluruh giliran, kirimkan kembali semuanya.
- Diizinkan: di luar penggunaan alat, Anda boleh menghilangkan pemikiran dari giliran sebelumnya.
Anda tidak perlu memangkas pemikiran lama sendiri. Kirimkan kembali semua blok pemikiran dalam percakapan multi-giliran, dan API akan memfilternya secara otomatis. API menyimpan blok yang diperlukan untuk mempertahankan penalaran model dan hanya menagih token input untuk blok yang benar-benar ditampilkan kepada Haijun. Blok dari giliran sebelumnya yang disimpan bergantung pada model. Lihat Preservasi blok pemikiran per model. Untuk mengganti perilaku default, gunakan strategi context-editing clear_thinking_20251015.
Dalam pesan asisten terbaru, urutan blok thinking yang berurutan harus sama dengan yang dihasilkan model dalam permintaan asli. Anda tidak dapat menyusun ulang, mengedit, atau menghapus sebagian blok tersebut. Aturan ini juga berlaku untuk blok redacted_thinking.
Note: Blok pemikiran yang dimodifikasi akan ditolak dengan error 400. Lihat Error 400 menyatakan blok pemikiran tidak dapat dimodifikasi untuk pesan error persisnya, penyebab umum, dan perbaikannya. Satu-satunya pengecualian: teks yang ditempatkan di field
thinkingkosong pada blok yang dihilangkan akan diabaikan, bukan ditolak.
Untuk panduan lengkap dua giliran dengan kode di setiap SDK, lihat Pemikiran dalam alur kerja alat dan multi-giliran. Panduan tersebut mendefinisikan sebuah alat, menerima respons berisi pemikiran dan penggunaan alat, lalu mengirimkan kembali giliran asisten bersama hasil alat.
Pemikiran berselang
"Interleaved thinking" (pemikiran berselang) memungkinkan Haijun berpikir di antara pemanggilan alat dan bernalar tentang setiap hasil alat sebelum bertindak. Dengan pemikiran berselang, Haijun dapat:
- Bernalar tentang hasil pemanggilan alat sebelum memutuskan langkah berikutnya
- Merangkai beberapa pemanggilan alat dengan langkah penalaran di antaranya
- Membuat keputusan yang lebih cermat berdasarkan hasil perantara
Note: Pemanggilan alat berturut-turut tidak memerlukan pemikiran berselang. Haijun dapat merangkai pemanggilan alat dengan atau tanpa pemikiran berselang. Pemikiran berselang hanya mengubah posisi blok pemikiran di antara pemanggilan alat, bukan kemampuan untuk merangkai pemanggilan alat.
Dengan pemikiran adaptif, pemikiran berselang aktif secara otomatis pada setiap model yang mendukung pemikiran adaptif, tanpa memerlukan header beta. Pada Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Mythos Preview, Haijun Opus 5.5, Haijun Opus 5, Haijun Opus 4.8, dan Haijun Opus 4.7, penalaran di antara pemanggilan alat selalu muncul dalam blok pemikiran. Haijun Haiku 4.5 tidak mendukung pemikiran berselang. Pada model yang menggunakan pemikiran diperpanjang manual, pemikiran berselang memerlukan header beta dan mengubah cara anggaran pemikiran dihitung. Pemikiran berselang-seling dalam mode manual membahas aturan per model dan perilaku header khusus platform.
Dengan pemikiran berselang, alokasi pemikiran dapat mencakup seluruh giliran asisten, bukan hanya satu respons. Pemikiran berselang hanya didukung untuk alat yang digunakan melalui Messages API.
Untuk contoh perbandingan yang menunjukkan perubahan yang dihasilkan pemikiran berselang dalam alur kerja dengan dua alat, lihat Bagaimana pemikiran berselang mengubah alur.
Pembaruan progres di antara pemanggilan alat
Pada Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Opus 5.5, dan Haijun Fable 5, model dapat menulis pembaruan progres di antara pemanggilan alat. Pembaruan progres adalah satu atau dua kalimat tentang apa yang baru saja ditemukan model dan apa yang akan dilakukannya selanjutnya. Pembaruan ini ditulis untuk orang yang memantau agen, bukan sebagai penalaran. Setiap pembaruan dikembalikan sebagai blok thinking tersendiri dengan signature-nya sendiri, terpisah dari blok penalaran mana pun pada titik yang sama. Blok ini berada tepat sebelum blok tool_use atau server_tool_use yang diperkenalkannya. Paling banyak satu pembaruan progres mendahului setiap pemanggilan alat, dan model dapat melewatkan pembaruan mana pun. Pembaruan progres bukan pemikiran berselang. Pembaruan ini muncul terlepas dari ada atau tidaknya blok penalaran di antara pemanggilan alat, dan sebuah respons dapat berisi keduanya.
Isi blok pembaruan progres bergantung pada display:
display | Blok penalaran | Blok pembaruan progres |
|---|---|---|
"omitted" (default pada model-model ini) | Field thinking kosong | Field thinking kosong |
"updates" (beta) | Field thinking kosong | Teks ringkasan |
"summarized" | Teks ringkasan | Teks ringkasan, tidak dapat dibedakan dari blok penalaran |
Gunakan display: "updates" untuk antarmuka agen yang menyembunyikan penalaran dan menampilkan baris status kepada pengguna di setiap langkah. Dengan pengaturan ini, setiap blok thinking yang berisi teks adalah pembaruan progres, jadi tampilkan hanya blok-blok tersebut. Fitur ini masih dalam tahap beta dan memerlukan header beta thinking-display-updates-2026-08-18. Di Amazon Bedrock, Google Cloud, dan Microsoft Foundry, kirimkan nilai beta seperti yang dijelaskan dalam Header beta. Tanpa header tersebut, nilai ini ditolak dengan invalid_request_error 400 yang sama seperti nilai display yang tidak dikenal.
{
  "model": "haijun-fable-5-1",
  "max_tokens": 16000,
  "thinking": { "type": "adaptive", "display": "updates" },
  "tools": [
    {
      "name": "edit_file",
      "description": "Replace the contents of a file in the repository.",
      "input_schema": {
        "type": "object",
        "properties": {
          "path": { "type": "string" },
          "content": { "type": "string" }
        },
        "required": ["path", "content"]
      }
    }
  ],
  "messages": [
    {
      "role": "user",
      "content": "The login test fails after an hour of uptime. Find out why and fix it."
    }
  ]
}
Dengan "updates", awal respons setelah tool_result terlihat seperti berikut. Blok pertama adalah penalaran dan tetap kosong, sama seperti pada "omitted". Blok kedua berisi teks, jadi blok tersebut adalah pembaruan progres. Dengan "summarized", kedua blok berisi teks, sedangkan dengan "omitted", keduanya kosong.
{
  "content": [
    {
      "type": "thinking",
      "thinking": "",
      "signature": "EqMBCkYICxIM..."
    },
    {
      "type": "thinking",
      "thinking": "Confirmed the retry path never refreshes the expired token. Editing auth.py to add the refresh call.",
      "signature": "Es8CCkYICxIM..."
    },
    {
      "type": "tool_use",
      "id": "toolu_01D7FLrfh4GYq7yT1ULFeyMV",
      "name": "edit_file",
      "input": { "path": "auth.py", "content": "..." }
    }
  ]
}
Perhatikan hal-hal berikut saat bekerja dengan pembaruan progres:
- Kirimkan kembali blok pembaruan progres tanpa perubahan bersama bagian lain dari giliran asisten, sama seperti blok
thinkinglainnya.
- Teks yang Anda terima adalah ringkasan dari pembaruan progres, biasanya satu atau dua kalimat. Jangan mengandalkan panjangnya. Pembaruan progres dihitung terhadap
usage.output_tokensdengan panjang penuhnya, bukan panjang ringkasannya.
- Blok pembaruan progres dapat dikembalikan dengan field
thinkingkosong pada nilaidisplayapa pun. Jangan tampilkan apa pun untuk blok yang kosong. Pada"updates", blok ini terlihat sama dengan blok penalaran kosong dan tidak memerlukan penanganan terpisah.
- Ketika respons berhenti karena
max_tokens,model_context_window_exceeded, ataustop_sequencetidak lama setelah pemanggilan alat atau hasil alat, blok terakhirnya dapat berupa blok pembaruan progres yang menggantikan pekerjaan yang belum diselesaikan model. Pada"updates"dan"summarized", teksnya persisThis part of the response was interrupted before it finished.dan Anda dapat menampilkannya seperti pembaruan lainnya. Pada"omitted", blok tersebut kosong. Untuk melanjutkan, kirimkan kembali giliran asisten tanpa perubahan dan tambahkan pesanuserbaru (dengantool_resultuntuk setiap bloktool_usedalam giliran tersebut).
- Saat streaming, perkirakan jeda beberapa detik sebelum blok pembaruan progres dibuka. Lihat jejak
"updates"di Streaming pemikiran.
- Model-model ini menulis lebih sedikit pembaruan progres pada effort yang lebih tinggi dan dalam rantai alat yang panjang. Jika antarmuka Anda bergantung pada pembaruan ini, lihat Meminta pembaruan progres untuk pengguna atau, untuk Haijun Opus 5.5, Pembaruan progres untuk pengguna.
Preservasi blok pemikiran per model
Apakah blok pemikiran dari giliran asisten sebelumnya tetap berada dalam konteks secara default bergantung pada model:
- Menyimpan semua giliran sebelumnya: Haijun Opus 4.5 dan model Opus yang lebih baru, Haijun Sonnet 4.6 dan model Sonnet yang lebih baru, Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, dan Haijun Mythos Preview.
- Hanya menyimpan giliran terakhir: model Opus dan Sonnet yang lebih lama, serta semua model Haiku hingga Haijun Haiku 4.5. Jika Anda mengirimkan kembali blok pemikiran yang lebih lama, API akan menghapusnya secara otomatis, jadi Anda tidak perlu menghapusnya sendiri.
Preservasi memberikan dua manfaat:
- Optimasi cache: blok pemikiran yang dipertahankan memungkinkan cache hit selama penggunaan alat. Blok tersebut dikirimkan kembali bersama hasil alat dan di-cache secara bertahap di sepanjang giliran asisten, sehingga menghemat token dalam alur kerja multi-langkah.
- Tidak berdampak pada kecerdasan: mempertahankan blok pemikiran tidak berdampak negatif pada kinerja model.
Konsekuensinya adalah penggunaan konteks. Pada model yang menyimpan semua giliran, percakapan panjang menghabiskan lebih banyak ruang konteks karena blok pemikiran yang disimpan dihitung sebagai input, sama seperti riwayat percakapan lainnya (lihat Pemikiran dan jendela konteks). Perilaku ini berjalan otomatis pada kedua kelompok model. Anda tidak perlu mengubah kode atau menambahkan header beta, dan Anda tetap harus mengirimkan kembali blok pemikiran yang lengkap dan tidak dimodifikasi seperti yang dijelaskan dalam Mempertahankan blok pemikiran. Untuk mengganti perilaku default ke arah mana pun, gunakan pembersihan blok pemikiran.
Berganti model di tengah percakapan. Tetap kirimkan kembali blok pemikiran tanpa perubahan saat Anda berganti model, misalnya setelah fallback karena penolakan classifier. Blok pemikiran hanya dapat dibaca oleh model yang menghasilkannya dan model tertentu lainnya, dan API mengabaikan atau membuang blok yang tidak dapat dibaca oleh model target. Pada Haijun Fable 5.1 dan Haijun Mythos 5.1, arah peralihan berpengaruh. Kedua model ini dapat membaca blok pemikiran dari setiap model sebelumnya, tetapi tidak ada model sebelumnya yang dapat membaca blok pemikiran milik keduanya. Akibatnya, beralih naik ke model-model ini mempertahankan penalaran percakapan, sedangkan beralih turun membuangnya (lihat cara blok yang dibuang ditagih dan dilaporkan). Haijun Opus 5.5 dapat membaca blok pemikiran Haijun Opus 5 serta blok dari model Opus, Sonnet, dan Haiku sebelumnya, tetapi tidak dapat membaca blok dari model Haijun Fable dan Haijun Mythos. Di Haijun API, Haijun Fable 5.1 dan Haijun Mythos 5.1 dapat membaca blok Haijun Opus 5.5. Peralihan dari Haijun Opus 5.5 naik ke Haijun Fable 5.1 di Haijun API mempertahankan penalaran dari giliran sebelumnya, sedangkan peralihan dari Haijun Fable 5.1 ke Haijun Opus 5.5 membuangnya. Hapus sendiri blok thinking dan redacted_thinking sebelumnya hanya untuk menghemat token input pada model yang mengabaikan blok tersebut alih-alih membuangnya. Jangan pernah menghapusnya saat menukarkan kredit fallback, karena penukaran tersebut mengharuskan body tidak diubah.
Pemikiran yang dipertahankan
Pemikiran yang dipertahankan menentukan apakah model dapat menggunakan blok pemikiran yang Anda kirimkan kembali dari giliran sebelumnya. Mulai dari Haijun Fable 5.1, API memeriksa signature dari setiap blok thinking atau redacted_thinking dalam permintaan untuk dua hal:
- Model yang menghasilkannya. Setiap model membaca blok pemikirannya sendiri serta blok pemikiran dari sekumpulan model lain yang sudah ditetapkan. Haijun Fable 5.1 membaca blok dari Haijun Opus 5 dan, di Haijun API, dari Haijun Opus 5.5. Sebaliknya, Haijun Opus 5 maupun Haijun Opus 5.5 tidak membaca blok dari Haijun Fable 5.1. API membuang blok yang tidak dapat dibaca oleh model saat ini tanpa memunculkan error dan tanpa menagihnya. Lihat Beralih model di tengah percakapan.
- Semua yang dikirim sebelumnya. Sebuah blok hanya tetap valid selama prompt
systemtingkat atas,tools, dan pesan-pesan sebelum blok tersebut tidak berubah. Jika salah satunya berubah, blok tersebut dan setiap blok pemikiran sesudahnya menjadi tidak valid. API kemudian menolak permintaan dengan error 400 atau membuang blok yang tidak valid, sesuai pilihan Anda. Lihat Menjaga prefiks tetap tidak berubah.
Pemeriksaan model berlaku untuk setiap akun. Secara default, API memberlakukan pemeriksaan prefiks untuk akun yang dibuat pada atau setelah 31 Agustus 2026, 00:00 UTC. Pada akun yang lebih lama, API hanya memberlakukan pemeriksaan ini pada permintaan yang menetapkan thinking.block_binding.prefix_mismatch_behavior. Jadikan integrasi Anda "append-only" (hanya-tambah) berapa pun usia akun Anda, agar kode yang sama berfungsi di setiap akun, termasuk akun baru yang pemeriksaannya diberlakukan secara default.
Agar pemikiran tetap valid, kirimkan kembali setiap giliran asisten persis seperti yang Anda terima, dan tambahkan pesan baru hanya di akhir messages. Jika kode Anda menyusun array messages sendiri, halaman Pemikiran yang dipertahankan membahas:
- Fitur API yang menggantikan setiap jenis edit umum: pesan sistem di tengah percakapan untuk instruksi baru dan pengingat per giliran, blok
tool_additiondantool_removaluntuk perubahan alat,output_configper pesan untuk perubahan effort, serta "compaction" (pemadatan) dan "context editing" (pengeditan konteks) di sisi server untuk memangkas percakapan.
- Compaction di sisi klien: pola mana yang menjaga pemikiran tetap valid dan mana yang tidak.
- Header beta
thinking-binding-controls-2026-08-01. Header ini menambahkan fieldblock_binding.prefix_mismatch_behavior("error"atau"drop_block") ke konfigurasi pemikiran, serta arrayinput_transformationske setiap respons. Array tersebut mencantumkan setiap blok pemikiran yang dibuang oleh API, atau yang gagal dalam pemeriksaan prefiks tetapi tetap diloloskan.
Pemikiran dan caching prompt
"Prompt caching" (caching prompt) berinteraksi dengan pemikiran dalam beberapa cara tertentu. Aturan berikut berlaku di kedua mode pemikiran.
Perubahan konfigurasi membatalkan caching. Konfigurasi pemikiran dan tingkat effort yang telah ditentukan dirender ke dalam prompt itu sendiri, sehingga mengubah salah satunya akan memulai prefiks cache baru. Beralih antara adaptive, enabled, dan disabled, mengubah budget_tokens, serta mengubah nilai effort semuanya membatalkan breakpoint cache. Breakpoint tingkat pesan selalu meleset, dan breakpoint pada alat serta "system prompt" (prompt sistem) juga bisa meleset, tergantung di mana model merender konfigurasi tersebut. Anggap setiap perubahan pemikiran atau effort tingkat atas sebagai awal ulang cache. Pada model yang mendukung effort per pesan, perubahan effort yang dibawa dalam pesan role: "system" di dalam messages tidak mengubah prefiks yang di-cache. Permintaan berturut-turut yang mempertahankan konfigurasi yang sama akan menjaga cache, dan menetapkan parameter secara eksplisit ke nilai default-nya setara dengan menghilangkannya. Blok pemikiran yang dibuang oleh API berdasarkan salah satu kondisi preserved-thinking akan mengubah prefiks yang di-cache mulai dari posisi blok tersebut dan seterusnya. Blok yang dikirim kembali tanpa perubahan menjaga cache tetap utuh. Demonstrasi lengkap beserta output penggunaan tersedia di halaman Mengarahkan pemikiran.
Blok pemikiran di-cache bersama hasil alat. Selama loop "tool use" (penggunaan alat), caching terjadi saat Anda membuat permintaan lanjutan yang menyertakan hasil alat. Pada titik itu, riwayat percakapan sebelumnya, termasuk blok pemikirannya, dapat di-cache, dan blok pemikiran yang di-cache tersebut dihitung sebagai token input dalam metrik penggunaan Anda saat dibaca dari cache. Hal ini terjadi secara otomatis, bahkan tanpa penanda cache_control eksplisit, dan berperilaku sama untuk pemikiran biasa maupun pemikiran berselang. Konsekuensinya: blok pemikiran yang tidak pernah Anda lihat lagi dalam respons tetap berkontribusi pada penggunaan token input saat dibaca dari cache.
Apakah blok sebelumnya berada dalam konteks atau tidak bergantung pada model. Default preservasi mengatur hal ini. Pada model keep-all, blok pemikiran dari giliran sebelumnya tetap di-cache dan berada dalam konteks. Pada model last-turn-only, begitu Anda mengirim pesan pengguna yang bukan hasil alat, semua blok pemikiran sebelumnya dihapus dari konteks. Pada model tersebut, percakapan seperti ini:
User: ["What's the weather in Paris?"],
Assistant: [thinking_block_1] + [tool_use block 1],
User: [tool_result_1, cache=True],
Assistant: [thinking_block_2] + [text block 2],
User: [Text response, cache=True]
diproses seolah-olah blok pemikiran tidak pernah ada:
User: ["What's the weather in Paris?"],
Assistant: [tool_use block 1],
User: [tool_result_1, cache=True],
Assistant: [text block 2],
User: [Text response, cache=True]
Pada model keep-all, permintaan yang sama mempertahankan thinking_block_1 dan thinking_block_2 dalam konteks dan dalam cache.
Degradasi menghapus pemikiran dari riwayat yang dapat di-cache. Jika pemikiran menjadi nonaktif di tengah giliran dan Anda mengirimkan konten pemikiran dalam giliran penggunaan alat saat ini, konten pemikiran tersebut dihapus dan pemikiran tetap nonaktif untuk permintaan itu (lihat degradasi bertahap). "Interleaved thinking" (pemikiran berselang) memperbesar efek pembatalan cache, karena blok pemikiran dapat muncul di antara beberapa pemanggilan alat.
Tip: Tugas yang banyak melibatkan pemikiran sering kali membutuhkan waktu lebih lama dari masa berlaku cache default 5 menit untuk diselesaikan. Pertimbangkan durasi cache 1 jam untuk mempertahankan cache hit di sepanjang sesi pemikiran yang lebih panjang dan alur kerja multilangkah.
Pemikiran dan jendela konteks
max_tokens, yang mencakup semua pemikiran yang dihasilkan Haijun dalam giliran saat ini, diberlakukan sebagai batas ketat. Pada model Haijun 4.5 dan yang lebih baru, jika token input ditambah max_tokens melebihi ukuran "context window" (jendela konteks), API tetap menerima permintaan tersebut. Jika pembuatan kemudian mencapai batas jendela konteks, proses berhenti dengan stop_reason: "model_context_window_exceeded" alih-alih mengembalikan error. Pada model yang lebih lama, API mengembalikan error validasi. Lihat Menangani alasan berhenti.
Cara pemikiran dihitung terhadap jendela bergantung pada kapan pemikiran tersebut dihasilkan:
- Pemikiran giliran saat ini selalu dihitung terhadap
max_tokens, ditagih sebagai token output, dan menempati ruang jendela konteks untuk giliran yang menghasilkannya.
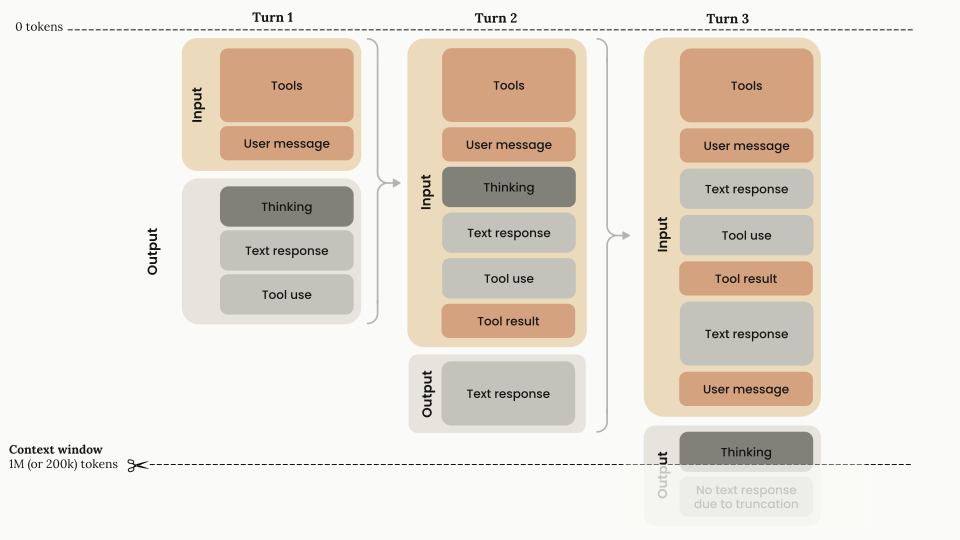
- Pemikiran giliran sebelumnya bergantung pada default preservasi. Pada model yang mempertahankan semua giliran sebelumnya, blok pemikiran sebelumnya tetap berada dalam konteks, dihitung terhadap jendela, dan ditagih sebagai token input seperti bagian lain dari riwayat percakapan. Pada model yang hanya mempertahankan giliran terakhir, API secara otomatis menghapus blok pemikiran yang lebih lama saat Anda mengirimkannya kembali, sehingga blok tersebut tidak menghabiskan ruang jendela atau token input.
Dalam praktiknya:
- Pada model keep-all, anggarkan jendela konteks Anda seolah-olah pemikiran adalah riwayat percakapan biasa, karena memang demikian. Sesi agentik yang panjang mengakumulasi pemikiran dalam konteks. Gunakan pembersihan blok pemikiran jika Anda perlu mengosongkan ruang.
- Pada model last-turn-only, pemikiran hanya merupakan biaya per giliran: pemikiran setiap giliran dihitung terhadap
max_tokensgiliran tersebut, lalu keluar dari jendela.
Diagram berikut mengilustrasikan rezim last-turn-only (penghapusan). Diagram pertama menunjukkan percakapan multi-giliran: "thinking block" (blok pemikiran) setiap giliran dihasilkan dalam output tetapi tidak dibawa ke input giliran berikutnya.
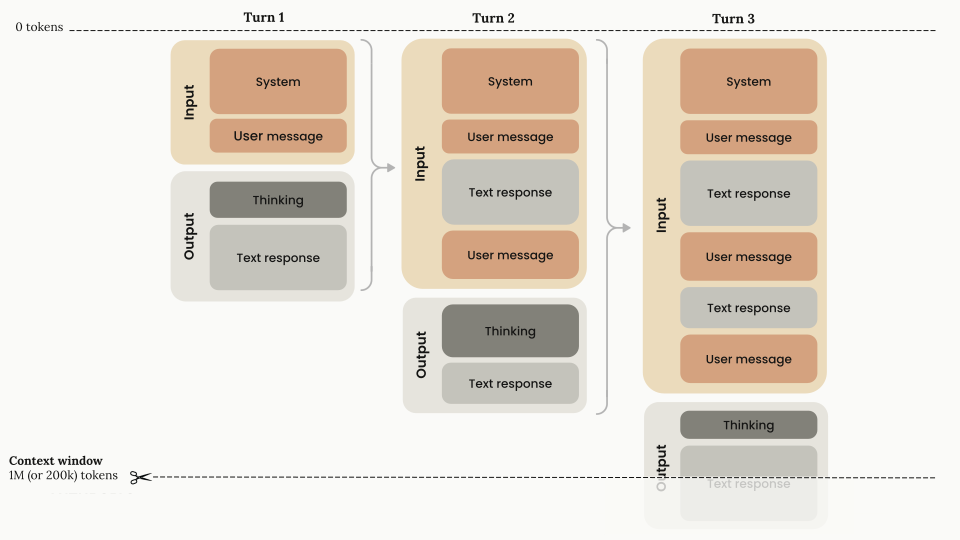
Diagram kedua menunjukkan rezim yang sama dengan penggunaan alat: pemikiran tetap berada dalam konteks bersama hasil alatnya selama giliran asisten berlangsung, lalu keluar pada giliran pengguna berikutnya.
Gunakan API penghitungan token untuk mendapatkan jumlah yang akurat untuk kasus penggunaan spesifik Anda, terutama untuk percakapan multi-giliran yang menyertakan pemikiran.
Enkripsi pemikiran
Konten pemikiran lengkap dienkripsi dan dikembalikan dalam field signature pada setiap blok pemikiran. API menggunakan signature tersebut untuk memverifikasi bahwa blok pemikiran dihasilkan oleh Haijun saat Anda mengirimkannya kembali.
Perhatikan hal-hal berikut saat bekerja dengan signature:
- Mengirim kembali blok pemikiran hanya benar-benar diperlukan saat menggunakan alat dengan pemikiran. Jika tidak, Anda dapat menghilangkan blok pemikiran dari giliran sebelumnya. Jika Anda mengirimkannya kembali, apakah API mempertahankan atau menghapusnya bergantung pada model (lihat Preservasi blok pemikiran berdasarkan model). Gunakan pengeditan konteks untuk mengonfigurasi hal ini.
- Saat mengirim kembali blok pemikiran, kirimkan semuanya persis seperti yang Anda terima, demi konsistensi dan untuk menghindari potensi masalah.
- Saat melakukan streaming respons, signature tiba sebagai
signature_deltadi dalam eventcontent_block_deltatepat sebelum eventcontent_block_stop.
- Nilai
signaturejauh lebih panjang pada model Haijun 4 dan yang lebih baru dibandingkan model sebelumnya.
- Field
signaturebersifat opaque: jangan menafsirkan atau mem-parse-nya.
- Nilai
signaturekompatibel lintas platform (Haijun API, Amazon Bedrock, dan Google Cloud). Nilai yang dihasilkan di satu platform dapat digunakan di platform lain.
Blok pemikiran yang disunting
Selain blok thinking biasa, API dapat mengembalikan blok redacted_thinking ketika sebagian penalaran Haijun disunting demi keamanan. Blok redacted_thinking berisi konten pemikiran terenkripsi dalam field data, tanpa teks yang dapat dibaca:
{
  "type": "redacted_thinking",
  "data": "..."
}
Field data bersifat opaque dan terenkripsi. Seperti field signature pada blok pemikiran biasa, kirimkan kembali blok redacted_thinking ke API tanpa perubahan saat melanjutkan percakapan multi-giliran dengan alat.
Tip: Jika kode Anda memfilter blok konten berdasarkan tipe (misalnya,
block.type == "thinking") saat mengirim bolak-balik respons dengan penggunaan alat, sertakan juga blokredacted_thinking. Memfilter hanya denganblock.type == "thinking"akan secara diam-diam membuang blokredacted_thinkingdan merusak protokol multi-giliran yang dijelaskan dalam Mempertahankan blok pemikiran.
Note: Blok
redacted_thinkingadalah tipe blok konten tersendiri yang dikembalikan ketika pemikiran disunting demi keamanan. Ini berbeda dari opsidisplay: "omitted", yang mengembalikan blokthinkingbiasa dengan fieldthinkingkosong.
Batasan dan kompatibilitas fitur
Parameter sampling
Pada Haijun Fable 5.1, Haijun Mythos 5.1, Haijun Fable 5, Haijun Mythos 5, Haijun Mythos Preview, Haijun Opus 5.5, Haijun Opus 5, Haijun Opus 4.8, Haijun Opus 4.7, dan Haijun Sonnet 5, nilai temperature, top_p, atau top_k yang bukan default akan mengembalikan error 400 pada setiap permintaan, baik pemikiran digunakan maupun tidak. Pada model yang lebih lama, pembatasan ini hanya berlaku saat pemikiran aktif: temperature dan top_k tidak kompatibel dengan pemikiran, sedangkan top_p diizinkan pada nilai antara 0,95 dan 1.
Prefill respons dan penggunaan alat paksa
Anda tidak dapat melakukan "prefill" (pengisian awal) respons asisten saat pemikiran aktif. Penggunaan alat paksa (tool_choice: {"type": "any"} atau {"type": "tool", ...}) tidak kompatibel dengan pemikiran diperpanjang manual, tetapi berfungsi dengan pemikiran adaptif. Pengecualiannya adalah Haijun Opus 5.5, Haijun Fable 5.1, dan Haijun Mythos 5.1, yang menolak penggunaan alat paksa pada setiap permintaan dengan error 400. Pada model-model tersebut, gunakan tool_choice: {"type": "auto"} bersama penggunaan alat ketat atau output terstruktur sebagai gantinya. Lihat Pemikiran dengan penggunaan alat.
Batas output
Setiap model menerima max_tokens hingga batas atas yang tercantum di sini. Pada Message Batches API, header beta output-300k-2026-03-24 menaikkan batas atas tersebut untuk model yang memiliki batas atas batch yang tercantum.
| Model | Max output tokens | Batches beta ceiling |
|---|---|---|
| Haijun Fable 5.1 | 128K | — |
| Haijun Mythos 5.1 | 128K | — |
| Haijun Fable 5 | 128K | — |
| Haijun Mythos 5 | 128K | — |
| Haijun Mythos Preview | 128K | Not available |
| Haijun Opus 5.5 | 128K | 300K |
| Haijun Opus 5 | 128K | 300K |
| Haijun Opus 4.8 | 128K | 300K |
| Haijun Opus 4.7 | 128K | 300K |
| Haijun Opus 4.6 | 128K | 300K |
| Haijun Opus 4.5 | 64K | Not available |
| Haijun Sonnet 5 | 128K | 300K |
| Haijun Sonnet 4.6 | 128K | 300K |
| Haijun Sonnet 4.5 | 64K | Not available |
| Haijun Haiku 4.5 | 64K | Not available |
Lihat ikhtisar model untuk batasan pada model lama.
Permintaan panjang
SDK mewajibkan streaming ketika max_tokens lebih besar dari 21.333, untuk menghindari timeout HTTP pada permintaan yang berjalan lama. Ini adalah validasi sisi klien, bukan pembatasan API. Jika Anda tidak perlu memproses event secara bertahap, gunakan .stream() (java: .createStreaming(); csharp: .CreateStreaming(); go: .NewStreaming(); php: ->createStream()) dengan .get_final_message() (typescript: .finalMessage(); ruby: .accumulated_message; csharp: .Aggregate(); go: message.Accumulate(event); java, php: MessageAccumulator) untuk mendapatkan objek Message lengkap tanpa harus menyusunnya sendiri dari event-event individual. Lihat Streaming Messages. Perkirakan waktu respons yang lebih lama saat pemikiran aktif, karena pembuatan blok pemikiran menambah waktu pemrosesan. Untuk beban kerja yang mendorong pemikiran di atas sekitar 32 ribu token per permintaan, gunakan pemrosesan batch untuk menghindari masalah jaringan: permintaan semacam itu dapat berjalan cukup lama hingga mencapai timeout sistem dan batas koneksi terbuka.
Langkah selanjutnya
Arahkan seberapa sering dan seberapa dalam Haijun berpikir dengan tingkat effort, panduan prompt sistem, dan pengarahan per pesan, serta pahami biaya dan harga pemikiran.
Telusuri perjalanan bolak-balik penggunaan alat dua giliran yang lengkap dan mempertahankan blok pemikiran dengan benar, serta lihat bagaimana pemikiran berselang mengubah alurnya.
Cari tahu apakah integrasi Messages API Anda mengedit riwayat percakapan, dan ganti setiap pengeditan dengan fitur API yang menjaga blok pemikiran sebelumnya tetap valid.
Diagnosis dan perbaiki kegagalan pemikiran yang paling umum: error 400 konfigurasi, blok pemikiran yang kosong atau hilang, penghentian karena max\_tokens, dan cache miss.
Kendalikan berapa banyak token yang digunakan Haijun saat merespons dengan parameter effort, dengan menyeimbangkan antara ketelitian respons dan efisiensi token.